
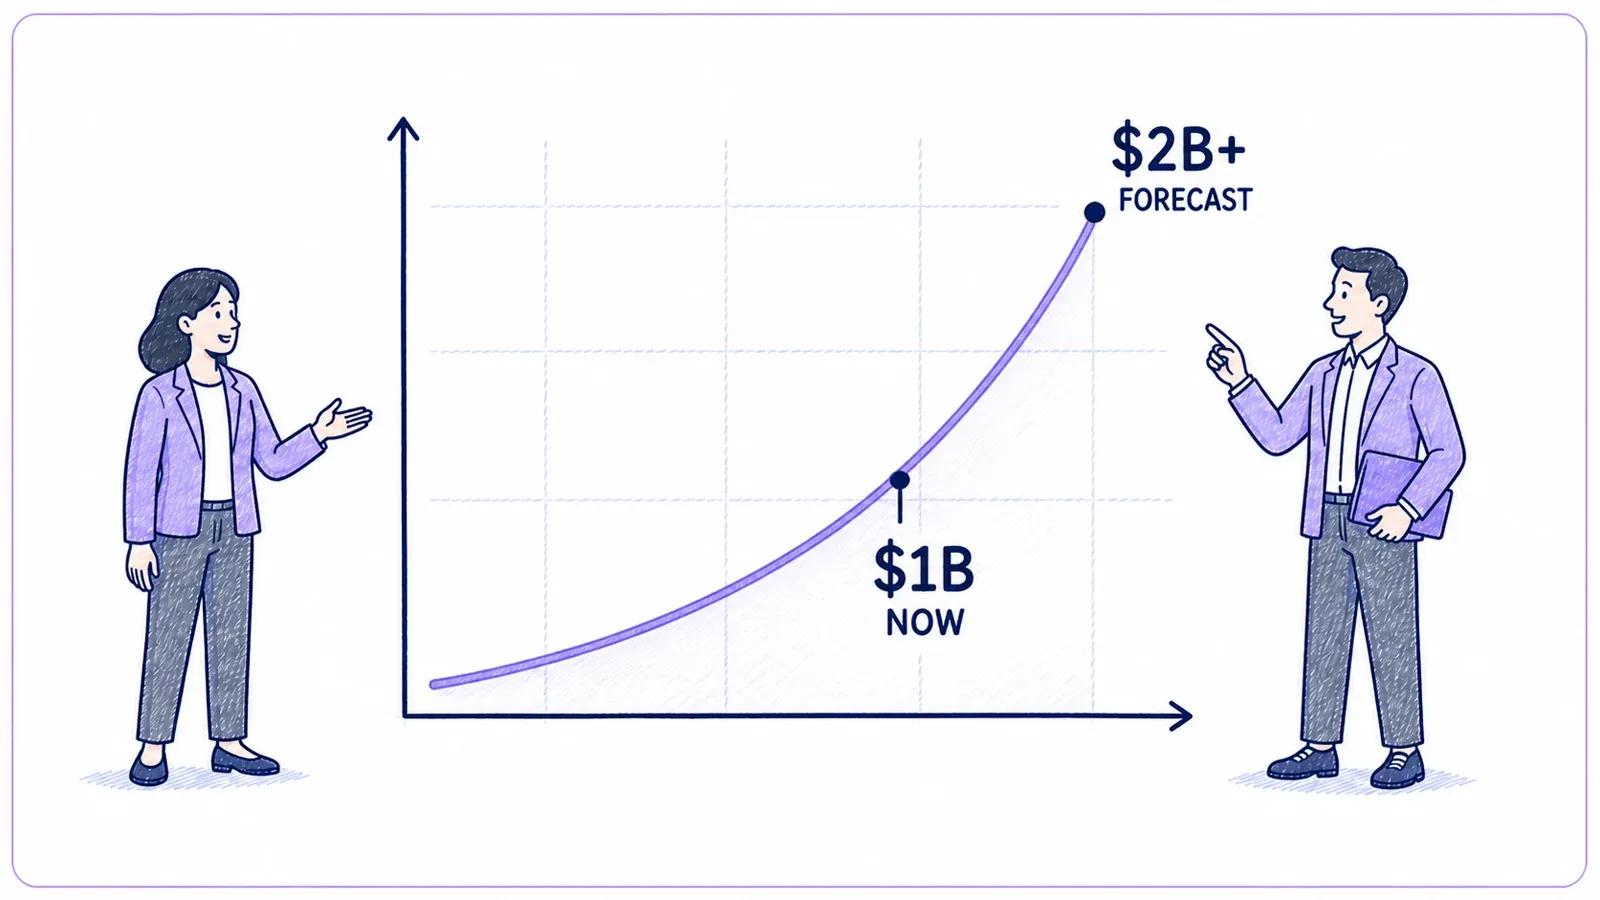
Pojďme si to říct na rovinu: v roce 2026, pokud pořád ručně kopírujete data z webů, je to jako běžet maraton v žabkách. Trh se softwarem pro web scraping v roce 2024 dosáhl 1,01 miliardy dolarů a do roku 2032 má vyrůst na 2,49 miliardy dolarů, uvádí zpráva Apify o stavu web scrapingu. Více než polovina firem v USA už sbírá externí webová data — sleduje konkurenci, hlídá ceny a vytváří seznamy leadů — protože vědí, že vyhrává ten, kdo má nejčerstvější data.
Získejte data z webu pomocí AI na jedno kliknutí Agentní webový scraper od Thunderbitu si dokáže sám přečíst data z libovolného webu a během jediného kliknutí je vytáhnout bez jakéhokoli nastavování. Get Started Free
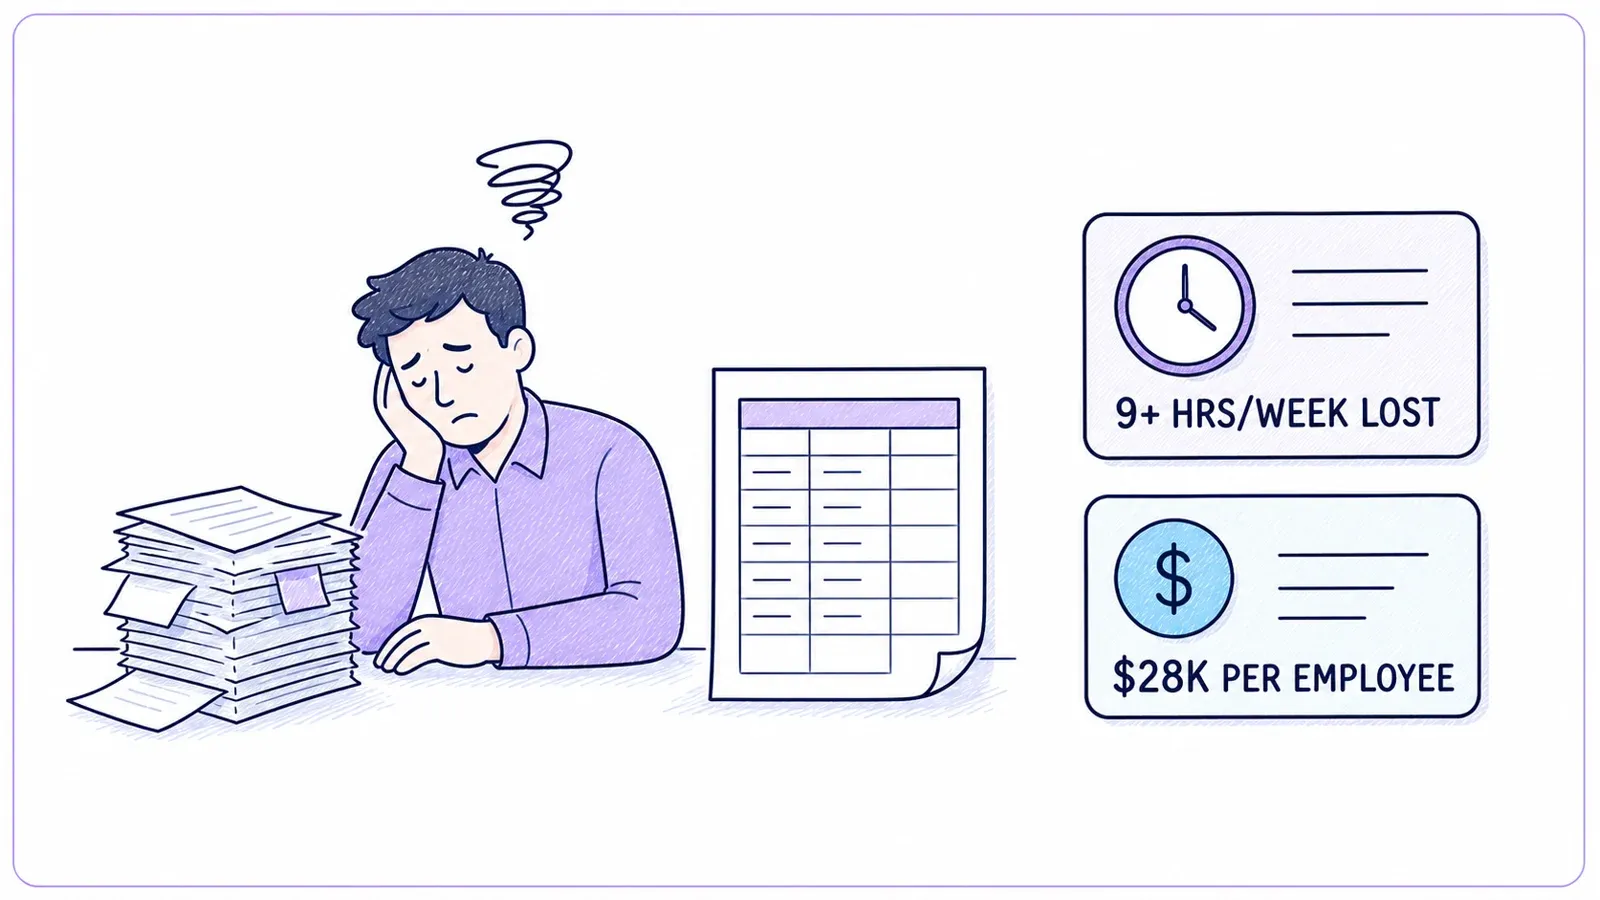
Háček je ale v tomhle: většina běžných uživatelů ve firmách nejsou programátoři. Viděl jsem obchodní týmy, marketéry i lidi z provozu, jak tráví 9+ hodin týdně opakovaným zadáváním dat, což podle průzkumu Parseur/QuestionPro z roku 2025 mezi 500 americkými profesionály stojí firmy zhruba 28 500 dolarů na zaměstnance ročně. A téměř 60 % pracovníků říká, že je tyto úkoly vyčerpávají. Dobrá zpráva? Efektivní získávání dat z webových stránek je dnes dostupné opravdu každému — i když jste nikdy nenapsali jediný řádek kódu. Pojďme si rozebrat, jak přesně na to, jaké nástroje použít a jak se dostat od „tohle data potřebuju“ k použitelnému spreadsheetu — u dobře strukturovaných webů během několika kliknutí; u těch chaotičtějších během několika kliknutí a pár úprav promptu.
Co znamená získávat data z webových stránek?
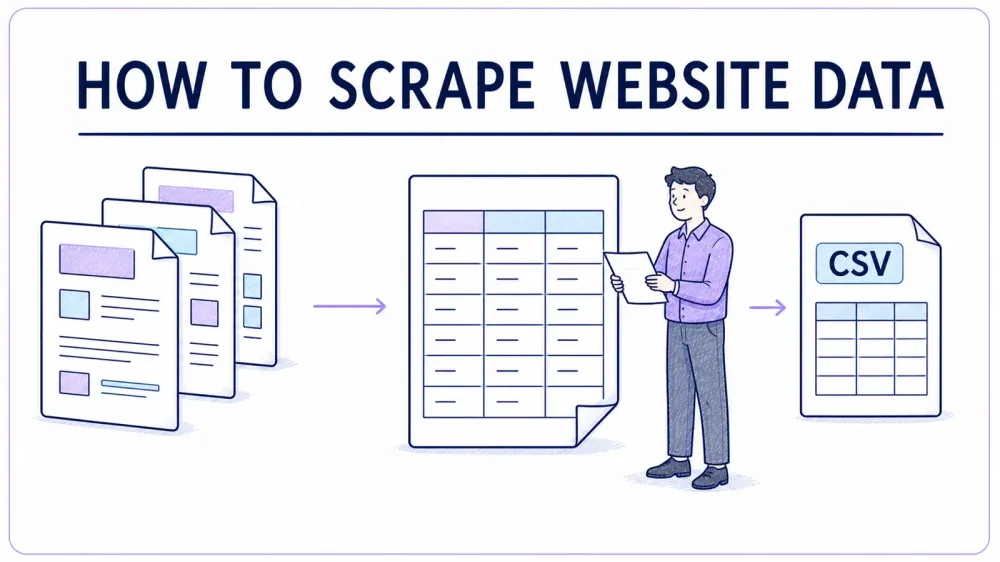
V jádru znamená získávání dat z webových stránek použití softwaru, který automaticky vytahuje informace z webových stránek a převádí je do strukturované podoby — třeba do tabulek, spreadsheetů nebo databází. Představte si digitálního asistenta, který obchází stovky stránek, posbírá informace, které potřebujete (jako jména, ceny nebo e-maily), a vše vám uloží do Excelu, zatímco vy si v klidu dáte kafe.
Ruční sběr dat — tedy kopírování a vkládání z webu — funguje jen u několika řádků. Jakmile ale potřebujete data z desítek nebo tisíců stránek, je to recept na bolavá zápěstí a spoustu překlepů. Automatizované web scraping nástroje za vás udělají těžkou práci, vytáhnou přesně ta pole, která chcete, zvládnou to ve velkém a s výrazně menším počtem chyb (ParseHub).
Základní kroky web scrapingu:
- Určete, jaká data chcete (např. ceny produktů, kontaktní údaje, recenze).
- Vytáhněte data pomocí nástroje nebo skriptu.
- Exportujte výsledky do formátu, který můžete analyzovat (CSV, Excel, Google Sheets apod.).
Moderní web scrapery si poradí i s vícestránkovými výpisy, prokliknou tlačítko „další“ a navštíví i podstránky — takže získáte všechna data, nejen to, co je vidět na jedné obrazovce.
Proč je získávání dat z webu důležité pro firemní týmy
Podívejme se, proč je tahle dovednost nepostradatelná pro obchod, marketing i provoz:
- Generování leadů: Vytvořte cílené seznamy potenciálních zákazníků z firemních adresářů, LinkedIn nebo stránek s účastníky akcí. Už žádné kupování zastaralých seznamů ani hodiny strávené na Googlu.
- Sledování cen: Hlídání cen konkurence a skladových zásob napříč marketplace platformami. Maloobchodníci jako John Lewis zvýšili tržby o 4 % díky získaným cenovým datům.
- Průzkum trhu: Sběr recenzí, hodnocení a zmínek na sociálních sítích vám pomůže v reálném čase odhalovat trendy i náladu zákazníků.
- Efektivita provozu: Udržujte produktové katalogy, údaje o dodavatelích nebo inzeráty nemovitostí automaticky aktuální.
Tady je rychlá tabulka s přehledem výhod:
| Klíčová výhoda | Co to znamená | Výsledek v praxi |
|---|---|---|
| Úspora času | Automatizace hodin ruční práce s daty | +9 hodin týdně ušetřených na zaměstnance (PRNewswire) |
| Přesnost | Méně chyb, konzistentnější data | Až 99,5% přesnost (Scrapingdog) |
| Konkurenční výhoda | Rychlejší a čerstvější přehled než u konkurence | Dynamické ceny, lepší cílení |
| Automatizace workflow | Data se aktualizují sama — žádné ruční kontroly | Denní/týdenní reporty podle plánu |
Není divu, že 63 % firem využívajících externí data říká, že se jim zlepšilo rozhodování, a více než polovině vzrostly tržby.
Krok za krokem: Jak získávat data z webových stránek bez programování
Tuhle otázku dostávám často: „Jak mám vůbec začít se scrapováním dat, když nejsem technický typ?“ Tady je jednoduchý postup pro začátečníky:
1. Určete cíl a datová pole
Rozhodněte se, co přesně chcete. Je to seznam všech restaurací ve vašem městě z Yelp, včetně názvu, adresy a telefonu? Nebo třeba ceny produktů konkurence z Amazon? Sepište si pole, která potřebujete.
2. Vyberte správný nástroj
Pokud neumíte programovat, přeskočte Python skripty. Sáhněte po no-code nástrojích jako Thunderbit, což je AI poháněné rozšíření pro Chrome, nebo po dalších vizuálních scraperech jako Octoparse či ParseHub.
Vyzkoušejte agentní web scraper Thunderbit zdarma Bezplatný plán pokrývá 6 stránek měsíčně, bez nutnosti kreditní karty — rychlý způsob, jak si otestovat extrakci na cílovém webu. Get Started Free
3. Připravte si prostředí
Nainstalujte vybraný nástroj (u Thunderbitu si stáhněte Chrome Extension). Zaregistrujte se, přihlaste a můžete začít.
4. Najděte data na webu
Otevřete cílovou stránku. S Thunderbitem stačí kliknout na „One Click Extract“ — AI projde stránku, vybere správné sloupce (například Name, Price, Email) a vytáhne je.
5. Spusťte testovací scrape
Začněte vždy v malém. Získejte data z jedné stránky nebo jen několika záznamů a ověřte, zda vypadají správně. Podle potřeby upravte sloupce nebo prompt.
6. Získejte celý dataset
Jakmile jste spokojeni, spusťte plné získávání dat. U větších úloh použijte cloud režim (více o něm za chvíli). Nástroj zvládne stránkování i podstránky, pokud je správně nastavený.
7. Exportujte a používejte data
Exportujte do Excelu, Google Sheets, Airtable nebo Notion. Zkontrolujte pár řádků, jestli je vše v pořádku.
Tip navíc: Vyhněte se častým chybám, jako je zapomenuté stránkování, příliš velký objem dat najednou nebo ignorování podmínek používání webu. Začněte úzce zaměřeně, postupně upravujte nastavení a brzy budete v scrapingu jako doma.
Jak vybrat správný nástroj: Thunderbit vs. tradiční řešení pro scraping
Porovnejme si možnosti:
| Řešení | Snadnost použití | Doba nastavení | Údržba | Škálovatelnost | Cena | Nejvhodnější pro |
|---|---|---|---|---|---|---|
| Thunderbit (AI no-code) | Velmi vysoká | Minuty | Nízká | Vysoká (cloud) | Free tier, $15+/měsíc | Obchod, provoz, neprogramátoři |
| Tradiční rozšíření | Střední | 30+ min | Střední | Omezená | Zdarma/nízká | Jednoduché úlohy, trpěliví uživatelé |
| Vlastní kód (Python) | Nízká | Hodiny+ | Vysoká | Velmi vysoká | Čas vývojáře | Vývojáři, datové týmy |
| Outsourcingové služby | Vysoká | Dny | Nízká | Vysoká | $$$ | Velké jednorázové projekty |
Thunderbit vyniká hlavně pro netechnické uživatele: žádný kód, One Click Extract a workflow, které je stejně jednoduché jako objednat si jídlo s dovážkou. Tradiční nástroje vyžadují víc ladění a vlastní kód je lepší nechat inženýrům.
Získejte libovolnou stránku jedním kliknutím Agentní web scraper od Thunderbitu si stránku přečte, pochopí její strukturu a předá vám čistou tabulku — bez selectorů. Get Started Free
Thunderbit v praxi: Získejte data z webu během pár kliknutí
Takhle bych použil Thunderbit třeba na scrapování adresáře realitních makléřů:
- Nainstalujte Chrome Extension a přihlaste se.
- Otevřete cílový web (např. adresář realitních makléřů).
- Klikněte na ikonu Thunderbitu, čímž otevřete postranní panel.
- Stiskněte „One Click Extract“. AI Thunderbitu projde stránku a navrhne sloupce jako Name, Agency, Phone, Email.
- Zkontrolujte a upravte pole — přejmenujte sloupce, případně přidejte vlastní prompt, pokud chcete data kategorizovat nebo formátovat.
- Klikněte na „Scrape“. Thunderbit vytáhne data do tabulky, zvládne stránkování i nekonečné scrollování.
- Exportujte do Excelu, Google Sheets nebo Notion — bez příplatků a skrytých poplatků.
Pokud je u každého makléře odkaz na profil, použijte Subpage Scraping: Thunderbit navštíví každý profil, vytáhne doplňující informace (například adresu nebo počet let zkušeností) a přidá je do tabulky. Už žádné otevírání záložek jednu po druhé.
Browser Scraping vs. Cloud Scraping: Který režim vám sedne?
Thunderbit nabízí dva režimy:
- Browser Scraping: Běží přímo ve vašem lokálním prohlížeči Chrome. Skvělé pro data za přihlášením nebo personalizované stránky (například váš LinkedIn účet nebo interní dashboardy). Používá vaši relaci a cookies, takže pokud to vidíte vy, Thunderbit to může vytáhnout.
- Cloud Scraping: Běží na serverech Thunderbitu. Je super rychlý pro veřejná data — zvládne až 50 stránek najednou, nezatěžuje váš počítač a běží dál i po zavření notebooku. Ideální pro velké úlohy, třeba pro získání všech produktů z e-shopu.
Kdy který použít:
- Browser Mode: Weby vyžadující přihlášení, personalizované feedy, menší úlohy.
- Cloud Mode: Veřejná data ve velkém, plánované scrapování nebo situace, kdy chcete nastavit a zapomenout.
Thunderbit navíc v obou režimech zvládá stránkování i podstránky, takže pokaždé dostanete kompletní dataset.
Dvojitá efektivita: Jak AI pomáhá upravit pole a formáty dat
Jedna z mých nejoblíbenějších funkcí Thunderbitu je „AI Improve Fields“. Tady je důvod, proč je tak užitečná:
- Automatické formátování: Standardizujte telefonní čísla, ceny nebo data už při scrapování — žádné chaotické spreadsheety.
- Kategorizace: Přidejte sloupec jako „Category“ a nechte AI označit každý řádek (např. Electronics, Clothing, Furniture) podle popisu.
- Překlad: Sbírejte data z webů v jiných jazycích a nechte Thunderbit pole přeložit do angličtiny (nebo do 34+ dalších jazyků).
- Vlastní prompty: Chcete z recenzí vytáhnout sentiment nebo označit firmy podle velikosti? Stačí do pole přidat AI prompt.
Výsledkem jsou data připravená k analýze přímo z nástroje, bez hodin ručního čištění.
Automatizujte workflow: Plánované pravidelné získávání dat z webu
Proč zůstat jen u jednorázového scrapingu? Funkce Schedule v Thunderbitu umožňuje nastavit opakované scrapování — denně, týdně nebo kdykoli chcete.
- Popište plán běžnou řečí („každé pondělí v 9:00“).
- Vyberte projekt a cílové místo exportu (Excel, Google Sheets, Airtable, Notion).
- Thunderbit spustí scrape automaticky a aktualizuje vaše data — bez ruční práce.
Příklady použití:
- Obchod: Denní aktualizace seznamu leadů.
- E-commerce: Automatické sledování cen.
- Provoz: Upozornění na zásoby nebo dostupnost.
- Průzkum trhu: Sběr zpráv nebo recenzí.
Díky plánovanému scrapingu máte data stále čerstvá a tým má nejnovější informace vždy po ruce.
Srovnání populárních nástrojů pro získávání dat z webu: Rychlý přehled
Tady je srovnání nejběžnějších možností:
| Typ nástroje | Snadnost použití | Doba nastavení | Škálovatelnost | Údržba | Cena | Nejvhodnější pro |
|---|---|---|---|---|---|---|
| Thunderbit (AI no-code) | ⭐⭐⭐⭐⭐ | Minuty | Vysoká | Nízká | Free/$15+/měsíc | Obchod, provoz, neprogramátoři |
| Tradiční rozšíření | ⭐⭐⭐ | 30+ min | Střední | Střední | Zdarma/nízká | Jednoduché úlohy, trpěliví uživatelé |
| Vlastní kód (Python) | ⭐ | Hodiny+ | Velmi vysoká | Vysoká | Čas vývojáře | Vývojáři, datové týmy |
| Outsourcingové služby | ⭐⭐⭐⭐ | Dny | Vysoká | Nízká | $$$ | Velké jednorázové projekty |
Pro většinu firemních uživatelů je Thunderbit jasným vítězem z hlediska rychlosti, jednoduchosti i ceny.
Hlavní závěry: Jak efektivně získávat data z webových stránek
- Web scraping je dnes dostupný každému. Není potřeba programovat — stačí zvolit správný nástroj a dodržet pár jednoduchých kroků.
- Než začnete, definujte si cíle a pole. Vědět, jaká data potřebujete a kde je najdete, vám ušetří čas.
- Používejte AI nástroje jako Thunderbit pro nejsnazší a nejrychlejší výsledky — hlavně pokud nejste techničtí.
- Automatizujte opakující se úkoly pomocí plánování, aby se data aktualizovala sama.
- Upravujte a formátujte data už při scrapingu pomocí AI promptů — získáte výsledky připravené k analýze hned.
Chcete to vyzkoušet? Stáhněte si Chrome Extension Thunderbitu a spusťte první scrape zdarma. Nebo se podívejte na Thunderbit Blog pro další návody a praktické příklady.
Podívejte se, jak si Thunderbit vede ve srovnání Zjistěte, jak si jedním kliknutím řízená AI extrakce v Thunderbitu stojí oproti ostatním nástrojům z tohoto průvodce. Get Started Free
Často kladené otázky
1. Je web scraping legální a bezpečný pro firemní použití?
Ano, pokud získáváte veřejně dostupná data a respektujete podmínky použití webu. Nescrapujte osobní ani citlivé údaje bez povolení a vždy si ověřte zásady dané stránky.
2. Jaká data mohu pomocí Thunderbitu získat?
Můžete vytahovat text, čísla, data, URL, e-maily, telefonní čísla, obrázky a další. AI v Thunderbitu dokáže pole během scrapingu i kategorizovat, označovat a překládat.
3. Můžu získávat data i ze stránek, které vyžadují přihlášení?
Rozhodně — použijte Browser Mode Thunderbitu a získejte data z libovolné stránky, kterou máte otevřenou v prohlížeči, včetně obsahu za přihlášením.
4. Jak si Thunderbit poradí s weby s mnoha stránkami nebo podstránkami?
Thunderbit podporuje automatické stránkování i scraping podstránek. Umí procházet tlačítko „další“ a navštěvovat detailní stránky, přičemž všechna data spojí do jedné tabulky.
5. Mohu scrapování naplánovat tak, aby běželo automaticky?
Ano! Funkce Schedule v Thunderbitu vám umožní nastavit opakované scrapování (denně, týdně atd.) a výsledky exportovat přímo do Excelu, Google Sheets, Airtable nebo Notion.
Vyzkoušejte agentní web scraper Thunderbit zdarma Get Started Free
Získávání dat z webových stránek nemusí být žádná noční můra. Se správnými nástroji a jasným plánem můžete proměnit web ve svou osobní databázi — bez kódu, bez stresu, jen s výsledky. Hodně štěstí se scrapováním!



