
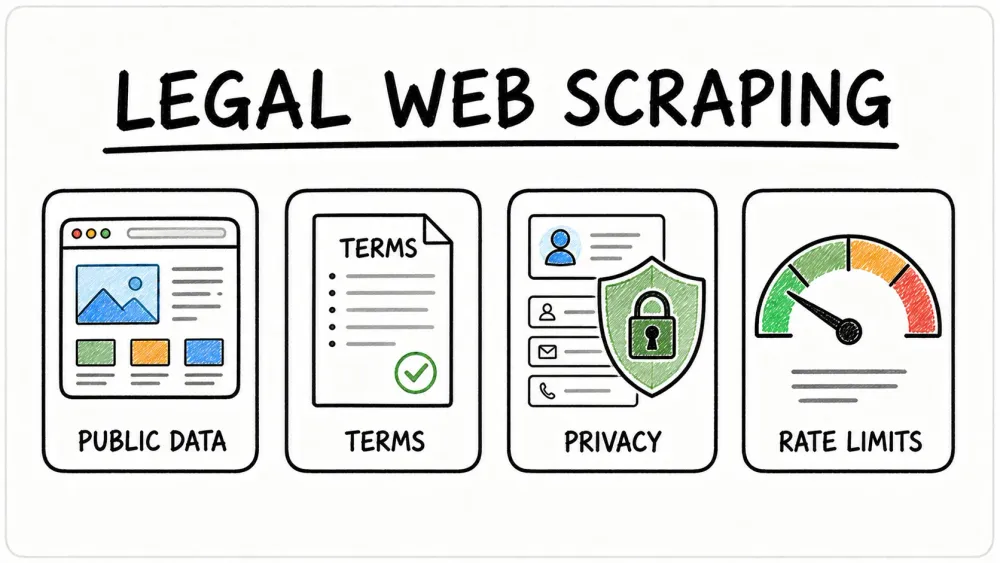
„Je legální scrapovat data z webových stránek?“ — to je ta otázka za milion, kterou od sales, ops a marketingových týmů slyším skoro každý týden. Web scraping dnes pohání všechno od generování leadů až po konkurenční analýzu, takže není divu, že chce každý jasnou odpověď. Jenže realita? Právní prostředí je přehledné asi jako hrnek den staré kávy. Stačí mrknout na titulky: jeden soud řekne, že veřejná data lze scrapovat, jiný varuje před „nezákonným sběrem dat“. Není divu, že je tolik týmů nervózních z toho, aby nepřekročily hranici.
A teď k faktům: víc než dvě třetiny organizací dnes používají web scraping pro analytiku a AI projekty a obrovských 78 % e-commerce firem na něm staví cenovou inteligenci. Jenže s mediálně sledovanými žalobami typu LinkedIn vs. hiQ Labs jsou sázky vyšší než kdy dřív. Jak tedy vytěžit hodnotu z webových dat — a přitom neskončit v právních průšvizích? Pojďme si rozebrat právní rámce, kontrolu souladu s předpisy i osvědčené postupy, které by měl znát každý byznysový uživatel. A ano, ukážu vám i to, jak Thunderbit dělá compliant scraping mnohem jednodušší.
Pochopení právního prostředí: Je legální scrapovat data z webových stránek?
Vyzkoušejte Thunderbit – web scraper s důrazem na compliance Agentní web scraper Thunderbit si sám přečte veřejné stránky a data vytáhne na jeden klik, s ohledem na týmy, které berou compliance vážně. Get Started Free
Pojďme rovnou na věc: legálnost web scrapingu závisí na tom, co scrapujete, jak to scrapujete a kde se nacházíte. Neexistuje jeden univerzální zákon, který by jednoduše řekl „scraping je legální“ nebo „scraping je nelegální“. Místo toho se musíte orientovat v mixu pravidel — od zákonů proti hackingu přes předpisy o ochraně soukromí až po autorské právo a dokonce i podmínky používání webu (Thunderbit Blog).
Tady jsou hlavní faktory, které rozhodují o tom, jestli je váš scrapingový projekt na správné straně zákona:
- Veřejná vs. soukromá data: Scrapování dat volně dostupných všem (bez přihlášení a bez paywallu) je obecně bezpečnější. Pokud se snažíte dostat k obsahu za přihlášením, pravděpodobně už jdete po hodně tenkém ledě.
- Typ dat: Osobní údaje (jména, e-maily, profily na sociálních sítích) a chráněný obsah (články, obrázky) jsou mnohem rizikovější než faktické informace (ceny, specifikace produktů, firemní záznamy).
- Účel použití: Interní využití scrapovaných dat (analýza, výzkum) je výrazně méně rizikové než jejich další publikování nebo prodej.
- Soulad s pravidly webu: Porušení podmínek používání nebo ignorování souboru robots.txt vás může dostat do potíží — i když jsou data veřejná.
- Technický postup: Scrapování lidským tempem a bez obcházení bezpečnostních opatření (např. CAPTCHA nebo blokace IP) vás drží na bezpečnější straně.
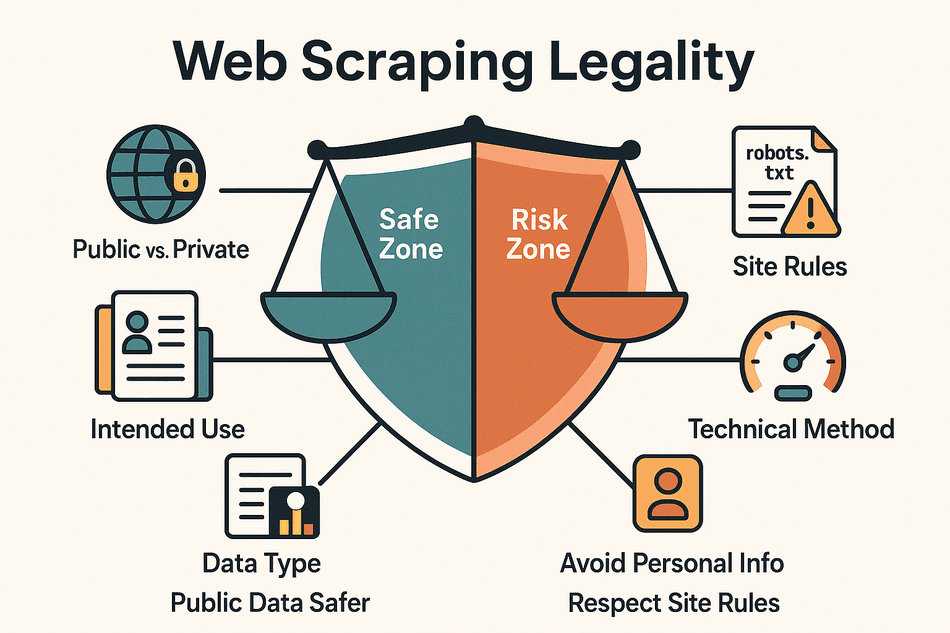
 Shrnutí? Scrapování veřejných, neosobních dat pro interní použití je v mnoha regionech obecně přijímané, ale existují zásadní výjimky — hlavně v oblastech soukromí, autorského práva a míry agresivity scrapování (Thunderbit Blog).
Právní rámec scrapování dat: Přehled hlavních globálních regulací
 Pojďme si v rychlosti projít hlavní právní rámce pro web scraping ve světě:
Spojené státy: CFAA, autorské právo a smluvní podmínky
- Computer Fraud and Abuse Act (CFAA): Tento zákon proti hackingu zakazuje přístup k počítačovým systémům „bez oprávnění“. Soudy ale upřesnily, že scrapování veřejných webů CFAA neporušuje, protože tady žádné „oprávnění“ potřeba není (California Lawyers Association).
- Zásadní případ: Ve věci hiQ Labs v. LinkedIn devátý okruh rozhodl, že scrapování veřejných profilů na LinkedIn neporušilo CFAA. LinkedIn se ale pořád mohl domáhat náhrady z porušení smlouvy (např. podmínek služby) nebo z porušení autorských práv.
- Další rizika: Pokud scrapujete příliš agresivně — například bot ve věci eBay v. Bidder’s Edge posílal 100 000 požadavků denně — můžete nést odpovědnost za „trespass to chattels“, tedy zásah do cizího majetku nebo technické infrastruktury (Wikipedia).
Evropská unie: GDPR a práva k databázím
- GDPR: Obecné nařízení EU o ochraně osobních údajů se vztahuje i na veřejně dostupné osobní údaje. Pokud scrapujete cokoli, co může identifikovat konkrétní osobu, potřebujete právní základ (např. souhlas nebo oprávněný zájem) a musíte dodržet přísná pravidla ochrany soukromí.
- Směrnice o databázích: EU chrání i databáze jako celek. Scrapování „podstatné části“ strukturované databáze (např. všech záznamů z realitního portálu) může porušit práva k databázi — i když jednotlivá fakta nejsou chráněna autorským právem (Thunderbit Blog).
Spojené království: UK GDPR a Data Protection Act
- UK GDPR: Po brexitu jsou britská pravidla hodně podobná těm evropským. Scrapování veřejných, neosobních dat je obecně v pohodě, ale osobní údaje jsou přísně regulované.
- Computer Misuse Act: Podobně jako CFAA může i tento zákon klasifikovat neoprávněný přístup jako trestný čin.
Čína: PIPL a zákon o bezpečnosti dat
- Personal Information Protection Law (PIPL): Pro sběr osobních údajů vyžaduje souhlas. Scrapování čínských webů kvůli osobním údajům bez povolení je velké ne.
- Data Security Law: Používá se k postihu scrapingu, který poškozuje vlastníky dat nebo vytváří nekalou konkurenci.
Další regiony
- Kanada, Austrálie, APAC: Většina má zákony proti hackingu a pravidla ochrany soukromí podobná EU a UK. Před scrapováním si vždy ověřte místní legislativu.
Klíčový závěr: Nejbezpečnější volba je scrapovat veřejná, neosobní data pro interní použití a vždy si ověřit pravidla ve své jurisdikci (Thunderbit Blog).
Kontrolní seznam souladu: Jak zajistit, aby byl váš data scraping legální?
Než začnete scrapovat, projděte si tenhle compliance checklist:
- Přečtěte si podmínky používání webu: Pokud ToS říká „no scraping“, zvažte zastavení nebo si nejdřív vyžádejte povolení (Thunderbit Blog).
- Držte se veřejných dat: Nescrapujte nic za přihlášením nebo paywallem, pokud k tomu nemáte výslovné oprávnění.
- Zkontrolujte robots.txt: Otevřete
site.com/robots.txta zjistěte, jestli jsou boti z určitých sekcí zakázáni. Není to sice právně závazné, ale je slušné to respektovat. - Vyhněte se osobním údajům: Nescrapujte jména, e-maily ani jiné PII, pokud nemáte právní základ a plán ochrany soukromí.
- Nekopírujte kreativní obsah: Zůstaňte u faktů a dat. Zveřejňování článků, obrázků nebo velkých částí obsahu může vyvolat nároky z autorského práva.
- Používejte oficiální API, pokud existuje: Pokud web nabízí API, použijte ho — je bezpečnější a často i stabilnější.
- Scrapujte ohleduplně: Nepřetěžujte servery. Scrapujte lidským tempem a vyhněte se obcházení technické ochrany.
- Dokumentujte svůj postup: Veďte záznamy o tom, co jste scrapovali, kdy a proč. Pomůže to, pokud později vzniknou otázky.
- Buďte připraveni přestat: Pokud dostanete výzvu k ukončení, scrapování okamžitě zastavte a situaci přehodnoťte.
Thunderbit a compliant scraping: Bezpečnější a spolehlivější získávání dat
Když jsme budovali Thunderbit, compliance bylo od začátku klíčové. Tady je, jak Thunderbit pomáhá držet se na správné straně zákona:
- Scraping v prohlížeči: Thunderbit scrapuje jen to, co skutečně vidíte v prohlížeči — žádné skryté API volání, žádné hackování přihlášení. Co nevidíte, to Thunderbit nescrapuje (Thunderbit Blog).
- Vestavěná upozornění: Pokud se pokusíte scrapovat web se striktními anti-scraping pravidly, Thunderbit zobrazí varování. Je to jako mít compliance experta přímo za zády.
- Extrahování na jeden klik: AI od Thunderbit projde stránku a doporučí jen relevantní pole — takže omylem nescrapujete citlivá nebo zbytečná data (Thunderbit Blog).
- Lidské tempo: Ať už scrapujete lokálně nebo v cloudu, Thunderbit se drží tempa, které servery zbytečně nezatěžuje.
- Na našich serverech se data neukládají: Vaše scrapovaná data míří přímo k vám — Thunderbit si neuchovává kopii, což je super z hlediska ochrany soukromí.
- Exporty vhodné pro compliance: Exportujte data přímo do Google Sheets, Excelu, Airtable nebo Notion — ideální pro interní použití.
- Práce se substránkami a stránkováním: Thunderbit prochází web jako skutečný uživatel, kliká přes stránky a podstránky bez hrubé síly na endpointy.
- Plánované scrapování s rozumem: Nastavte plánované běhy v rozumných intervalech, abyste web nezahltili každou minutu.
- Vícejazyčná podpora: Rozhraní Thunderbit je nyní v 55 jazycích v Chrome Web Store, takže compliance upozornění a nápovědy k polím zůstávají čitelné i pro neanglické týmy (Chrome Web Store listing).
Stručně řečeno, Thunderbit „zabudovává compliance přímo do produktu“, takže vás vede ke zodpovědnému scrapování — i když nejste právník (Thunderbit Blog).
Vyzkoušejte Thunderbit pro compliant web scraping Nainstalujte bezplatné rozšíření Thunderbit pro Chrome a extrahujte data z jakékoli veřejné stránky na jeden klik. Get Started Free
Scrapování dat vs. opětovné použití dat: Kde jsou právní hranice?
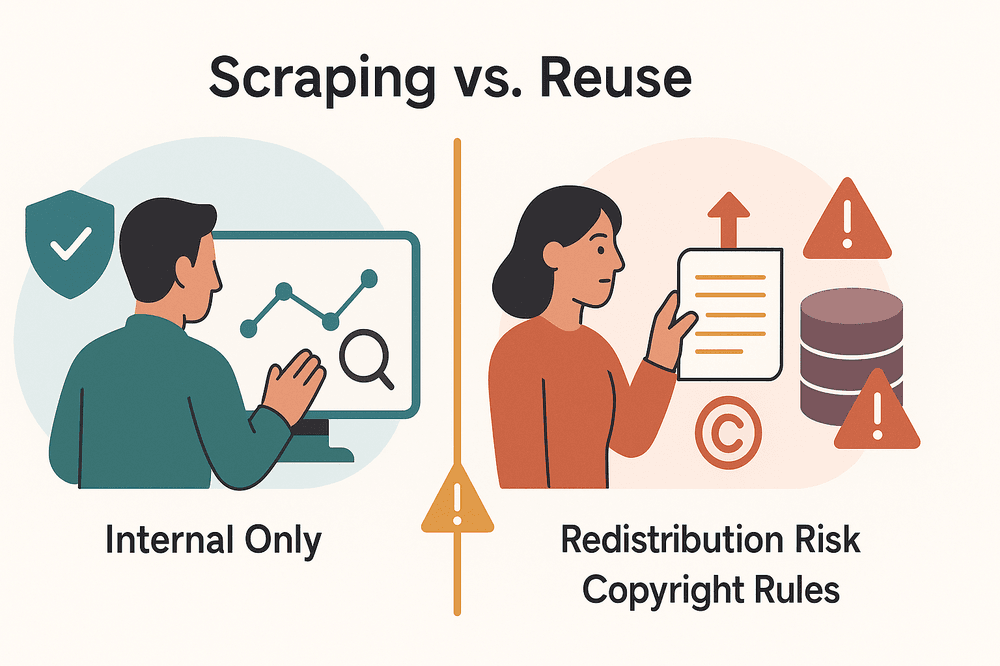 Je rozdíl mezi tím scrapovat data pro vlastní interní použití a tím data znovu publikovat, prodávat nebo jinak znovu využívat. Tady už je právní hranice mnohem ostřejší:
- Interní použití: Scrapování veřejných dat pro interní analýzu (například obchodní příležitosti nebo sledování cen) je obecně bezpečné — za předpokladu, že nejde o osobní údaje ani o porušení zákonů o ochraně soukromí.
- Redistribuce nebo prodej: Znovuzveřejnění scrapovaných dat (na vašem webu, v produktu nebo jejich prodej) může vyvolat nároky z autorského práva, práv k databázím nebo porušení smlouvy.
- Autorské právo a práva k databázím: V USA fakta nejsou chráněna autorským právem, ale chráněná může být výběrová skladba nebo uspořádání dat. V EU/UK může scrapování „podstatné části“ databáze porušit sui generis práva k databázím.
- Fair use: Americké právo v některých případech připouští „fair use“ (například pro komentář nebo analýzu), ale pouhé kopírování a vkládání velkých částí obsahu tím téměř nikdy není.
- Uvádění zdrojů: Pokud používáte scrapovaná data veřejně, vždy citujte zdroje — ale pamatujte, že citace sama o sobě nedělá použití legálním, pokud porušujete jiná práva.
- Neprodávejte surová data: Prodej neupravených scrapovaných datasetů je obzvlášť rizikový. Používejte scrapovaná data k získávání insightů, ne jako samostatný produkt.
Tip: Scrapovaná data využívejte pro interní inteligenci a rozhodování. Pokud je potřebujete sdílet navenek, agregujte je nebo transformujte a vždy si ověřte, jestli k tomu nepotřebujete souhlas (Thunderbit Blog).
Případové studie z praxe: Jak snížit právní rizika
Podívejme se na několik reálných případů — protože nic nenaučí compliance líp než to, když vidíte, co se pokazilo jinde:
LinkedIn vs. hiQ Labs
- Co se stalo: hiQ Labs scrapoval veřejné profily na LinkedIn, aby vytvořil analytiku o fluktuaci zaměstnanců. LinkedIn se je pokusil zablokovat, ale soud rozhodl, že scrapování veřejných dat neporušilo CFAA.
- Poučení: Scrapování veřejných dat je v USA právně obhajitelné, ale pořád si musíte hlídat podmínky používání a nároky na ochranu soukromí (California Lawyers Association).
eBay vs. Bidder’s Edge
- Co se stalo: Bidder’s Edge agresivně scrapoval aukční nabídky eBay (100 000 požadavků denně), porušil podmínky i robots.txt. Soud vydal zákaz pro „trespass to chattels“.
- Poučení: I scrapování veřejných dat může být nezákonné, pokud je příliš agresivní nebo porušuje výslovná pravidla webu (Wikipedia).
Facebook (Meta) vs. Power Ventures
- Co se stalo: Power Ventures scrapoval data z Facebooku se souhlasem uživatelů, ale jakmile Facebook přístup zrušil a zablokoval jejich IP adresy, Power Ventures pokračoval. Soud rozhodl, že šlo o „neoprávněný přístup“.
- Poučení: Jakmile vám vlastník webu řekne, abyste přestali, musíte okamžitě přestat — jinak riskujete porušení zákonů proti hackingu.
Příklady úspěšného souladu s pravidly
Mnoho srovnávačů cen v EU funguje legálně tím, že scrapuje jen faktická data, respektuje opt-outy a nescrapuje celé databáze. To, že proti nim nejsou žaloby, ukazuje, že držet se veřejných, neosobních dat a respektovat pravidla webu opravdu funguje.
Jak pomáhá Thunderbit
Vestavěná upozornění, limity rychlosti a přístup založený na prohlížeči by v mnoha z těchto případů pomohly předejít právním přešlapům — upozornily by uživatele na rizikové weby a ve výchozím nastavení by vynucovaly ohleduplné scrapování.
Sebekontrolní checklist pro data scraping v business scénářích
Tady je praktický checklist pro váš příští scrapingový projekt:
- Jsou data veřejná? (Bez nutnosti přihlášení)
- Co říkají podmínky webu? (Jsou tam anti-scraping klauzule?)
- Zkontrolovali jste robots.txt? (Je cílová sekce zakázaná?)
- Scrapujete osobní údaje? (Pokud ano, máte plán na ochranu soukromí?)
- Scrapujete velkou část webu? (Vyhněte se scrapování celé databáze)
- Jaký je váš účel? (Interní použití = bezpečnější; veřejné znovupoužití = vyšší riziko)
- Scrapujete ohleduplně? (Lidské tempo, žádné technické obcházení)
- Zkontrolovali jste, jestli existuje API? (Pokud ano, použijte ho)
- Jste připraveni přestat, když vás o to někdo požádá? (Mějte plán pro cease-and-desist)
- Jak budete data ukládat a zabezpečovat? (Omezte přístup, chraňte soukromí)
- Dokumentujete svůj postup? (Veďte záznamy pro účely compliance)
Pokud na něco odpovíte „ne“ nebo si nejste jistí, na chvíli se zastavte a před dalším postupem si vše ujasněte (Thunderbit Blog).
Ukázkový workflow compliant scrapování dat pro uživatele Thunderbit
 Pojďme si projít typický, na compliance ohleduplný workflow v Thunderbit:
- Kontrola před scrapováním: Projděte robots.txt a podmínky používání webu. Žádný anti-scraping jazyk? Zelená.
- Otevřete Thunderbit: Přejděte na cílovou stránku a spusťte Thunderbit Chrome Extension.
- One Click Extract: Nechte AI od Thunderbit doporučit relevantní, necitlivá pole. Zkontrolujte, že neobsahují osobní údaje, pokud k nim nemáte právní základ.
- Upravte pole: Podle potřeby nastavte sloupce a datové typy — sbírejte jen to, co skutečně potřebujete.
- Scraping: Klikněte na „Scrape“. Thunderbit vytáhne data lidským tempem a s respektem ke struktuře webu.
- Scraping podstránek: Pokud je třeba, použijte funkci subpage pro obohacení dat — opět jen pro veřejné informace.
- Export: Pošlete data přímo do Google Sheets, Excelu, Airtable nebo Notion pro interní analýzu.
- Plánování (volitelné): Nastavte plánované scrapování v rozumných intervalech — nikdy ne příliš často.
- Dokumentace: Veďte záznam o tom, co jste scrapovali, kdy a proč.
Rozhraní Thunderbit vás v každém kroku upozorní, pokud se objeví otázky compliance — takže nikdy nejdete naslepo.
Zjistěte více o compliance funkcích Thunderbit Bezplatný plán pokrývá 6 stránek měsíčně, bez nutnosti platební karty — nízkorizikový způsob, jak si vyzkoušet extrakci z veřejných stránek. Get Started Free
Závěr a klíčová doporučení: Jak bezpečně a v souladu s předpisy využívat hodnotu dat
Web scraping je silný nástroj pro růst byznysu — ale není to bezbřehá hra bez pravidel. Právní prostředí je složité, ale základní principy jsou jasné:
- Scrapujte veřejná, neosobní data pro interní použití, kdykoli je to možné.
- Před začátkem si vždy ověřte podmínky webu, robots.txt a relevantní zákony.
- Vyhněte se scrapování osobních údajů nebo kreativního obsahu, pokud nemáte právní základ a plán ochrany soukromí.
- Používejte nástroje přátelské k compliance, jako je Thunderbit, které vás povedou a sníží riziko.
- Dokumentujte postup a buďte připraveni kdykoli přestat.
Když si compliance osvojíte jako návyk, můžete naplno využít hodnotu webových dat — bez právních starostí. A pokud chcete vidět, jak snadné může být compliant scrapování, vyzkoušejte Thunderbit. Váš právní tým i vaše budoucí já vám poděkují.
Další podrobné články o web scrapingu, compliance a automatizaci najdete na Thunderbit Blogu.
Vyzkoušejte agentní web scraper pro compliant extrakci dat Get Started Free
Často kladené otázky
1. Je legální scrapovat data z jakéhokoli webu?
Ne vždy. Scrapování veřejných, neosobních dat pro interní použití je v mnoha regionech obecně legální, ale scrapování osobních údajů, chráněného obsahu nebo dat za přihlášením může být rizikové nebo přímo nelegální. Před scrapováním si vždy ověřte podmínky webu a místní zákony (Thunderbit Blog).
2. Jaký je rozdíl mezi scrapováním a znovupoužitím dat?
Scrapování je samotný sběr dat; znovupoužití znamená jejich publikování, prodej nebo jiné šíření. Interní použití je mnohem bezpečnější. Znovuzveřejnění nebo prodej scrapovaných dat může vyvolat nároky z autorského práva, práv k databázím nebo porušení smlouvy (Thunderbit Blog).
3. Jak Thunderbit pomáhá zajistit compliance?
Thunderbit scrapuje jen to, co je vidět v prohlížeči, varuje před rizikovými weby, doporučuje relevantní (necitlivá) pole a reguluje tempo požadavků, aby servery nepřetěžoval. Navíc neukládá vaše data a možnosti exportu jsou navržené pro interní použití (Thunderbit Blog).
4. Co mám dělat, když dostanu výzvu k ukončení činnosti?
Okamžitě přestaňte scrapovat a projekt přehodnoťte. Pokračování po přímé žádosti o zastavení může změnit právně nejasnou situaci v jasné porušení zákonů proti hackingu nebo smluvních podmínek (Thunderbit Blog).
5. Můžu scrapovat osobní údaje, když jsou veřejné?
Ne bez právního základu. Zákony o ochraně soukromí jako GDPR a CCPA se vztahují i na veřejně dostupné osobní údaje. Budete potřebovat souhlas nebo silný oprávněný zájem a musíte s daty zacházet zodpovědně (Thunderbit Blog).
Tento průvodce slouží pouze pro informační účely a nepředstavuje právní poradenství. U složitých nebo vysoce rizikových projektů se obraťte na kvalifikovaného právníka, který se vyzná v právu ochrany dat a soukromí ve vaší jurisdikci.
Přečtěte si také




