
Potřeboval jsem sledovat víc než 200 zpravodajských zdrojů a hlídat trendové články. Ručně? To je práce na plný úvazek. Klasický scraper? Ten se rozbil pokaždé, když web změnil rozložení.
Pak jsem vyzkoušel AI scrapery na články. Jedno kliknutí, čistá data, žádné CSS selektory. Ten rozdíl byl obrovský.
Jestli jsi novinář, SEO specialista nebo výzkumník a potřebuješ stahovat články ve větším měřítku, tohle srovnání ti ušetří spoustu pokusů a omylů. Otestoval jsem jak tradiční no-code scrapery, tak i ty poháněné AI — tady je, co opravdu funguje.
Získejte data z jakéhokoli webu pomocí AI Get Started Free
Stručně řečeno
| Výhody | Nevýhody | Nejvhodnější pro | |
|---|---|---|---|
| AI scraper na články | - Dokáže přesně vytáhnout data z více webů - Automaticky odstraňuje šum - Přizpůsobuje se změnám struktury webu - Podporuje dynamicky načítaný obsah - Nízké náklady na čištění dat | - Vyšší výpočetní nároky - Delší doba zpracování - U některých stránek může být nutný ruční zásah - Může spouštět anti-scraping ochrany | - Sběr dat z komplexních nebo dynamických webů (např. zpravodajské portály, sociální sítě) - Velkoobjemový sběr dat |
| Tradiční no-code scraper na články | - Rychlé zpracování - Nižší náklady - Nízké nároky na server i lokální zdroje - Vysoká kontrola nad procesem | - Častá údržba kvůli změnám struktury webu - Nedokáže současně scrapovat více webů - Nezvládá dynamický obsah - Vysoké náklady na čištění dat | - Rychlé, velkoobjemové scrapování jednoduchých statických stránek - Omezené výpočetní zdroje a rozpočet |
Co je scraper na články? Proč je AI scraper na články důležitý?
Scraper na články je typ web scrapera, který umí najít a stáhnout informace jako titulky, autory, datum vydání, obsah, klíčová slova, obrázky nebo videa z novinových webů a převést je do strukturovaných formátů, jako jsou JSON, CSV nebo Excel.
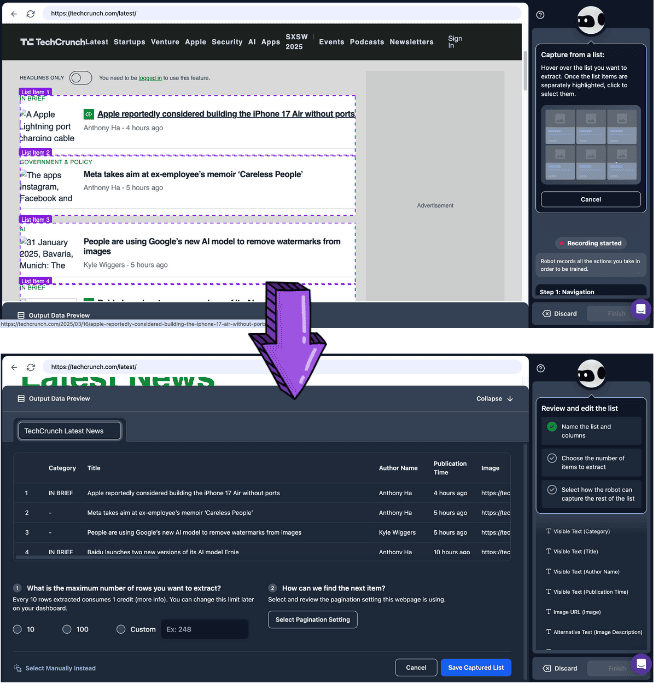
Tradiční no-code scrapery na články spoléhají na CSS selektory, které extrahují obsah podle HTML struktury stránky. Tenhle přístup ale má svoje limity:
- Nízká univerzálnost: Každá webová struktura vyžaduje vlastní CSS selektory a jakákoli změna layoutu může funkčnost rozbít, takže je potřeba častá údržba.
- Neschopnost pracovat s dynamickým obsahem: Mnoho webů načítá obsah přes AJAX nebo JavaScript, což CSS selektory samy o sobě neumí přímo vytáhnout.
- Omezené zpracování dat: CSS selektory získají jen úryvky HTML bez dalšího čištění dat, formátování, sémantické analýzy nebo analýzy sentimentu.
 Přichází AI scraper na články.
-
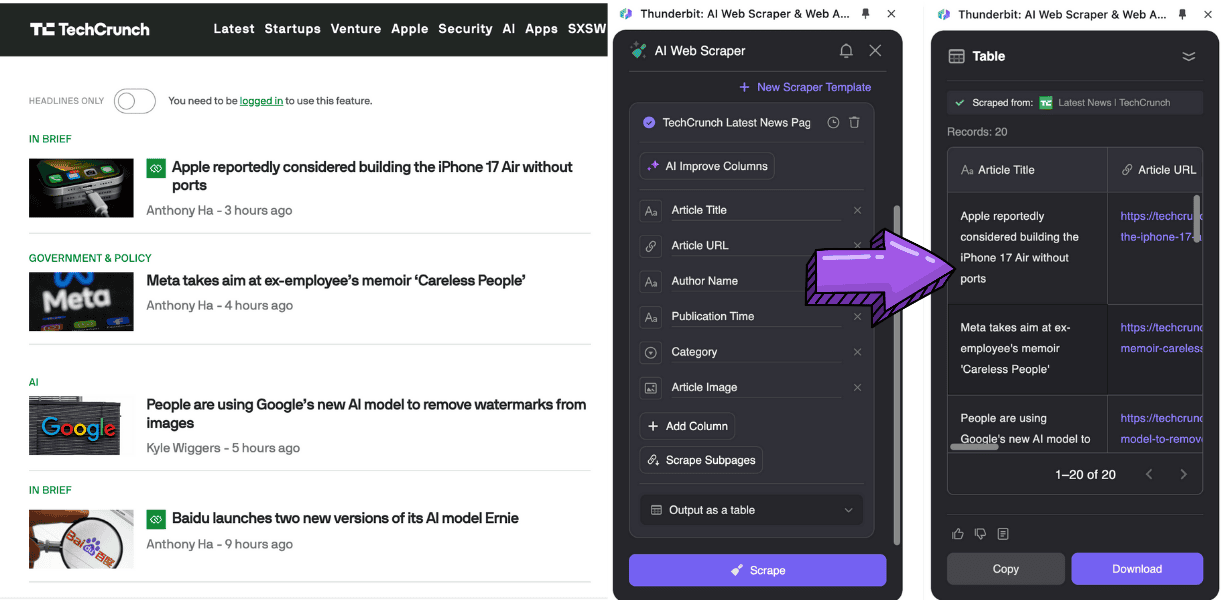
Tahle technologie používá LLM k pochopení webových stránek a nabízí:
- Inteligentní rozpoznávání: Umí identifikovat titulky, autory, souhrny i hlavní obsah.
- Automatické odstranění šumu: Rozliší hlavní obsah od navigace, reklam a souvisejících článků, čímž zlepší kvalitu dat i efektivitu scrapování.
- Přizpůsobení změnám na webu: I když se struktura nebo styl webu změní, AI může pokračovat v extrakci díky sémantickému porozumění a vizuálním znakům.
- Přenositelnost napříč weby: Na rozdíl od tradičních scraperů lze AI scrapery používat na různých webech bez ručních úprav.
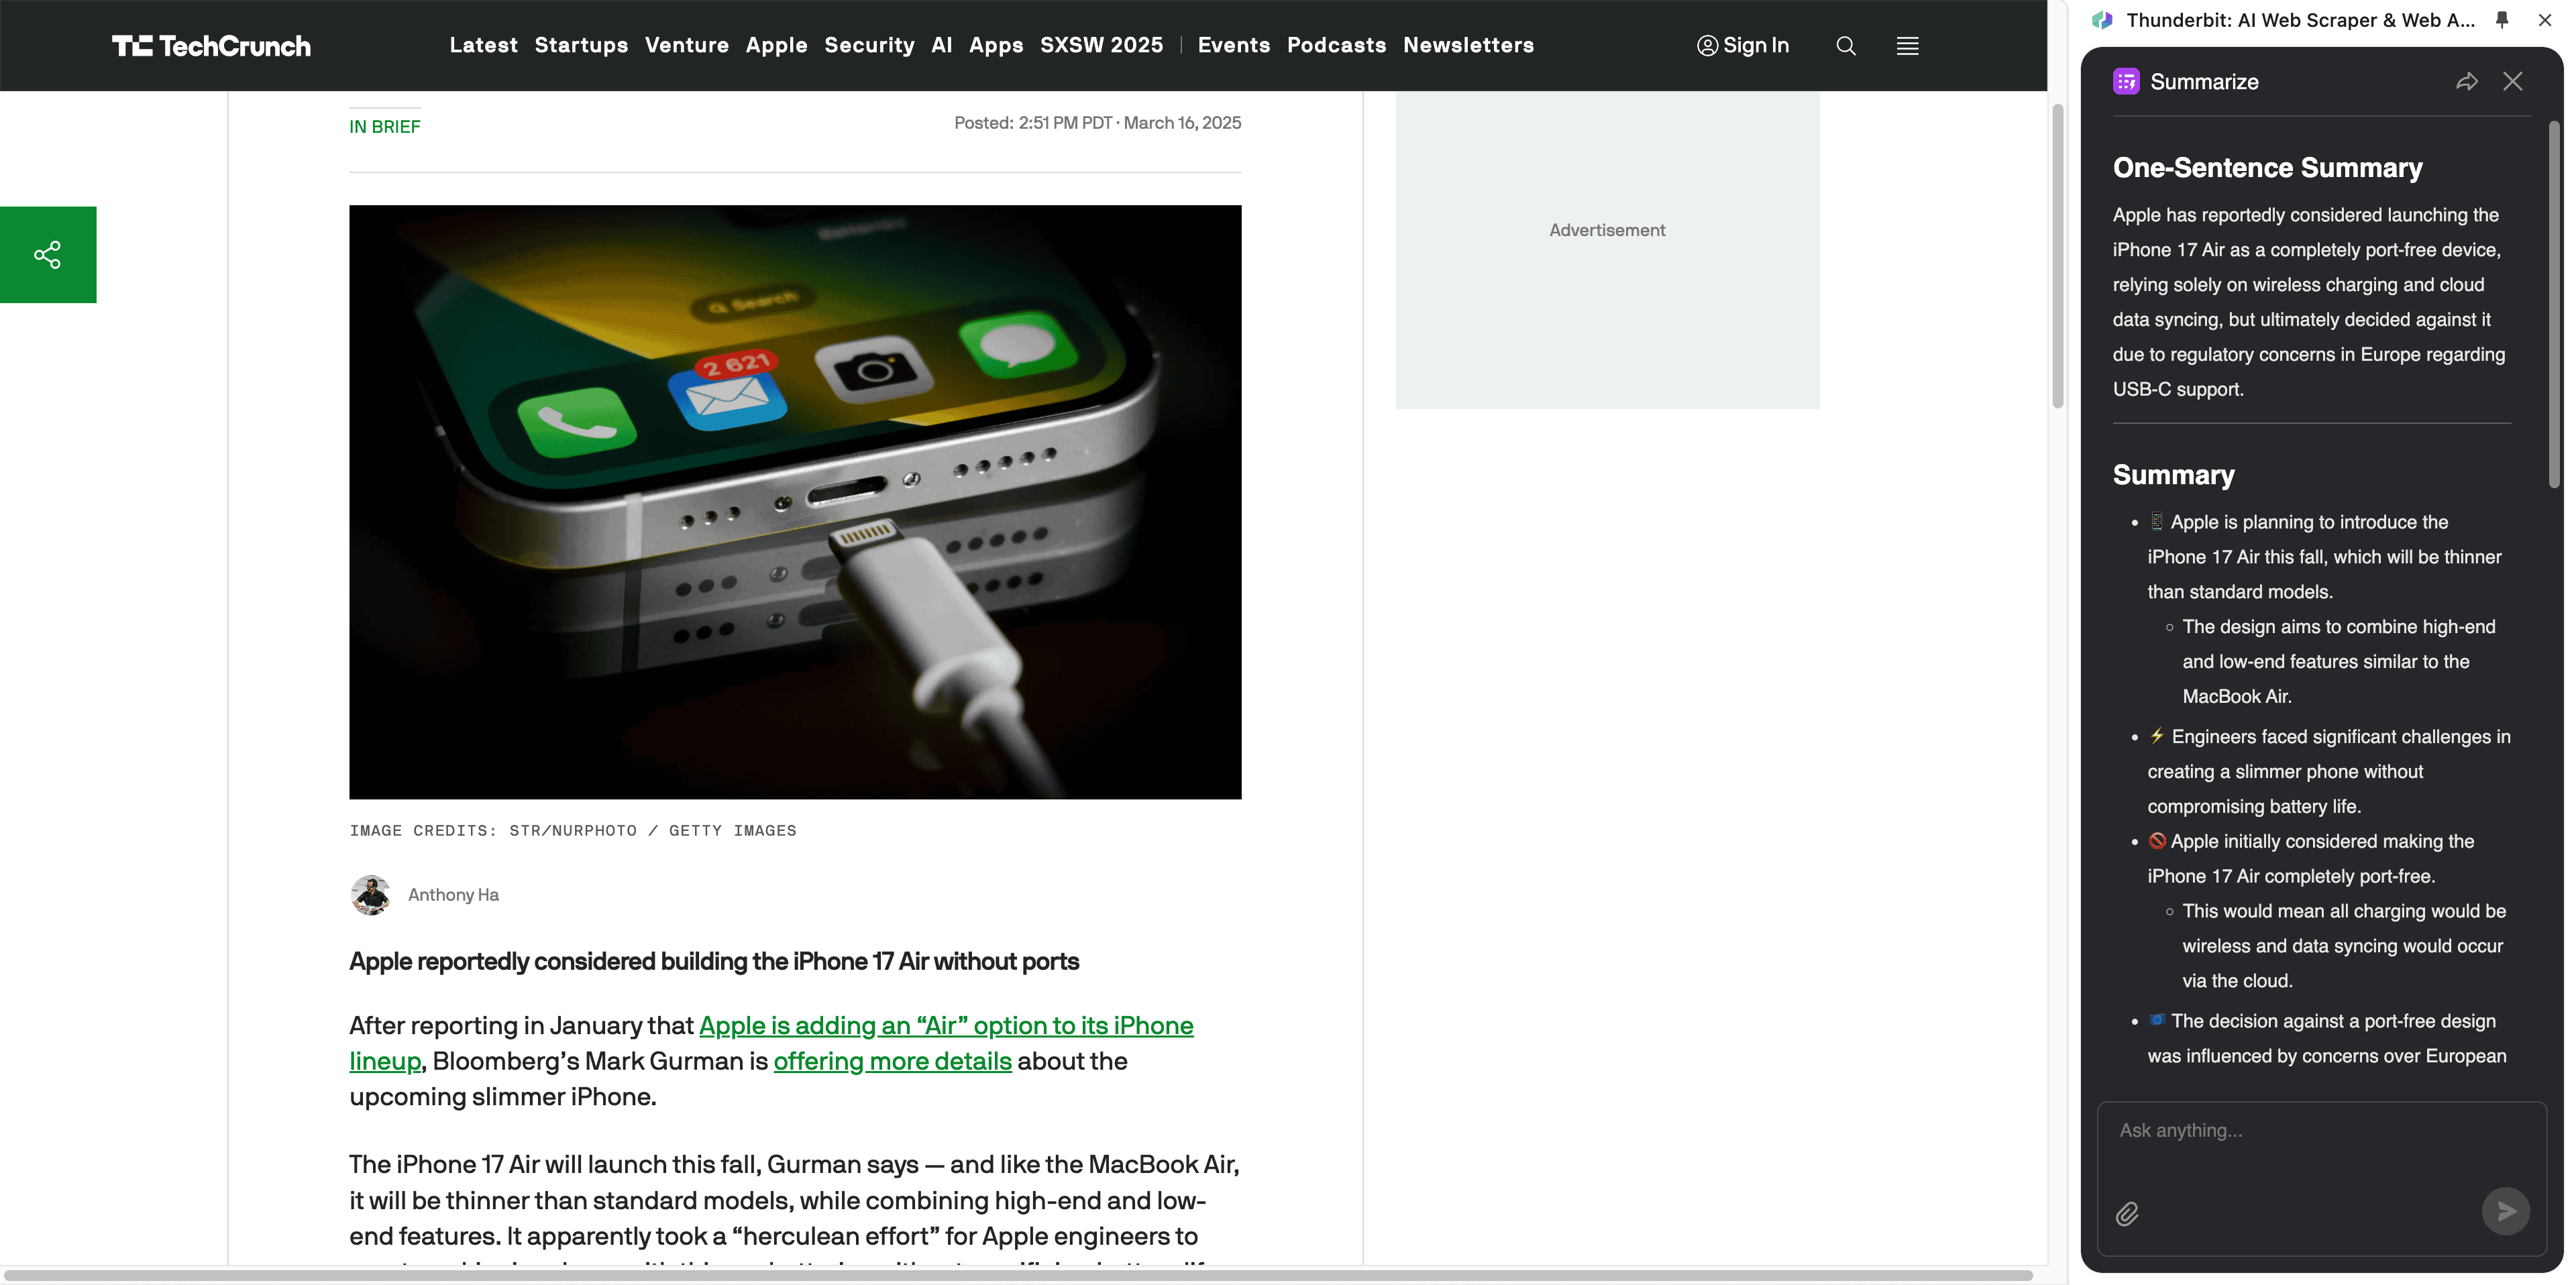
- Propojení s NLP a deep learningem: Dokáže zvládat i úlohy jako překlad, sumarizace nebo analýza sentimentu.
Co dělá nejlepší scraper na články v roce 2026?
Špičkový scraper na články musí vyvažovat výkon, cenu, jednoduchost použití, flexibilitu a škálovatelnost. Tady jsou kritéria pro výběr nejlepšího scraperu na články v roce 2026:
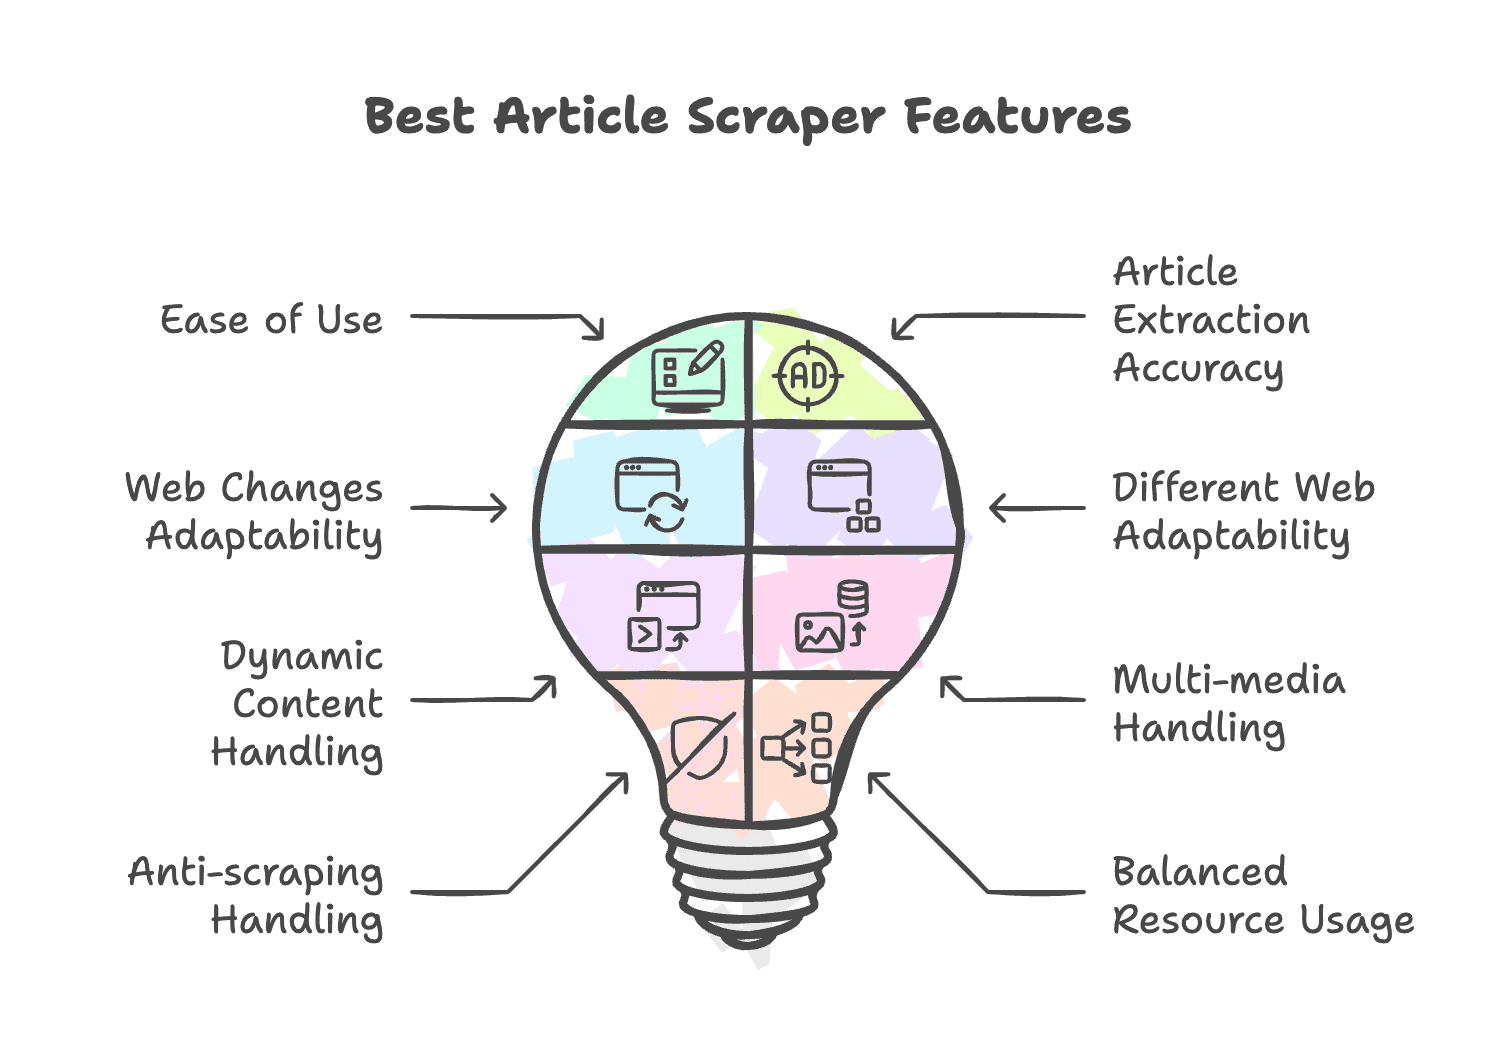
- Snadné použití: Intuitivní rozhraní, bez nutnosti programování.
- Přesnost extrakce článků: Spolehlivě rozpozná relevantní informace bez reklam a navigace.
- Přizpůsobení změnám webu: Automaticky reaguje na změny struktury nebo stylu bez časté údržby.
- Kompatibilita s různými weby: Funguje napříč různými strukturami stránek.
- Zvládání dynamického obsahu: Podporuje načítání obsahu přes JavaScript nebo AJAX.
- Práce s multimédii: Rozpozná obrázky, videa i audio.
- Ochrana proti scrapingu: Používá rotaci IP, řešení CAPTCHA a proxy, aby obešel anti-scraping mechaniky.
- Vyvážené využití zdrojů: Nespotřebovává zbytečně paměť ani výkon.
Nejlepší scrapery na články a zprávy na první pohled
| Nástroj | Klíčové funkce | Nejvhodnější pro | Cena |
|---|---|---|---|
| Thunderbit | AI scraper; předpřipravené šablony; podpora scrapování PDF, obrázků a dokumentů; pokročilé zpracování dat | Uživatelé bez technického zázemí, kteří potřebují scrapovat více menších specializovaných webů | 7denní zkušební verze zdarma, od 9 $/měsíc (roční plán) |
| WebScraper.io | Rozšíření do prohlížeče; podpora dynamického obsahu; zahrnuje integraci s proxy | Uživatelé, kteří nepracují s komplexními stránkami nebo pokročilými funkcemi | 7denní zkušební verze zdarma, od 50 $/měsíc (roční plán) |
| Browse.ai | No-code web scraper a monitor; předpřipravení roboti; virtuální prohlížeč; různé metody stránkování; silná integrace | Firmy, které potřebují velkoobjemové scrapování složitých webů | 19 $/měsíc (roční plán) |
| Octoparse | No-code scraper založený na CSS selektorech; automatická detekce a generování workflow; předpřipravené šablony na články; virtuální prohlížeč; anti-anti-scraping mechanismy | Firmy potřebující scrapování složitých webů | Od 58,44 $/měsíc (roční plán) |
| Bardeen | Komplexní automatizace webu; předpřipravené šablony; no-code scraper; bezproblémová integrace s pracovním prostředím | GTM týmy, které chtějí začlenit scrapování článků do stávajících workflow | Od 10 $/měsíc (Basic); včetně 100 kreditů/měsíc, bez zkušební verze zdarma |
| Ultimate Web Scraper | Přehledné uživatelské rozhraní; automatická detekce a označování | Uživatelé, kteří potřebují rychlou extrakci jedním kliknutím bez složitého nastavení | Lokální extrakce zdarma; cloud od 60 $/rok (Pro) |
Nejmocnější AI scraper na články pro firemní uživatele
- Výhody:
- Používá přirozený jazyk k tomu, aby AI rozpoznala a analyzovala informace z webu, takže není potřeba pracovat s CSS selektory
- AI pomáhá i s analýzou dat, včetně převodu formátů, sumarizace, klasifikace, překladu a tagování
- Předpřipravené šablony na články pro extrakci seznamů článků i obsahu na jedno kliknutí
- Dostupné ceny a velmi dobrý poměr cena/výkon
- Nevýhody:
- Aktuálně dostupné pouze jako rozšíření pro Chrome
- Není vhodný pro velkoobjemové scrapování dat
- Při scrapování více stránek je rychlost nižší, ale lze běžet na pozadí a výsledky urychlit
Vyzkoušet Thunderbit AI scraper na články
AI scraper na články pro firemní nasazení
Browse.ai
- Výhody:
- No-code scraper na články a monitoring
- Podpora virtuálního prohlížeče, aby se minimalizovalo spuštění anti-scraping ochrany
- Řada předpřipravených robotů pro jedním klikem scraping z Google News, Medium, Hacker News a dalších
- Hluboká integrace s platformami jako Zapier a Make pro propojení nástrojů
- Nevýhody:
- Deep extract vyžaduje vytvoření dvou robotů, což proces komplikuje
- CSS selektory nejsou dost přesné pro specializované weby
- Je drahý, vhodnější pro velké a průběžné sběry dat
No-code scraper pro menší datové extrakce
Ultimate Web Scraper
- Výhody:
- Automaticky rozpozná seznamy článků i detailní stránky v přehledném rozhraní
- Umí extrahovat seznamy, detaily, e-maily i obrázky, takže se hodí pro menší strukturovaný sběr dat
- Dostupná roční cena, od 60 $/rok (Pro)
- Nevýhody:
- Je dostupný pouze jako rozšíření do prohlížeče, nelze ho spouštět v cloudu
- Bezplatná verze umožňuje jen kopírování, ne export do CSV, JSON apod.
Připravený scraper na články pro organizace
Octoparse
- Výhody:
- No-code scraper na články s automatickou detekcí pro rozpoznání struktury webu a vytvoření scraping workflow
- Množství předpřipravených šablon na články, okamžitě k použití
- Používá virtuální prohlížeč s rotací IP, řešením CAPTCHA a proxy, aby obešel anti-scraping ochrany
- Nevýhody:
- Automatická detekce stále spoléhá na logiku CSS selektorů a přesnost je průměrná
- Pokročilé funkce vyžadují učení a technické znalosti
- Vysoké náklady při velkoobjemovém sběru dat
Nejkomplexnější automatizace pro GTM týmy
Bardeen
- Výhody:
- No-code scraper na články využívající LLM pro automatizaci na jedno kliknutí
- Integruje se s více než 100 aplikacemi, včetně Google Sheets, Slack a Zoom
- Silné nástroje pro automatizaci webu a následnou AI analýzu po extrakci dat
- Ideální pro zapojení scrapingu do existujících workflow
- Nevýhody:
- Silně závisí na předpřipravených playboocích, vlastní workflow vyžadují pokusy a ladění
- I když jde o no-code platformu, pochopení a nastavení složitější automatizace může pro netechnické uživatele vyžadovat čas na učení
- Nastavení extrakce podstránek je složité
- Velmi drahý
Lehký scraper na články pro okamžitou extrakci dat
Webscraper.io
- Výhody:
- No-code scraper s rozhraním typu point-and-click
- Podporuje dynamické načítání obsahu
- Funguje v cloudu
- Integruje se s Dropbox, Google Sheets a Amazon
- Nevýhody:
- Nemá předpřipravené šablony, je nutné vytvořit vlastní sitemapu
- Pro uživatele neznalé CSS selektorů je tu delší křivka učení
- Složité nastavení stránkování a extrakce podstránek
- Cloudová verze je drahá
Pokročilejší řešení pro vývojáře
Pro technicky zdatné uživatele jsou k dispozici API pro scrapování článků. Tato řešení nabízejí:
- Flexibilitu: Přímé API volání pro vlastní scraping, včetně dynamického renderování a rotace IP
- Škálovatelnost: Zapojení do vlastních datových pipeline pro firemní potřeby s vysokou frekvencí a velkým objemem dat
- Nízké náklady na údržbu: Není nutné spravovat proxy pooly ani anti-scraping strategie, což šetří provozní čas
Přehled API řešení
| API | Výhody | Nevýhody |
|---|---|---|
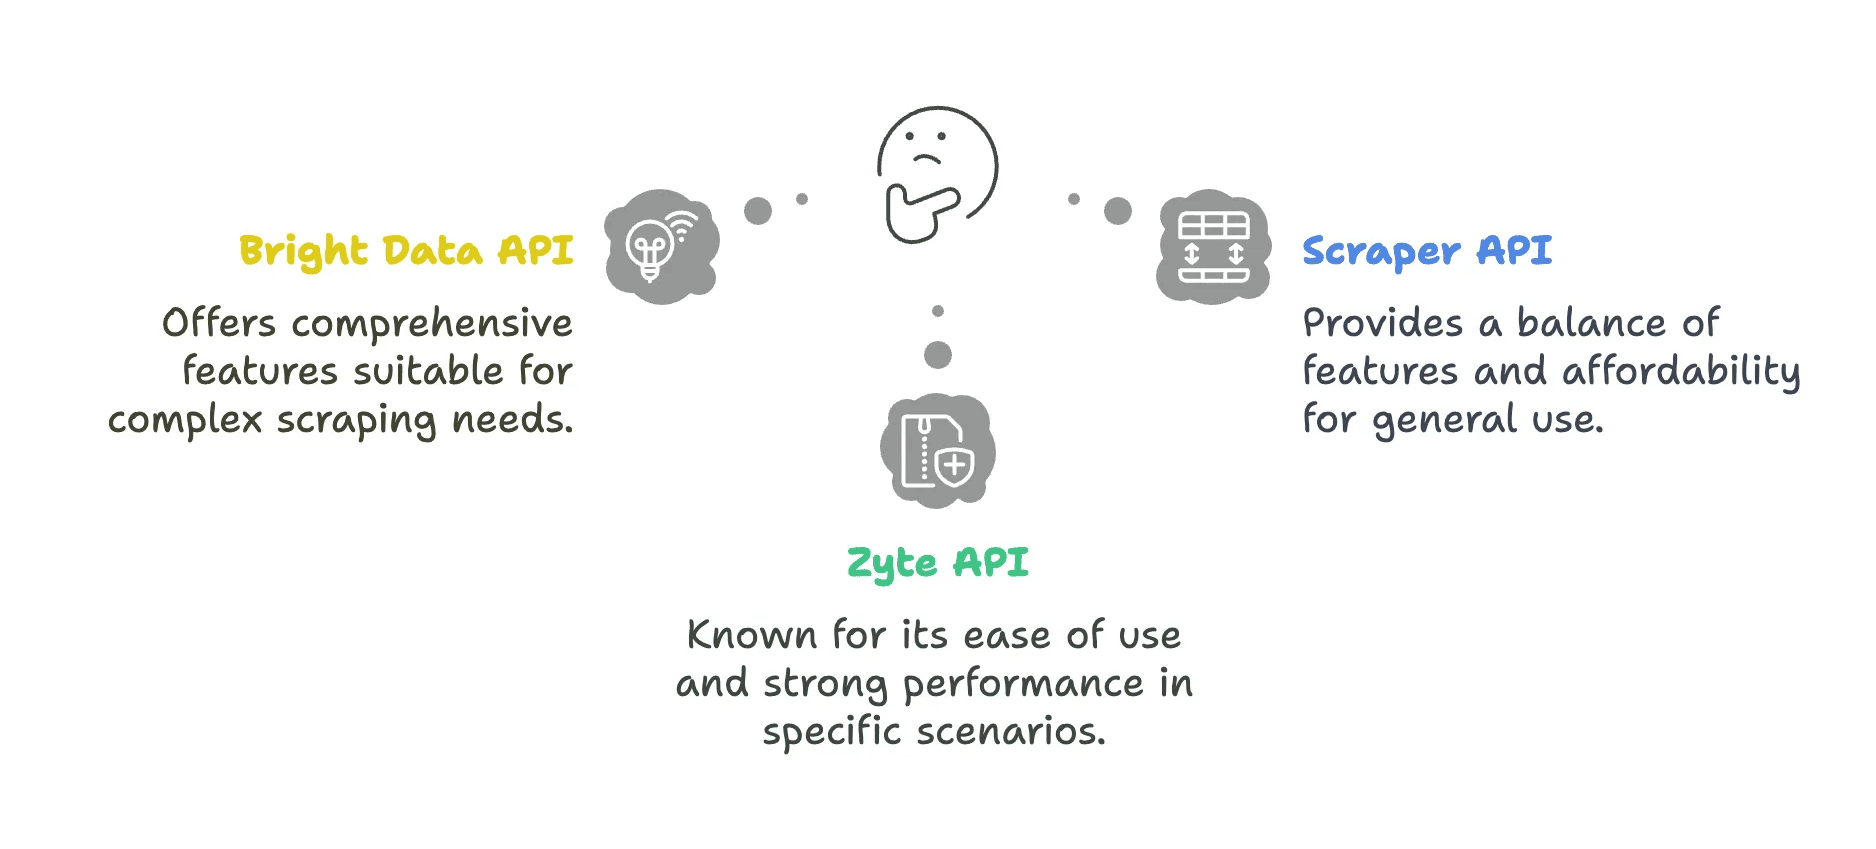
| Bright Data API | - Rozsáhlá proxy síť (72M+ IP ve 195 zemích) - Pokročilé geo-targeting až na úroveň města/PSČ - Robustní Proxy Manager pro rotaci IP | - Pomalejší odezva (průměrně 22,08 s) - Vyšší cena není vhodná pro menší týmy - Strmější křivka učení při konfiguraci |
| ScraperAPI | - Nižší vstupní cena od 49 $ - Funkce Autoparse pro automatickou extrakci dat - Web UI player pro testování | - Často účtuje i blokované požadavky - Omezené možnosti renderování JavaScriptu - Náklady mohou růst s prémiovými parametry |
| Zyte API | - AI možnosti parsování - Neúčtuje neúspěšné požadavky | - Vyšší počáteční cena (~100 $/měsíc) - Kredity se nepřevádějí do dalšího měsíce |
- Bright Data Web Scraper API
- Výhody:
- Nevýhody:
- Vysoká cena (účtováno za požadavek i šířku pásma), nízká efektivita pro menší projekty
- Scraper API
- Výhody:
- 40 milionů proxy po celém světě, automatické přepínání mezi datacenter a rezidenčními IP, obchází ověření Cloudflare a integruje služby třetích stran pro řešení CAPTCHA (např. 2Captcha)
- Strukturované endpointy a asynchronní scrapery pro rychlejší sběr dat
- Nevýhody:
- Dodatečné náklady za renderování dynamických stránek, omezená podpora složitých AJAX webů
- Výhody:
- Zyte API
- Výhody:
- Automatická extrakce webových dat pomocí AI, bez nutnosti vytvářet a udržovat pravidla pro každý web zvlášť
- Flexibilní platba podle použití
- Nevýhody:
- Pokročilé funkce (např. správa session, skriptovatelný prohlížeč) vyžadují učení
- Výhody:
Jak vybrat scraper na články a zprávy?
Při výběru scraperu na články a zprávy zvaž potřeby svého byznysu, technické znalosti i rozpočet.
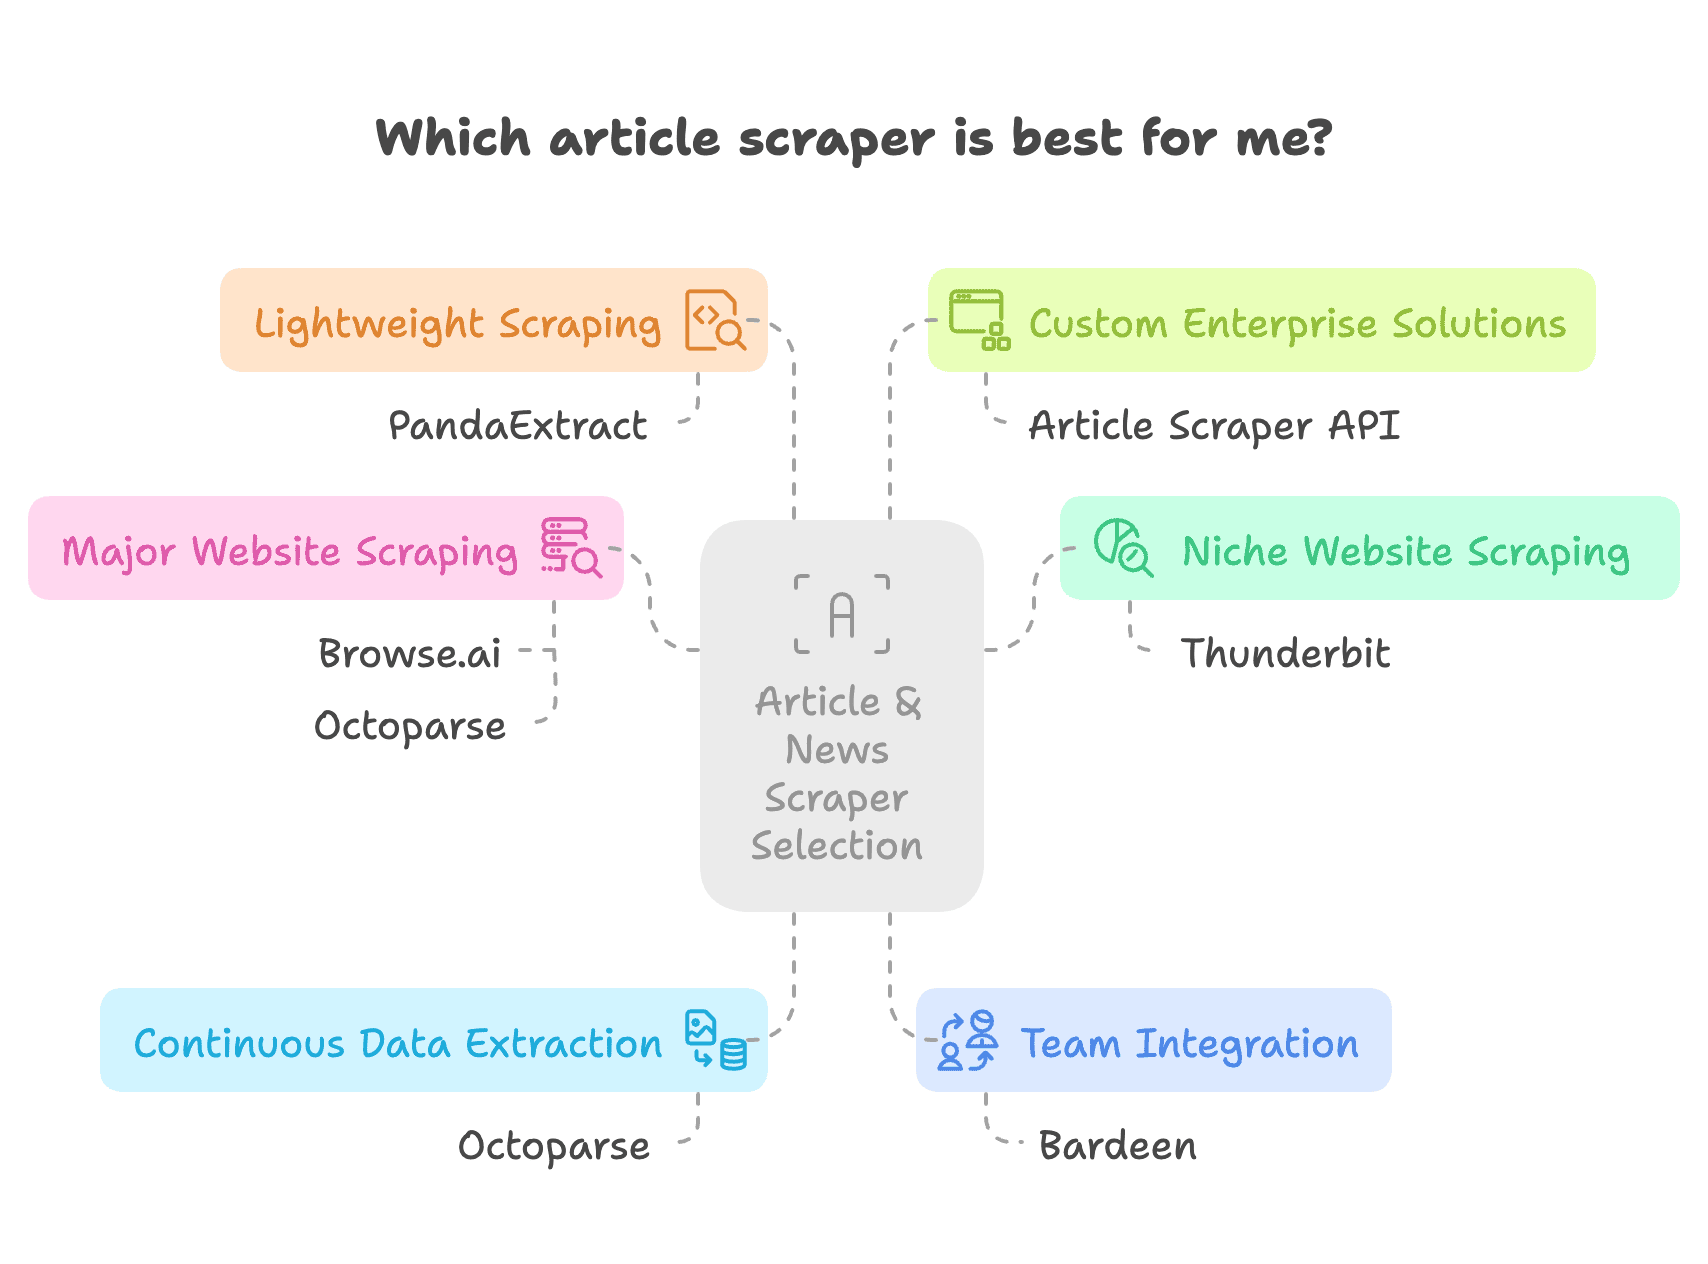
- Pokud potřebuješ scrapovat víc specializovaných webů bez vytváření vlastního scraperu pro každou stránku a máš rozpočet, Thunderbit je nejlepší volba. Nespoléhá na CSS selektory, ale používá AI k analýze struktury webu, takže po extrakci dat umožňuje i AI analýzu. Pro Thunderbit AI jsou všechny weby stejné, takže dokáže přesně zachytit celý článek.
- Pokud potřebuješ stahovat zprávy a články z velkých webů jako Wall Street Journal nebo Google News, budeš potřebovat scraper s robustní anti-scraping ochranou a předpřipravenými šablonami, například Browse.ai nebo Octoparse. Přesto je nejlepší volbou Chrome Extension jako Thunderbit: proces sběru dat připomíná běžné prohlížení a kopírování, takže můžeš pracovat i s přihlášením bez složitého nastavování.
- Pokud potřebuješ průběžný sběr dat ve velkém měřítku, vhodnější jsou nástroje s plánováním, jako je Octoparse.
- Pro týmové použití a hladkou integraci do stávajících workflow je ideální Bardeen, který nabízí i řadu dalších nástrojů pro automatizaci webu nad rámec scrapingu článků.
- Pokud chceš lehký scraper na články pro menší extrakce dat a nechceš ztrácet čas učením, vyber point-and-click scraper jako Ultimate Web Scraper.
- Pokud máš technické zázemí nebo stavíš firemní scraper na články, zvaž API nástroje nebo vytvoření vlastního scraperu vedle těchto no-code scraperů.
Závěr
Tenhle článek představil koncept a firemní využití scraperů na články a zprávy. Tradiční scrapery stojí na CSS selektorech a vyžadují určitou znalost webového HTML a CSS, hlavně při pokročilejší práci. Nová generace AI scraperů na články se opírá výhradně o sémantické porozumění a vizuální rozpoznávání AI, díky čemuž překonává tradiční scrapery v přizpůsobení změnám struktury webu, přenositelnosti mezi weby, práci s dynamickým obsahem i následném čištění a analýze dat.
Článek taky představil šest užitečných scraperů na články a zprávy i API nástroje pro vývojáře a porovnal jejich výhody a nevýhody, vhodný rozsah dat, vlastnosti webů i cílové uživatele. Při výběru řešení pro scrapování článků a zpráv vybírej nástroj, který odpovídá potřebám tvého byznysu, a zároveň vyvaž výkon a cenu.
Často kladené otázky
1. Co je AI scraper na články a jak funguje?
- Využívá AI k analýze a extrakci obsahu z webových stránek bez nutnosti CSS selektorů.
- S vysokou přesností rozpozná titulky, autory, datum vydání i hlavní obsah.
- Automaticky odstraňuje reklamy, navigační menu a další irelevantní prvky.
- Přizpůsobuje se změnám struktury webu a funguje napříč různými weby.
2. Jaké jsou výhody AI scraperu na články oproti tradičním scraperům?
- Dokáže zpracovávat obsah z více webů pomocí jediného nástroje.
- Zvládá dynamický obsah, včetně stránek načítaných přes JavaScript a AJAX.
- Vyžaduje méně ručního nastavení a údržby než scrapery založené na CSS.
- Nabízí i další funkce, jako je sumarizace, překlad a analýza sentimentu.
3. Můžu Thunderbit používat pro AI scrapování článků bez programování?
- Ano, Thunderbit je navržen pro netechnické uživatele a má jednoduché no-code rozhraní.
- Používá AI k automatickému rozpoznání a extrakci obsahu článků.
- Nabízí předpřipravené šablony pro rychlé a efektivní scrapování.
- Umožňuje export dat do různých formátů, jako jsou CSV, JSON a Google Sheets.
Další informace:
- Co je web scraping
- Jak používat AI pro web scraping
- Moderní web scraping: podrobný pohled na AI nástroje
- News Scraping: nástroje, use-cases a výzvy
Vyzkoušet AI web scraper Get Started Free




