
كل بضع أسابيع، يتكرر عند فريق الدعم عندي السؤال نفسه من أحد العملاء المحتملين: «ما الفرق بين Thunderbit و ScraperAPI؟» وأنا أفهم تمامًا سبب هذا السؤال — فكلتاهما تظهران في نتائج بحث Google نفسها عند البحث عن «web scraping tool»، وكلتاهما تضعان كلمة «scrape» أو «scraper» في كل زاوية من صفحتهما الرئيسية، وكلتاهما تعدك بالحصول على بيانات من الإنترنت. لكن بعد سنوات من بناء منتجات الأتمتة والذكاء الاصطناعي، وقبلها وقت طويل أمضيته في تفكيك خطوط بيانات معقدة داخل Automation Anywhere، أقدر أقول لك إن هاتين الأداتين تجيبان عن سؤالين مختلفين تمامًا.
هذا ليس بالضبط مقارنة من نوع «أيّهما أفضل؟» — بل أقرب إلى مقارنة شركة نقل عفش بمساعد شخصي. كلاهما يساعدك على إنجاز الأمور، لكنك لن تستأجر أحدهما ليقوم بعمل الآخر. لذلك دعني أوضح ما هو ScraperAPI فعليًا، وما هو Thunderbit فعليًا، وكم تبلغ كلفة كل واحد في السيناريوهات الواقعية (وهو شيء لاحظت أن أحدًا لم يضعه جنبًا إلى جنب بشكل واضح)، ومن ينبغي أن يختار أيًّا منهما. بدون تلطيف زائد، وبدون الهروب من الإجابة بـ «يعتمد» كلما قدرت أتجنب ذلك.
Thunderbit مقابل ScraperAPI: الخلاصة السريعة
هذه هي النسخة المختصرة جدًا، لأنني أعرف أن بعضكم يقرأ أثناء استراحة الغداء: ScraperAPI هي بنية تحتية للمطورين لاستخراج البيانات على نطاق واسع — بروكسيات، معالجة CAPTCHA، وعرض الصفحات، وكل ذلك عبر API. أما Thunderbit فهو طبقة استخراج ذكية بلا كود، تحوّل الصفحات التي تشاهدها أصلًا إلى بيانات منظمة، مع إضافة متصفح، وWeb App، وOpen API، ومخدم MCP في الخلفية.
وهذا جدول مرجعي مختصر كنت أتمنى لو كان موجودًا عندما بدأت أتلقى أسئلة كهذه:
| ScraperAPI | Thunderbit | |
|---|---|---|
| الأنسب لـ | فرق الهندسة التي تبني خطوط استخراج البيانات | مستخدمو الأعمال، والمسوقون، وفرق العمليات، والمطورون الذين يريدون بيانات منظمة بسرعة |
| ما يتطلبه الإعداد | مفتاح API + معاملات الطلب + منطق التحليل الخاص بك | اضغط One Click Extract على الصفحة (من خلال إضافة المتصفح)، أو استخدم Open API/MCP للأتمتة |
| صيغة الإخراج | HTML/JSON خام، مع محللات منظمة للمواقع المدعومة | جداول منظمة قابلة للتصدير |
| هل يلزم برمجة؟ | نعم، في معظم الاستخدامات الحقيقية | لا في مسار المتصفح؛ نعم إذا كنت تستخدم API/CLI/MCP |
| المستخدم المثالي | مطور أو فريق عمليات تقني | مستخدم غير تقني، إضافة إلى المطورين الذين يريدون طبقة منظمة أسرع |
إذا كنت تعرف مسبقًا أيّ معسكر تنتمي إليه، فانتقل إلى الأقسام أدناه المناسبة لك — أحدها يشرح ScraperAPI بمزيد من العمق، والآخر يشرح Thunderbit، وفي الأسفل ستجد أيضًا تفصيلًا حقيقيًا للتسعير وإطارًا لاتخاذ القرار ينبغي أن يحسم سؤال «أيّهما يناسبني؟» خلال أقل من دقيقتين.
ما هو ScraperAPI؟ أداة مخصصة للمطورين وبنية استخراج البيانات
ببساطة، ScraperAPI هي خدمة ترسل إليها رابط صفحة، فتُرجع لك المحتوى بينما تتكفّل بصمت بالأجزاء المزعجة من عملية الاستخراج — تدوير البروكسيات، إعادة المحاولة عند فشل الطلبات، تجاوز CAPTCHA وأنظمة اكتشاف الروبوتات، وأحيانًا عرض الصفحات الثقيلة بجافاسكريبت كما لو كان متصفحًا حقيقيًا. لكنك ما زلت أنت من يكتب الكود الذي يستدعي الـ API ويحلّل ما يعود منه.
وهذه نقطة مهمة لا أظن أنها تُذكر بما يكفي. ScraperAPI لم تعد «HTML خام فقط» — فـمجموعة ميزاتها الحالية تشمل التحليل التلقائي إلى JSON ونقاط نهاية للبيانات المنظمة للأهداف المدعومة، بالإضافة إلى منتج DataPipeline ووصول كامل إلى Crawler للمهام الأكبر. إذن هي ليست عالقة في 2018. لكن الفرضية الأساسية في المنتج هي أنك تمتلك (أو تبني) سير عمل هندسيًا حولها: شيء يرسل الطلبات، ويتحقق من الاستجابات، ويتعامل مع إعادة المحاولة على مستوى التطبيق، ويخزن النتائج في مكان مفيد.
المجال الذي تتألق فيه ScraperAPI فعلًا هو العمل على مستوى البنية التحتية: مئات الآلاف أو ملايين الطلبات شهريًا، ضد مواقع تقاوم بشراسة أنظمة اكتشاف الروبوتات. هذه مشكلة صعبة، والاستعانة بشركة وظيفتها الأساسية إدارة البروكسيات هو قرار ذكي لكثير من فرق الهندسة. وسأقول هذا بوضوح لأن بعض مقالات المقارنة تميل إلى المبالغة في الاتجاهين: ScraperAPI لا تضمن عبور كل نظام حماية من الروبوتات في العالم، وادعاءات التسويق مثل نسب التوافر هي تصريحات من المزوّد، وليست نتائج قياس مستقلة. تعامل معها كنقطة بداية، لا كحقيقة نهائية.
من ينبغي أن يفكر أصلًا في ScraperAPI؟
أنت غالبًا مناسب لها إذا:
- كنت مرتاحًا لكتابة كود يرسل طلبات API ويحلّل الاستجابات
- كنت بحاجة إلى الاستخراج على نطاق فعلي — أي عشرات الآلاف إلى ملايين الصفحات شهريًا
- كنت تحتاج إلى تدوير البروكسيات، والاستهداف الجغرافي، والتعامل مع anti-bot داخل خط الطلبات مباشرة
- لديك بالفعل (أو تريد بناء) خط بيانات تندمج فيه ScraperAPI كطبقة «وصول»
إذا هززت رأسك موافقًا على أي مما سبق، فاحتفظ بـ ScraperAPI ضمن قائمتك القصيرة. أما إذا شعرت أن هذه المصطلحات معقدة، فابقَ معي — فالقسم التالي سيكون على الأرجح أقرب لاحتياجك.
ما هو Thunderbit؟ طبقة استخراج ذكية بلا كود
Thunderbit ينطلق من نقطة مختلفة تمامًا: بدل أن يفترض أنك ستكتب منطق الاستخراج بنفسك، فإنه يستنتج هذا المنطق نيابةً عنك. اضغط One Click Extract، وستقترح لك ذكاء Thunderbit الحقول المناسبة واستراتيجية الاستخراج، ثم يحوّل الصفحة إلى بيانات منظمة — مثل أسماء المنتجات، والأسعار، ومعلومات التواصل، وإعلانات الوظائف، أو أي شيء تدور حوله الصفحة فعلًا.

هذه البساطة مهمة جدًا للفئة غير التقنية التي صُمم Thunderbit لها: الانتقال من صفحة ويب إلى جدول جاهز للاستخدام يتم بنقرة واحدة، من دون selectors أو تصميم schema أو كتابة كود scraping. لا أحد يريد واجبًا منزليًا قبل الحصول على جدول البيانات.
ولا يقتصر Thunderbit على المتصفح أيضًا. هناك Web App للتشغيل السحابي، وOpen API للمطورين الذين يريدون استدعاء الاستخراج برمجيًا، ومخدم MCP لربط Thunderbit بوكلاء الذكاء الاصطناعي مثل Claude أو Cursor، وCLI لسير العمل عبر الطرفية. لذلك، رغم أن التجربة الرئيسية بلا كود، فهو ليس أداة بلا كود حصريًا — والأدق أن نعتبره طبقة استخراج منظمة تتيح عدة منافذ إلى القدرة نفسها.
ولأوضح نقطة سأعود إليها لاحقًا: Thunderbit ليس منتجًا لتدوير البروكسيات أو تجاوز الـ anti-bot. إنه مصمم لاستخراج بيانات منظمة من صفحات يمكنك الوصول إليها أصلًا، لا لمواجهة جدران CAPTCHA على نطاق واسع. هذا عمل مختلف تمامًا.
من ينبغي أن يفكر أصلًا في Thunderbit؟
أنت غالبًا مناسب له إذا:
- كنت تعمل في المبيعات أو التسويق أو العمليات أو البحث وتحتاج بيانات من صفحة ويب اليوم، لا بعد سباق هندسي لمدة أسبوعين
- تريد أن تصل البيانات مباشرة إلى مكان مفيد — Excel أو Google Sheets أو Airtable أو Notion — من دون كتابة parser
- تفضّل الضغط على زر بدل كتابة scraper، وهذا ليس عيبًا، بل مجرد كفاءة
- أنت مطور تريد طبقة إخراج منظمة أسرع للأدوات الداخلية، حتى لو كنت قادرًا على البرمجة
كيف يعملان: البنية وسير العمل جنبًا إلى جنب
أبسط طريقة أقدر أوضح بها الفرق هي هذه: ScraperAPI تعطيك المواد الخام وتفترض أنك ستبني الأثاث. Thunderbit يحاول أن يعطيك الأثاث جاهزًا ومركبًا.
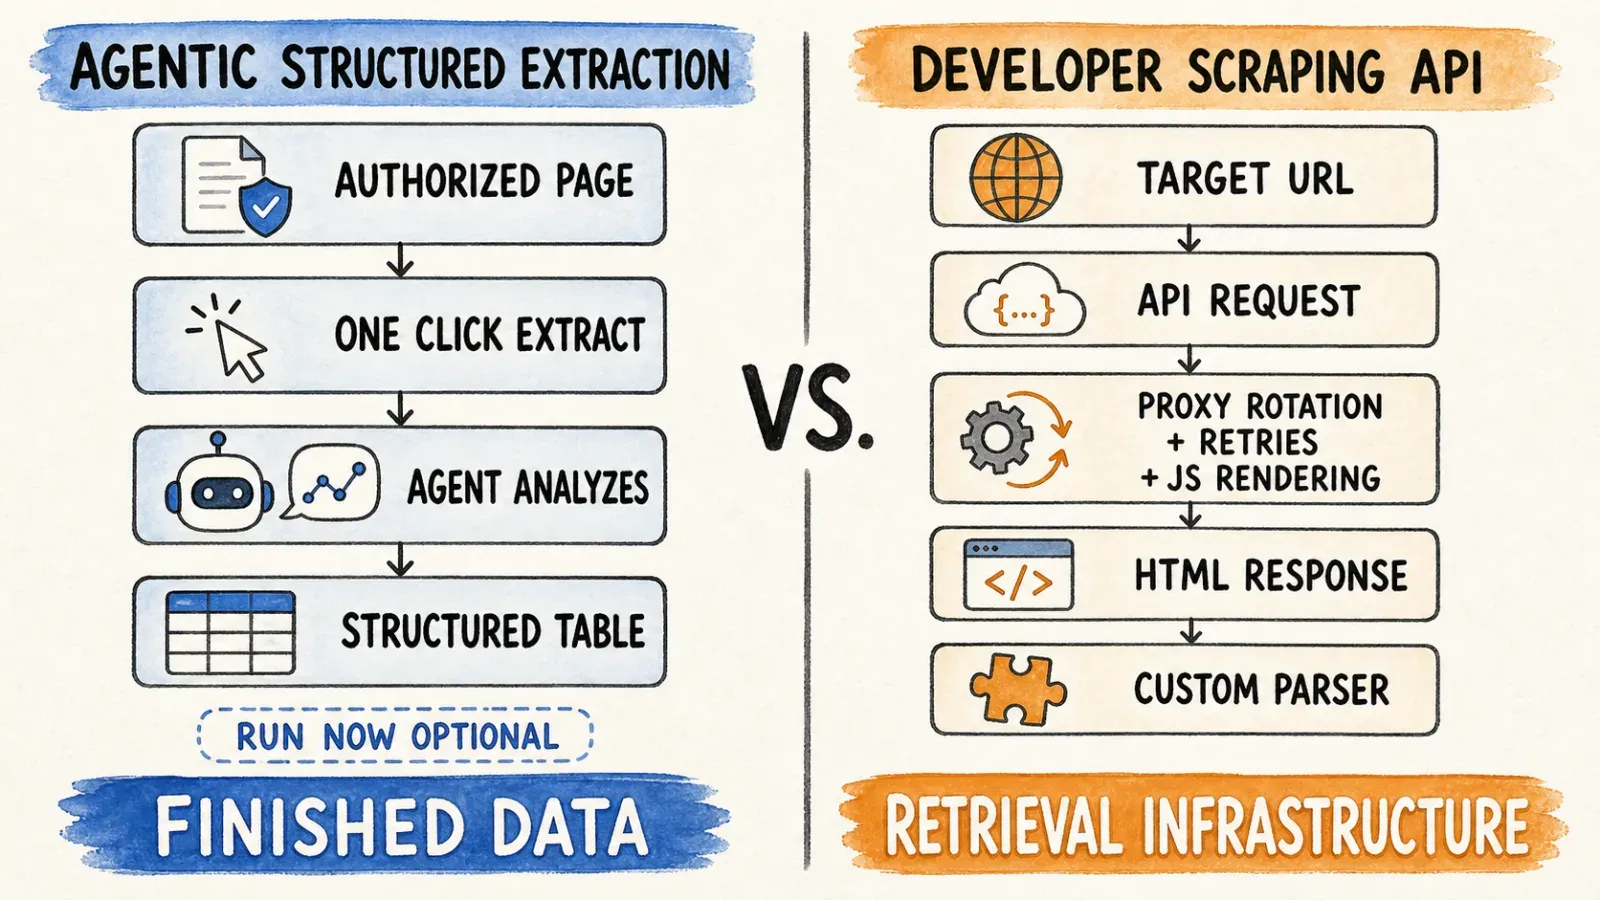
تحت الغطاء، تعتمد بنية ScraperAPI أولًا على البروكسيات والعرض. طلبك يمر عبر شبكتها، ثم يُوجَّه عبر IPs منزلية أو محمولة حسب الحاجة، وربما يُعرض عبر متصفح headless إذا كان تنفيذ JavaScript مطلوبًا، ثم يعود إليك بصيغة HTML أو JSON أو بنية محللة للنطاقات المدعومة. كل ما يأتي بعد ذلك — تصميم schema، التخزين، إزالة التكرار، الجدولة — يقع على عاتقك، إلا إذا كنت تستخدم منتجات DataPipeline أو Crawler المصممة تحديدًا لذلك.
أما بنية Thunderbit فهي تبدأ بالتحليل. يفهم الوكيل بنية الصفحة ومحتواها قبل أن يقرر ما الذي سيستخرجه، ما يعني أن خطوة «الـ schema» التي يبرمجها المطور عادة يدويًا تتم تلقائيًا. والنتيجة ليست مادة خام — بل جدول يمكنك أن تسلمه لمدير المبيعات من دون أن تعتذر عن التنسيق.
جدول مقارنة: الآليات الأساسية
| ScraperAPI | Thunderbit | |
|---|---|---|
| النموذج الأساسي | تدوير بروكسيات + عرض HTML/JS خام عبر API | تحليل ذكي للصفحة → استخراج منظم عبر الإضافة، وWeb App، وAPI، وMCP Server |
| الإعداد | أرسل الطلب إلى نقطة النهاية مع المعاملات | اضغط One Click Extract؛ يقترح الذكاء الحقول واستراتيجية الاستخراج ثم يبدأ التنفيذ |
| الإخراج | HTML/JSON خام، مع محللات منظمة للمواقع المدعومة | بيانات منظمة قابلة للتصدير |
| الأفضل لـ | خطوط استخراج على نطاق بنية تحتية | استخراج سريع ومنظم وبلا كود من صفحة متاحة الوصول |
ولا أحد النموذجين «أفضل» بشكل مطلق — فكل واحد منهما مصمم لحل عنق زجاجة مختلف. عنق الزجاجة في ScraperAPI هو الوصول (تجاوز الحواجز). أما عنق الزجاجة في Thunderbit فهو الفهم (تحويل صفحة فوضوية إلى صفوف مفيدة).
Thunderbit مقابل ScraperAPI: التسعير الحقيقي لكل 1000 صفحة
هذا هو الجزء الذي جعلني أرغب في كتابة المقال كله، بصراحة. كل تحليل معمّق لتسعير ScraperAPI يشرح نظام مضاعفة الرصيد بتفاصيل مرهقة، وكل صفحة تسعير لـ Thunderbit تشرح خطط Thunderbit الخاصة، لكن لا أحد يضعهما جنبًا إلى جنب ويقول: «حسنًا، لكن ما الكلفة الفعلية لما أحاول فعله؟»
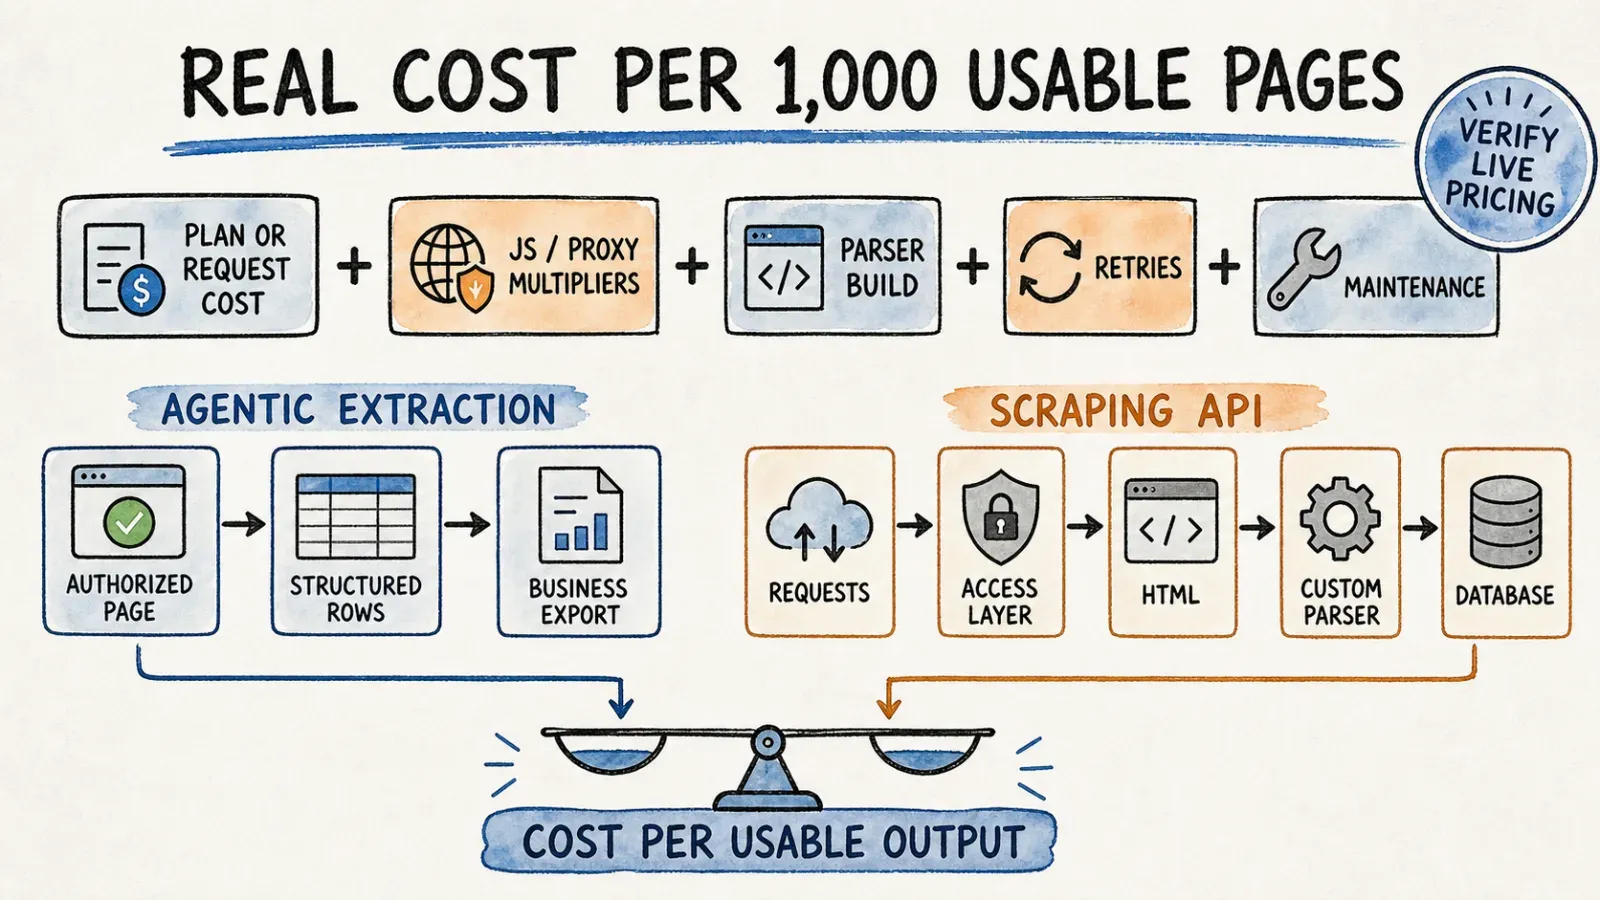
إذًا لنحسبها بالاعتماد على ما تسمح به وثائق ScraperAPI نفسها. نظام الرصيد يفرض معدلات أساسية مختلفة حسب الهدف: الصفحة العادية تكلّف 1 credit، وAmazon تكلّف 5 credits، ونتائج بحث Google أو Bing تكلّف 25 credit، وLinkedIn تكلّف 30 credit. وفوق ذلك، قد يضيف تجاوز أنظمة الحماية مثل Cloudflare أو DataDome 10 credits أخرى، كما أن عرض JavaScript أو ميزات البروكسي المميز قد يضيف المزيد — والقيمة الدقيقة تعتمد على الهدف، لذا فإن أداة تقدير التكلفة الخاصة بـ ScraperAPI داخل لوحة التحكم هي المصدر الوحيد الموثوق قبل الالتزام بخطة.
وباستخدام خطة Hobby (49 دولارًا مقابل 100,000 credit، أي ما يعادل تقريبًا 0.00049 دولار لكل credit) كأساس لحساب 1000 صفحة:
| السيناريو | تكلفة ScraperAPI لكل 1000 صفحة (بسعر خطة Hobby) | تكلفة ScraperAPI لكل 1000 صفحة (بسعر خطة Business) |
|---|---|---|
| صفحات ثابتة بسيطة (1 credit/صفحة) | حوالي 0.49 دولار | حوالي 0.10 دولار |
| صفحات تجارة إلكترونية على نمط Amazon (5 credits/صفحة) | حوالي 2.45 دولار | حوالي 0.50 دولار |
| استخراج صفحات نتائج البحث Google/Bing (25 credits/صفحة) | حوالي 12.25 دولار | حوالي 2.49 دولار |
| صفحات LinkedIn (30 credits/صفحة) | حوالي 14.70 دولار | حوالي 2.99 دولار |
ويتّسع هذا النطاق بسرعة بمجرد إضافة رسوم JS rendering أو تجاوز الحماية، ويضيق بشكل ملحوظ في الخطط الأعلى حجمًا لأن سعر الـ credit الواحد ينخفض كلما انتقلت من Hobby إلى Business أو Scaling أو Professional. وهذه هي النقطة التي تتجاهلها أغلب مقالات المقارنة — فالكلفة الفعلية لكل صفحة في ScraperAPI تعتمد بدرجة كبيرة على كلٍّ من الموقع المستهدف وطبقة الخطة التي أنت عليها.
أما Thunderbit فتعتمد نموذج تسعير مختلفًا من حيث البنية: بدل مضاعفات خاصة بكل نطاق بحيث يصبح استخراج LinkedIn أغلى بـ 30 مرة من استخراج مدونة ثابتة، فإن خطط Thunderbit مبنية حول حصص شهرية من credits مرتبطة بحجم الصفوف أو الصفحات التي تستخرجها، وتزداد مع مستوى الخطة. لن أقدّم لك رقمًا مزيفًا لكل credit هنا، لأن صفحات التسعير تتغير، ولأني أفضل أن أحيلك إلى صفحة تسعير Thunderbit المباشرة بدل أن أعطيك رقمًا قد يصبح قديمًا بعد ثلاثة أشهر. لكن ما أستطيع قوله بصورة اتجاهية هو أنه في مهمة لمرة واحدة — مثل استخراج 500 عميل محتمل من دليل، أو سحب بضع مئات من المنتجات لمراجعة عميل — فلن تقضي وقتك في حساب المضاعفات قبل الضغط على التشغيل. أنت ببساطة تنفذ الاستخراج، وتحدد طبقة السعر التي أنت عليها عدد مرات التشغيل المتاحة لك شهريًا.
الخلاصة: إذا كنت تشغّل استخراجًا على نطاق بنية تحتية عبر أنواع عديدة من النطاقات وتستطيع توقع مضاعفات الرصيد مسبقًا، فإن نموذج ScraperAPI يكافئ التخطيط والحجم. أما إذا كنت تقوم باستخراج منظم، أو متقطع، أو موجّه للأعمال، حيث تكمن القيمة في الجدول النهائي لا في عدد الطلبات الخام، فإن نموذج Thunderbit مصمم لهذا الاستخدام بالذات.
أيهما تختار؟ إطار قرار قائم على الشخصية
لاحظت أن المقالات الأعلى ترتيبًا في هذه المقارنة لا تجيب فعليًا عن السؤال الذي يبحث عنه الناس، وهو شيء من قبيل: «هل أنا مطور أحتاج إلى بنية تحتية، أم شخصًا في الأعمال يحتاج فقط إلى بيانات؟» لذلك دعني أجيب مباشرة.
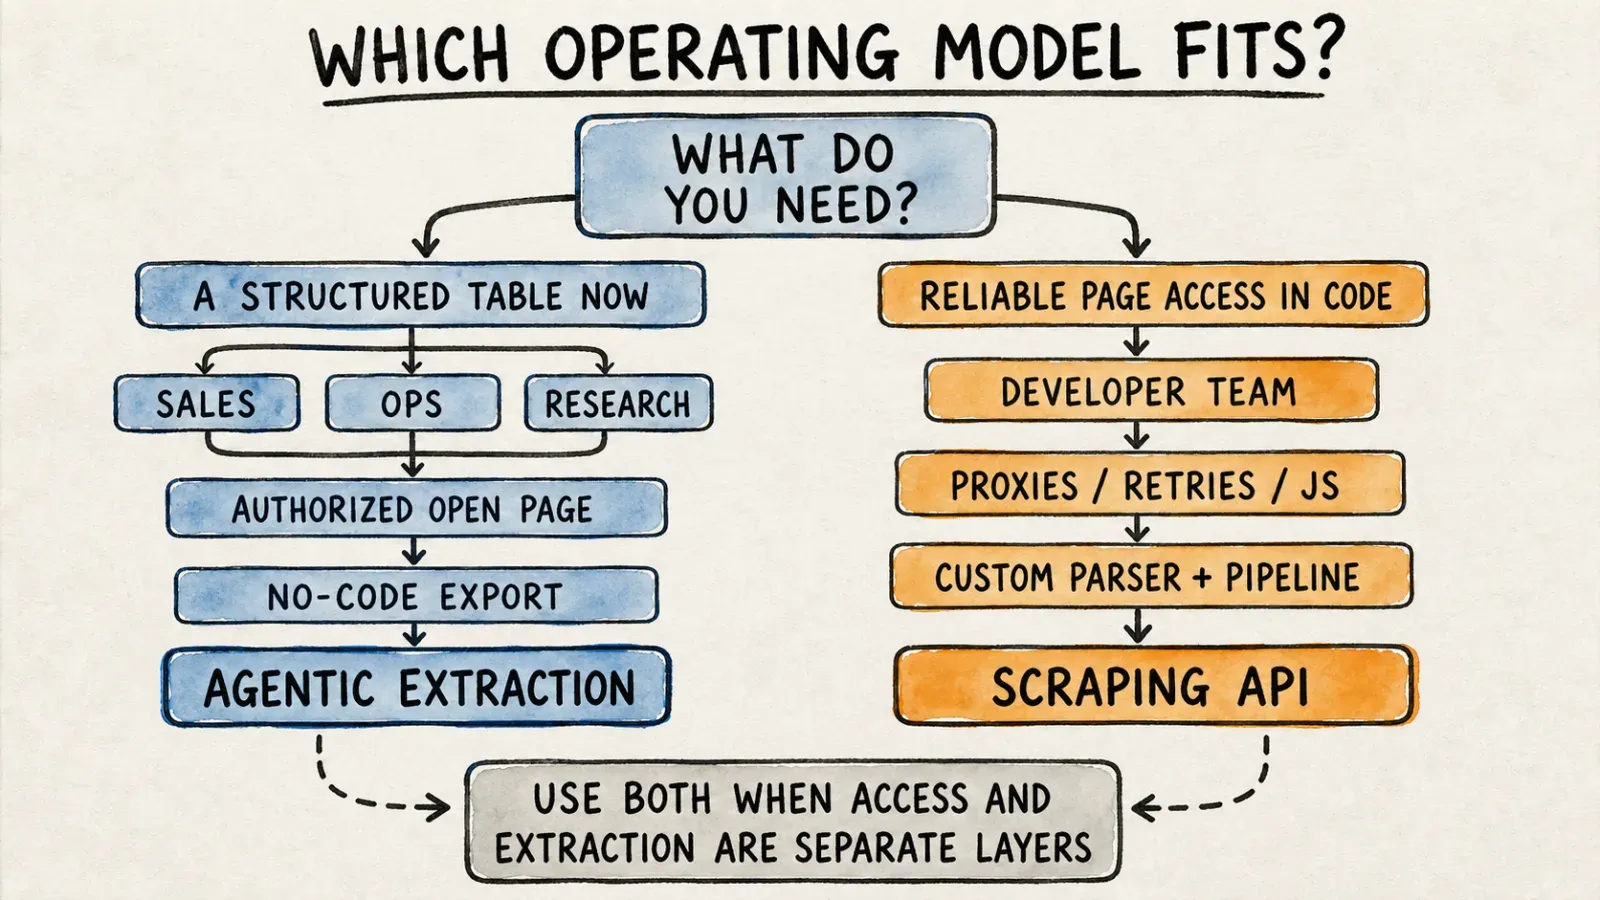
اختر ScraperAPI إذا...
- كنت مطورًا أو فريق هندسة يبني بنية استخراج بيانات على نطاق واسع
- كنت تحتاج إلى تدوير البروكسيات والتعامل مع CAPTCHA مدمجين مباشرة في طلبات الـ API
- كنت مرتاحًا لكتابة منطق الطلبات وتحليل HTML أو JSON الخام
- كانت حالتك تتضمن ملايين الطلبات شهريًا عبر نطاقات متعددة
اختر Thunderbit إذا...
- كنت مستخدم أعمال، أو مسوقًا، أو مسؤول عمليات تحتاج إلى بيانات منظمة من صفحة تراها أصلًا
- كنت تفضّل الضغط على One Click Extract وترك الوكيل يستنتج الحقول بدل كتابة سطر واحد من كود scraping
- كنت تحتاج أن تصل النتائج مباشرة إلى Excel أو Google Sheets أو Airtable أو Notion
- كنت مطورًا تريد طبقة منظمة أسرع للأدوات الداخلية من دون بناء منطق الاستخراج من الصفر
وأكون أول من يعترف بأن هذا ليس قرارًا ثنائيًا للجميع. لقد تحدثت مع فرق تستخدم الأداتين معًا — حيث يتولى فريق الهندسة خط ScraperAPI للبنية التحتية عالية الحجم، بينما يستخدم فريقا المبيعات والتسويق Thunderbit لطلبات «أحتاج هذه القائمة من العملاء المحتملين قبل الخميس» التي كانت ستبقى في طابور الهندسة لأسبوعين. وهذا الجمع منطقي جدًا بمجرد أن تتوقف عن محاولة إجبار أداة واحدة على القيام بعمل الأداة الأخرى.
هل يحل Thunderbit محل ScraperAPI؟ توضيح الالتباس
هذا هو الموضع الذي أرى فيه أكبر قدر من الخلط، وأريد أن أكون مباشرًا بدل أن أدور حول الموضوع لأسباب SEO. الناس يبحثون عن «AI scraper tool» ويضعون كل نتيجة — بما فيها Thunderbit — في الصندوق الذهني نفسه تحت عنوان «بنية استخراج البيانات». لكنه ليس الصندوق نفسه.
Thunderbit هو طبقة استخراج منظمة. صُمم ليحوّل الصفحة التي يمكنك الوصول إليها أصلًا إلى بيانات قابلة للاستخدام والتصدير، باستخدام الذكاء الاصطناعي لتحديد الحقول بدل أن تضطر إلى تعريف schema يدويًا. وهو ليس منتج بنية تحتية لتدوير البروكسيات أو تجاوز الـ anti-bot كما هو الحال مع ScraperAPI. إذا كنت بحاجة إلى اختراق تحديات Cloudflare عبر عشرة آلاف نطاق مختلف يوميًا، فهذه منطقة ScraperAPI، لا Thunderbit.
ومن الزاوية الأخرى، ScraperAPI لا يقدّم اكتشاف الحقول بالذكاء الاصطناعي من دون كود. سيمنحك HTML لصفحة محمية بحماية قوية ضد الروبوتات بكل سرور، لكنك ما زلت أنت من يحدد ما معنى «السعر» أو «المسمى الوظيفي» داخل ذلك الـ HTML، وأنت من يكتب الكود لاستخراجه. لا واحدة من الأداتين تحاول أن تكون الأخرى، وأفضّل أن أوضح لك ذلك صراحةً بدل أن تكتشفه بالطريقة الصعبة بعد ثلاثة أسابيع من بدء المشروع.
بالنسبة لزحف واسع النطاق وعالي المخاطر من حيث الحجب، فإن مجموعة بروكسيات ScraperAPI والتعامل مع anti-bot تبقى الأنسب بشكل مباشر. أما للاستخراج السريع والمنظم من الصفحات التي يمكنك أنت أو فريقك الوصول إليها أصلًا، فإن نهج Thunderbit الذكي مصمم لهذا تمامًا. وللإنصاف تجاه المنتجين، لا ينبغي المبالغة في أيٍّ من الادعاءين — Thunderbit لا تعد بتجاوز كل نظام anti-bot موجود، وادعاءات ScraperAPI حول التوافر والنجاح هي تصريحات ذاتية وليست مُثبتة مستقلًا.
جدول مقارنة الميزات: Thunderbit مقابل ScraperAPI
إضافة إلى اختلافات البنية والتسعير، إليك مقارنة عملية في الأشياء اليومية التي تهم أي فريق فعلًا.
| الميزة | ScraperAPI | Thunderbit |
|---|---|---|
| هل يتطلب برمجة؟ | نعم، في معظم الاستخدامات الواقعية | لا، في مسار إضافة المتصفح |
| صيغة الإخراج | HTML/JSON خام، مع محللات منظمة للمواقع المدعومة | جداول منظمة جاهزة للتصدير |
| خيارات التصدير | يديرها المطور (ابنِ التخزين/التسليم بنفسك) | تصدير إلى Excel وGoogle Sheets وAirtable وNotion |
| الجدولة | متاحة عبر DataPipeline في مسارات العمل المدعومة | متاحة في الخطط والواجهات المدعومة |
| التعامل مع البروكسي/anti-bot | مدمج في كل طلب، وهو ميزة أساسية | ليس الوظيفة الأساسية؛ يركّز على الصفحات المتاحة والمصرح بها |
| واجهات الأتمتة | REST API وDataPipeline ووصول إلى crawler | إضافة متصفح، وWeb App، وOpen API، وMCP Server، وCLI |
| أنسب فريق | الهندسة/العمليات التقنية | المبيعات، والتسويق، والعمليات، والبحث، بالإضافة إلى سير عمل المطورين |
الصف الأخير يختصر القصة كلها تقريبًا في سطر واحد. إذا كانت قناة Slack لفريقك مليئة بالمهندسين، فغالبًا ScraperAPI مفهوم لكم أصلًا. أما إذا كانت القناة مليئة بطلبات من نوع «هل يمكن لأحد أن يضع هذه القائمة في جدول؟»، فهذا هو السبب الدقيق لوجود Thunderbit.
الوصول إلى البيانات، والامتثال، والاستخدام المسؤول
سأُبقي هذا القسم قصيرًا، لأنني لا أعتقد أن أي شركة أو أنا ينبغي أن نقدّم استشارة قانونية. كلا الأداتين تتطلبان منك العمل ببيانات عامة أو بيانات مصرح بها بطريقة أخرى، واحترام ضوابط الوصول على المواقع التي تسحب منها، والالتزام بالقوانين ذات الصلة المتعلقة بالخصوصية، والامتثال لشروط خدمة الموقع المستهدف. لا شبكة البروكسيات في ScraperAPI ولا استخراج Thunderbit بالذكاء الاصطناعي تجعل أي مهمة scraping قانونية أو متوافقة تلقائيًا — فالمسؤولية تقع على من يشغّل الاستخراج، لا على الأداة التي تنفذه. إذا كنت تستخرج بيانات تتضمن معلومات شخصية، أو جلسات دخول، أو موقعًا يتضمن في شروطه بندًا صريحًا «لا للاستخراج»، فهذه محادثة لفريقك القانوني، لا لمربع اختيار في المنتج.
الأسئلة الشائعة: Thunderbit مقابل ScraperAPI
هل لدى Thunderbit API مثل ScraperAPI؟
نعم. يدعم Open API في Thunderbit كلًّا من Distill وStructured Extract لسير العمل البرمجي الموجّه للمطورين. إنها تجربة مختلفة عن إضافة المتصفح بلا كود، ومصممة للفرق التي تريد استدعاء الاستخراج من تطبيقاتها الخاصة أو خطوطها الخلفية.
هل يستطيع Thunderbit التعامل مع CAPTCHA / حظر IP مثل ScraperAPI؟
لا. Thunderbit لا يوفّر بنية تدوير البروكسيات أو تجاوز CAPTCHA التي بُني ScraperAPI حولها. إنه مصمم لاستخراج منظم من صفحات متاحة ومصرح بها — لا لتجاوز أنظمة anti-bot على نطاق واسع.
أيّهما أرخص لـ 10,000 أو 100,000 صفحة؟
الأمر يعتمد فعلًا على السيناريو. المهمة البسيطة ذات الصفحات الثابتة وعلى نطاق كبير تميل إلى تفضيل تسعير البنية التحتية في ScraperAPI عندما تكون على خطة أعلى. أما مهمة الاستخراج المنظم والمتقطع — حيث تكمن القيمة في الجدول النهائي لا في عدد الطلبات الخام — فتميل إلى تفضيل Thunderbit. راجع التفصيل القائم على السيناريو أعلاه قبل الافتراض أن أحدهما أرخص تلقائيًا.
هل Thunderbit بديل جيد لـ ScraperAPI؟
فقط لاحتياجات الاستخراج المنظم بلا كود. إنه ليس بديلًا مباشرًا لبنية البروكسيات أو الـ anti-bot على نطاق واسع، وأفضّل أن أوضح ذلك مسبقًا بدل أن تكتشفه في منتصف المشروع.
هل يمكنني استخدام Thunderbit وScraperAPI معًا؟
تفعل فرق كثيرة ذلك بالفعل — حيث تستخدم الهندسة ScraperAPI للوصول عالي الحجم على مستوى البنية التحتية، بينما تستخدم الفرق التجارية Thunderbit لمهام استخراج منظمة، لمرة واحدة أو متكررة، لا تحتاج إلى سباق هندسي كامل. لا توجد قاعدة تقول إن عليك اختيار واحد فقط.
إن الاختيار بين هاتين الأداتين يعود فعلًا إلى سؤال واحد صادق: هل تبني بنية تحتية، أم أنك تحتاج فقط إلى جدول بيانات قبل نهاية اليوم؟ ScraperAPI هي بنية استخراج للمطورين — بروكسيات، ومعالجة CAPTCHA، والعرض، مصممة للفرق المرتاحة لكتابة منطق الطلبات على نطاق واسع. Thunderbit هي طبقة استخراج ذكية بلا كود صممت لمستخدمي الأعمال والمسوقين والباحثين الذين يحتاجون بيانات منظمة بسرعة من صفحة، مع طبقة API وMCP للمطورين الذين يريدون السرعة نفسها برمجيًا. اختر الأداة التي تطابق المهمة الفعلية أمامك، لا تلك التي تملك صفحة هبوط أكثر بهرجة — وإذا كنت من النوع الذي يفضّل الضغط على زر بدل كتابة scraper اليوم، يمكنك تجربة إضافة Thunderbit على Chrome وترى إلى أي مدى يمكن للنقرة الواحدة أن توصلك.




