
내 Amazon 리뷰 추출 프로그램은 6주 동안 완벽하게 돌아갔다가, 어느 날 아침 갑자기 200 OK만 던져주고는 텅 빈 페이지를 돌려줬다. 오류도 없고, CAPTCHA도 없고, 수백 개의 리뷰가 떠야 할 자리에 HTML만 덩그러니 비어 있었다.
이 장면이 낯설지 않다면, 너만 그런 게 아니다. 2025년 말부터 Amazon은 전체 리뷰 페이지를 로그인 화면 뒤로 막기 시작했고, 수많은 Python 스크립트가 하룻밤 사이에 멈춰 버렸다. 지난 몇 달 동안 나는 Thunderbit에서 이 문제를 양쪽에서 다뤘다. 하나는 우리 자체 AI scraper를 만들면서, 다른 하나는 내가 쓰던 Python 리뷰 파이프라인을 계속 살려 두면서 말이다. 그래서 처음 내 스크립트가 멈췄을 때 있었으면 좋았을 가이드를 지금 써야겠다고 생각했다. 이 글은 실제로 먹히는 실전 방법을 다룬다. 쿠키 기반 인증, Amazon의 CSS 난독화를 버텨내는 안정적인 셀렉터, 10페이지 페이징 한도 우회 방법, 봇 차단 대응, 그리고 원시 리뷰 텍스트를 진짜 비즈니스 인사이트로 바꾸는 감성 분석까지 모두 포함했다. 그리고 중간쯤 읽다가 “이 코드를 내가 다 만지기 싫은데”라고 느낀다면, Thunderbit가 똑같은 일을 Python 없이 2분 만에 처리하는 방법도 보여주겠다.
Amazon 리뷰 추출이란 무엇이고 왜 중요한가?
Amazon 리뷰 추출은 별점, 리뷰 본문, 작성자 이름, 날짜, 구매 인증 배지 같은 고객 리뷰 데이터를 Amazon 상품 페이지에서 프로그램으로 가져오는 작업이다. Amazon이 2010년에 Product Advertising API에서 리뷰 콘텐츠를 제거했고 그 뒤로 다시 돌려주지 않았기 때문에, web scraping은 이 데이터에 접근할 수 있는 사실상 유일한 프로그래밍 방법이다.
숫자도 이걸 뒷받침한다. 구매자의 95%가 구매 전에 리뷰를 읽고, 94%는 Amazon을 제품 리뷰의 1순위 출처로 본다. 상품 페이지에 리뷰 5개만 보여줘도 전환율이 270%까지 오를 수 있다. 리뷰 감성을 체계적으로 분석하는 기업은 고객 유지율이 최대 15% 상승하기도 한다. 이건 단순한 데이터가 아니다. 경쟁 정보이고, 제품 개선 신호이고, 마케팅 문구의 원천이며, 모두 Amazon 서버 어딘가에 텍스트로 그대로 쌓여 있다.
Amazon 리뷰 추출에 Python을 쓰는 이유
이 작업에는 여전히 Python이 가장 많이 쓰인다. 2024년 Stack Overflow 개발자 설문에서 가장 수요가 많은 언어였고, requests, BeautifulSoup, pandas, Scrapy 같은 생태계 덕분에 전문 개발자가 아니어도 web scraping을 시작하기 쉽다.
그리고 팀마다 이 데이터를 활용하는 방식도 제각각이다:
| 팀 | 사용 사례 | 추출하는 내용 |
|---|---|---|
| 제품 / R&D | 반복되는 불만을 찾고 우선순위를 정함 | 1–2성 리뷰 본문, 키워드 반복 빈도 |
| 영업 | 경쟁사 제품에 대한 고객 감정 파악 | 별점, 리뷰 수 추이 |
| 마케팅 | 광고에 쓸 고객 언어 수집 | 긍정적인 리뷰 문구, 기능 언급 |
| 이커머스 운영 | 내 제품 감성을 시간에 따라 추적 | 별점 분포, 구매 인증 비율 |
| 시장 조사 | 기능 기준으로 카테고리 리더 비교 | 여러 ASIN의 리뷰 데이터셋 |
한 생활용품 브랜드는 부정 리뷰를 분석해 22%가 “논스틱 코팅이 벗겨진다”는 내용을 담고 있다는 걸 확인했고, 제품을 다시 손봤고 60일 만에 다시 베스트셀러 1위로 올라갔다. 또 한 피트니스 트래커 회사는 리뷰 텍스트에서 “밴드 자극”이라는 표현을 뽑아내 라텍스 민감성 문제를 찾아냈고, 저자극 버전을 출시해 반품률을 40% 낮췄다. 이런 결과라면 엔지니어링에 시간을 들일 만하다.
로그인 화면: Amazon 리뷰 추출 프로그램이 멈춘 이유
2024년 11월 14일, Amazon은 상품의 전체 리뷰 페이지를 보려면 로그인하도록 요구하기 시작했다. 이 변화는 커뮤니티 포럼과 scraping 제공업체 블로그를 통해 확인됐다. 시크릿 창에서 /product-reviews/{ASIN}/를 열어 보면 리뷰 데이터 대신 로그인 페이지로 튕겨 나간다.
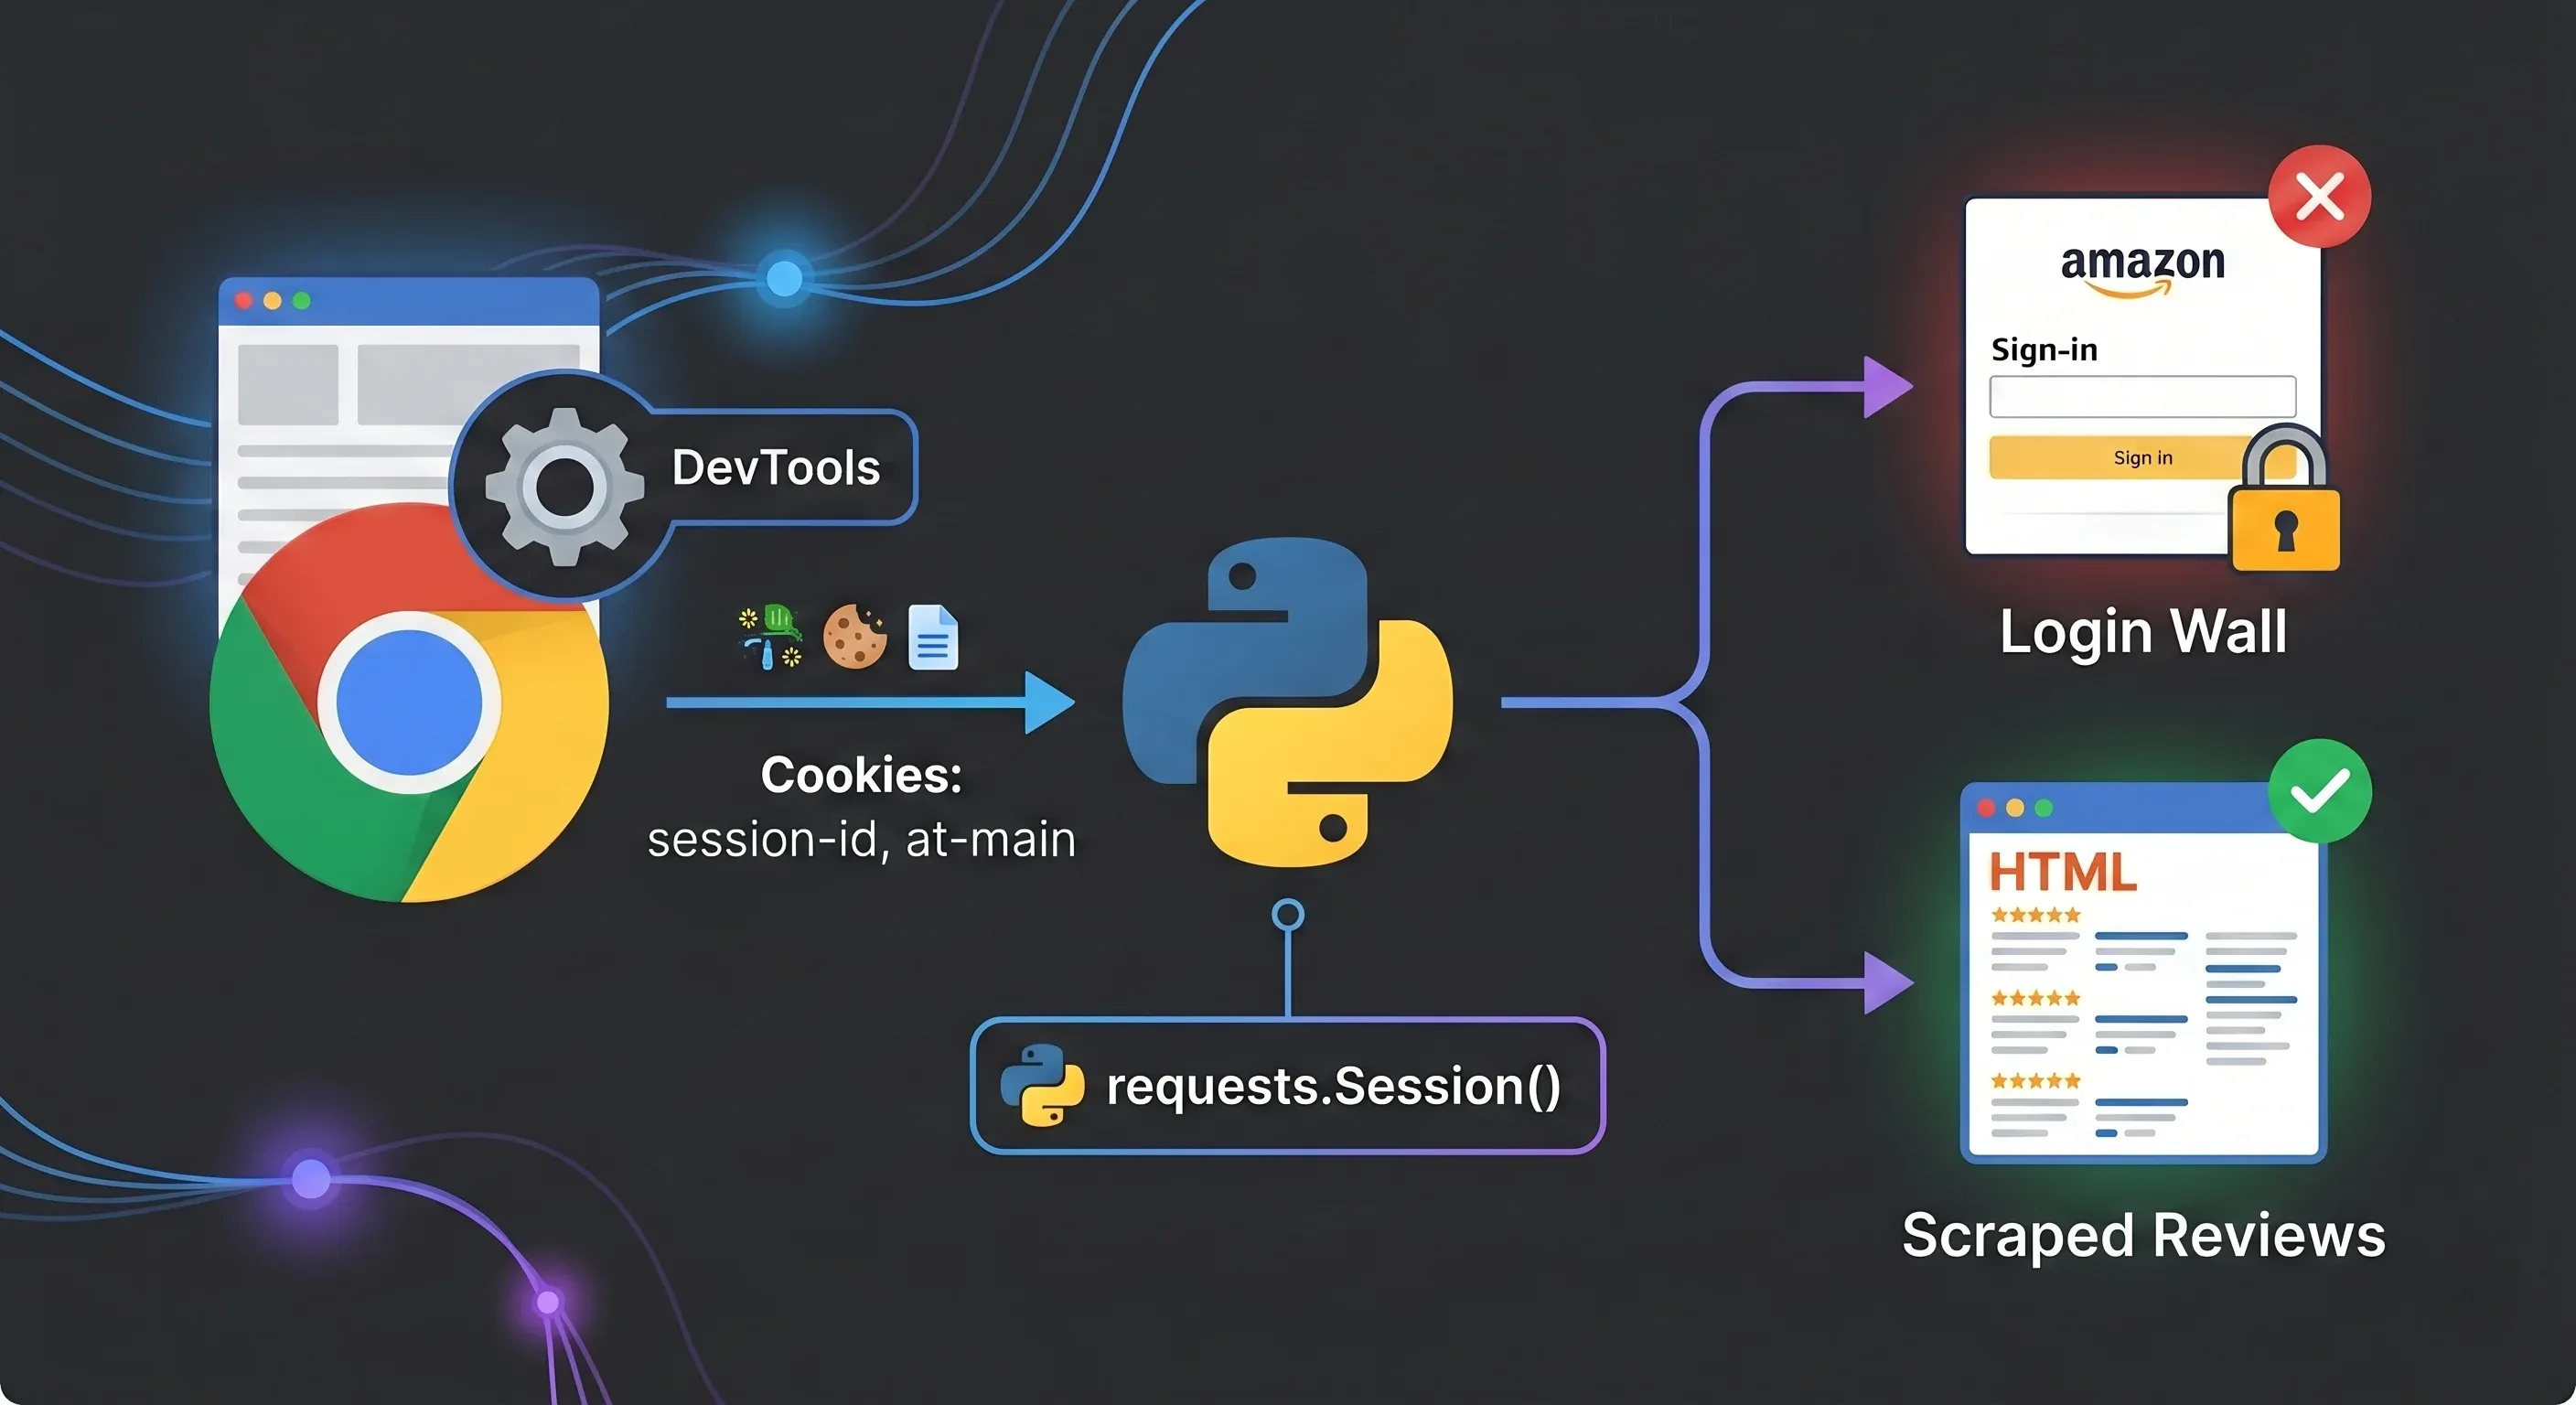
증상이 더 헷갈린다. 스크립트는 200 OK를 돌려주지만, HTML 안에는 리뷰 대신 로그인 폼(name="email", id="ap_password")이 들어 있다. 오류 코드도 없고, CAPTCHA도 없다. 그냥… 쓸모 있는 데이터가 없다.
Amazon이 이렇게 한 이유는 봇 대응과 지역 규정 때문이라고 볼 수 있다. 다만 적용 방식은 일관되지 않다. 특히 첫 페이지에서는 새 브라우저가 리뷰 몇 개를 잠깐 불러오다가 벽에 막히는 경우도 있다. 하지만 대량으로 돌아가는 scraper라면, 이 장벽은 항상 켜져 있다고 가정하는 게 맞다.
또한 국가별 Amazon 도메인(.de, .co.uk, .co.jp)은 각각 별도로 이 장벽을 적용한다. 한 포럼 사용자가 말했듯이, “나라별로 로그인 필요.” 즉, .com 쿠키가 .co.uk에서 통하지 않는다.
추천 리뷰 vs 전체 리뷰: 로그인 없이 어디까지 볼 수 있나
Amazon 상품 페이지(/dp/{ASIN}/)에서는 여전히 인증 없이 약 8개의 “추천 리뷰”를 볼 수 있다. 이 리뷰들은 Amazon 알고리즘이 고른 것이고, 감을 빠르게 잡는 데는 도움이 되지만 정렬, 필터, 페이징은 안 된다.
반면 전체 리뷰 페이지(/product-reviews/{ASIN}/)는 최신순 정렬, 별점 필터, 수백 개 리뷰 탐색을 하려면 로그인이 필요하다.
리뷰 몇 개만 빠르게 훑어보려는 거라면 상품 페이지에서 충분하다. 하지만 수백 개에서 수천 개가 필요하다면 인증을 다뤄야 한다.
시작하기 전에 필요한 것: Python과 라이브러리 세팅
코드를 쓰기 전에 준비할 것부터 보자:
- 난이도: 중급 수준(Python에 익숙하고 HTML 기본 구조를 아는 정도)
- 소요 시간: 전체 흐름 45분 정도, 단순 추출은 10분 정도
- 필수 조건: Python 3.8+, Chrome 브라우저, 유효한 Amazon 계정
기본 라이브러리를 설치하자:
pip install requests beautifulsoup4 lxml pandas textblob
선택 사항(고급 감성 분석용):
pip install transformers torch
ASIN이 뭐냐면? Amazon 상품을 식별하는 10자리 문자열이다. 상품 링크 안에서 찾을 수 있다. 예를 들어 amazon.com/dp/B0BCNKKZ91에서 ASIN은 B0BCNKKZ91이다. 이 값이 리뷰 URL을 만들 때 쓰는 핵심 키다.
1단계: 쿠키 기반 인증으로 로그인 화면을 우회하기
가장 안정적인 방법은 브라우저에서 Amazon에 로그인한 뒤, 세션 쿠키를 복사해서 Python의 requests.Session()에 넣는 것이다. 이렇게 하면 Selenium 자동 로그인 때문에 생기는 CAPTCHA나 SMS 2단계 인증을 피할 수 있다.
필요한 쿠키 7개는 다음과 같다:
| 쿠키 이름 | 용도 |
|---|---|
session-id | 변경 가능한 세션 ID |
session-id-time | 세션 타임스탬프 |
session-token | 변경 가능한 세션 토큰 |
ubid-main | 사용자 브라우징 식별자 |
at-main | 기본 인증 토큰 |
sess-at-main | 기기/세션 연동 인증 |
x-main | 사용자 이메일과 연결된 식별자 |
Chrome DevTools에서 쿠키를 추출하는 방법
- Chrome에서 amazon.com에 로그인한다
- DevTools를 연다(F12 또는 우클릭 → Inspect)
- Application → Storage → Cookies →
https://www.amazon.com으로 이동한다 - 표에 있는 각 쿠키 이름을 찾아 값을 복사한다
- Python에서 쓸 수 있게 세미콜론으로 구분된 문자열 형태로 정리한다
세션은 이렇게 설정한다:
import requests

session = requests.Session()

# 쿠키 값을 여기에 붙여넣기
cookies = {
    "session-id": "YOUR_SESSION_ID",
    "session-id-time": "YOUR_SESSION_ID_TIME",
    "session-token": "YOUR_SESSION_TOKEN",
    "ubid-main": "YOUR_UBID_MAIN",
    "at-main": "YOUR_AT_MAIN",
    "sess-at-main": "YOUR_SESS_AT_MAIN",
    "x-main": "YOUR_X_MAIN",
}

headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/147.0.0.0 Safari/537.36",
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,*/*;q=0.8",
    "Accept-Language": "en-US,en;q=0.5",
}

session.cookies.update(cookies)
session.headers.update(headers)
중요: 모든 요청에서 같은 session 객체를 재사용해야 한다. 그래야 쿠키가 일관되게 유지되고, 진짜 브라우저 세션에 더 가까운 행동이 된다. 보통 쿠키는 며칠에서 몇 주 정도는 버티지만, 다시 로그인 페이지로 리다이렉트되기 시작하면 브라우저에서 새로 갱신해야 한다.
.com이 아닌 마켓플레이스는 쿠키 이름이 조금 달라진다. 예를 들어 amazon.de는 at-main 대신 at-acbde를 쓰고, amazon.co.uk는 at-acbuk를 쓴다. 즉, 마켓마다 별도 세션이 필요하다.
2단계: 요청을 만들고 BeautifulSoup로 리뷰 HTML 파싱하기
Amazon 리뷰 URL 형식은 다음과 같다:
https://www.amazon.com/product-reviews/{ASIN}/ref=cm_cr_arp_d_viewopt_srt?sortBy=recent&pageNumber=1
핵심 함수는 이렇다:
from bs4 import BeautifulSoup
import time, random

def get_soup(session, url):
    time.sleep(random.uniform(2, 5))  # 예의 있는 딜레이
    response = session.get(url, timeout=15)

    # 로그인 화면 감지
    if "ap_email" in response.text or "Amazon Sign-In" in response.text:
        raise Exception("로그인 화면이 감지됨 — 쿠키를 갱신하세요")

    if response.status_code != 200:
        raise Exception(f"HTTP {response.status_code}")

    return BeautifulSoup(response.text, "lxml")
작게나마 효과 있는 팁이 하나 있다. 리뷰 페이지로 바로 가지 말고, 먼저 상품 페이지를 열어라. 그러면 세션 안에 자연스러운 브라우징 패턴이 만들어진다.
# 먼저 상품 페이지 열기(자연스러운 탐색처럼 보이게)
product_url = f"https://www.amazon.com/dp/{asin}"
session.get(product_url, timeout=15)
time.sleep(random.uniform(1, 3))

# 그다음 리뷰 페이지로 이동
reviews_url = f"https://www.amazon.com/product-reviews/{asin}/ref=cm_cr_arp_d_viewopt_srt?sortBy=recent&pageNumber=1"
soup = get_soup(session, reviews_url)
3단계: 안정적인 셀렉터로 리뷰 데이터를 뽑아내기(CSS class 의존은 이제 그만)
여기서 2022~2023년 글 대부분이 무너진다. Amazon은 CSS class 이름을 숨기고 주기적으로 바꾼다. 어떤 개발자는 포럼에서 “span 요소의 class 이름에 일정한 패턴이 전혀 없었다”고 한탄했다.
해법은 이거다. Amazon은 리뷰 요소에 data-hook 속성을 쓴다. 이 값은 꽤 안정적이다. Amazon 프런트엔드가 의존하는 의미 있는 식별자라서 함부로 바뀌지 않는다.
| 리뷰 필드 | 안정적인 셀렉터 (data-hook) | 불안정한 셀렉터 (class) |
|---|---|---|
| 리뷰 본문 | [data-hook="review-body"] | .review-text-content (자주 바뀜) |
| 별점 | [data-hook="review-star-rating"] | .a-icon-alt (애매함) |
| 리뷰 제목 | [data-hook="review-title"] | .review-title (가끔만 맞음) |
| 작성자 | span.a-profile-name | 비교적 안정적 |
| 리뷰 날짜 | [data-hook="review-date"] | .review-date (지역별 차이 있음) |
| 구매 인증 | [data-hook="avp-badge"] | span.a-size-mini |
data-hook 셀렉터를 쓰는 추출 코드는 이렇게 생겼다:
import re

def extract_reviews(soup):
    reviews = []
    review_divs = soup.select('[data-hook="review"]')

    for div in review_divs:
        # 별점
        rating_el = div.select_one('[data-hook="review-star-rating"]')
        rating = None
        if rating_el:
            rating_text = rating_el.get_text(strip=True)
            match = re.search(r'(\d\.?\d?)', rating_text)
            if match:
                rating = float(match.group(1))

        # 제목
        title_el = div.select_one('[data-hook="review-title"]')
        title = title_el.get_text(strip=True) if title_el else ""

        # 본문
        body_el = div.select_one('[data-hook="review-body"]')
        body = body_el.get_text(strip=True) if body_el else ""

        # 작성자
        author_el = div.select_one('span.a-profile-name')
        author = author_el.get_text(strip=True) if author_el else ""

        # 날짜와 국가
        date_el = div.select_one('[data-hook="review-date"]')
        date_text = date_el.get_text(strip=True) if date_el else ""
        # 형식: "Reviewed in the United States on January 15, 2025"
        country_match = re.search(r'Reviewed in (.+?) on', date_text)
        date_match = re.search(r'on (.+)$', date_text)
        country = country_match.group(1) if country_match else ""
        date = date_match.group(1) if date_match else ""

        # 구매 인증
        verified_el = div.select_one('[data-hook="avp-badge"]')
        verified = bool(verified_el)

        reviews.append({
            "author": author,
            "rating": rating,
            "title": title,
            "content": body,
            "date": date,
            "country": country,
            "verified": verified,
        })

    return reviews
나는 이 셀렉터 조합을 여러 ASIN에 몇 달째 돌리고 있는데, data-hook 속성은 한 번도 안 바뀌었다. 반면 CSS class는 그 기간 동안 최소 두 번 바뀌었다.
4단계: 페이징 처리와 Amazon의 10페이지 한도 다루기
Amazon은 pageNumber를 최대 10페이지까지만 허용하고, 페이지당 리뷰는 10개다. 즉, 필터 한 조합당 최대 약 100개 리뷰가 한계다. 10페이지를 넘기면 “Next page” 버튼도 사라진다.
기본 페이징 루프는 다음과 같다:
all_reviews = []

for page in range(1, 11):
    url = f"https://www.amazon.com/product-reviews/{asin}/ref=cm_cr_arp_d_viewopt_srt?sortBy=recent&pageNumber={page}"
    soup = get_soup(session, url)
    page_reviews = extract_reviews(soup)

    if not page_reviews:
        break  # 이 페이지에 더 이상 리뷰가 없음

    all_reviews.extend(page_reviews)
    print(f"페이지 {page}: {len(page_reviews)}개 리뷰")
Amazon 리뷰를 10페이지 이상 가져오는 방법
핵심은 필터 조합이다. filterByStar와 sortBy의 각 조합이 독립된 10페이지 창을 만든다.
별점 필터 값: one_star, two_star, three_star, four_star, five_star
정렬 값: recent, helpful(기본값)
5개의 별점 필터 × 2개의 정렬을 쓰면 최대 100페이지, 즉 상품당 1,000개 리뷰까지 접근할 수 있다. 그리고 별점 분포가 치우친 상품이라면 거의 전체 리뷰셋에 가까워지는 경우도 많다.
star_filters = ["one_star", "two_star", "three_star", "four_star", "five_star"]
sort_orders = ["recent", "helpful"]
all_reviews = []
seen_titles = set()  # 간단한 중복 제거

for star in star_filters:
    for sort in sort_orders:
        for page in range(1, 11):
            url = (
                f"https://www.amazon.com/product-reviews/{asin}"
                f"?filterByStar={star}&sortBy={sort}&pageNumber={page}"
            )
            soup = get_soup(session, url)
            page_reviews = extract_reviews(soup)

            if not page_reviews:
                break

            for review in page_reviews:
                # 리뷰 제목 + 작성자로 중복 제거
                key = (review["title"], review["author"])
                if key not in seen_titles:
                    seen_titles.add(key)
                    all_reviews.append(review)

            print(f"[{star}/{sort}] 페이지 {page}: {len(page_reviews)}개 리뷰")

print(f"총 고유 리뷰 수: {len(all_reviews)}")
이 조합들 사이에는 겹치는 리뷰가 많기 때문에 중복 제거가 필수다. 나는 빠르게 (제목, 작성자) 조합을 키로 쓴다. 완벽하진 않지만 대부분의 중복은 잡아낸다.
5단계: 봇 차단 방어 피하기(로테이션, 속도 조절, 재시도)
Amazon은 AWS WAF Bot Control을 쓰고 있고, 점점 더 엄격해지고 있다. User-Agent만 돌리거나 딜레이만 넣는 단일 전략은 이제 잘 안 먹힌다.
| 전략 | 구현 방법 |
|---|---|
| User-Agent 로테이션 | 10개 이상 실제 브라우저 문자열 중 무작위 선택 |
| 지수 백오프 | 503 발생 시 2s → 4s → 8s 재시도 지연 |
| 요청 속도 완화 | 페이지 사이에 random.uniform(2, 5)초 대기 |
| 프록시 로테이션 | residential proxy 간 전환 |
| 세션 지문 일관성 | 세션마다 쿠키와 헤더를 고정 |
| TLS 위장 | 운영 환경에서는 일반 requests 대신 curl_cffi 사용 |
바로 써먹을 수 있는 재시도 래퍼는 아래와 같다:
import time, random

USER_AGENTS = [
    "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/147.0.0.0 Safari/537.36",
    "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/147.0.0.0 Safari/537.36",
    "Mozilla/5.0 (Windows NT 10.0; Win64; x64; rv:149.0) Gecko/20100101 Firefox/149.0",
    "Mozilla/5.0 (Macintosh; Intel Mac OS X 15_7_5) AppleWebKit/605.1.15 (KHTML, like Gecko) Version/26.0 Safari/605.1.15",
    "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/146.0.0.0 Safari/537.36",
]

def scrape_with_retries(session, url, max_retries=3):
    for attempt in range(max_retries):
        try:
            session.headers["User-Agent"] = random.choice(USER_AGENTS)
            time.sleep(random.uniform(2, 5))

            response = session.get(url, timeout=15)

            # 차단 감지
            if "validateCaptcha" in response.url or "Robot Check" in response.text:
                wait = (2 ** attempt) * 5
                print(f"CAPTCHA 감지됨. {wait}초 대기...")
                time.sleep(wait)
                continue

            if response.status_code in (429, 503):
                wait = (2 ** attempt) * 2
                print(f"요청 제한 감지({response.status_code}). {wait}초 대기...")
                time.sleep(wait)
                continue

            if "ap_email" in response.text:
                raise Exception("로그인 화면이 나옴 — 쿠키가 만료됨")

            return BeautifulSoup(response.text, "lxml")

        except Exception as e:
            if attempt == max_retries - 1:
                raise
            print(f"{attempt + 1}번째 시도 실패: {e}")

    return None
프록시에 대한 한마디: Amazon은 AWS, GCP, Azure, DigitalOcean 같은 데이터센터 IP를 네트워크 수준에서 차단한다. 몇 백 페이지 이상 수집한다면 residential proxy가 사실상 필수에 가깝고, 규모에 따라 월 50~200달러 이상이 들 수 있다. 반면 소규모 작업(하루 100요청 미만)이라면 집 인터넷 IP로 조심스럽게 속도만 조절해도 버틴다.
Amazon은 TLS 지문도 본다. Python의 기본 requests는 자주 차단되는 JA3 해시를 쓴다. 운영용 scraper라면 실제 브라우저 TLS처럼 위장하는 curl_cffi를 고려하자. 학습용 소규모 작업이라면, 괜찮은 헤더와 함께 requests로도 보통 충분하다.
6단계: 추출한 Amazon 리뷰를 CSV나 Excel로 내보내기
리뷰를 모았다면 pandas로 바로 사용 가능한 형식으로 바꾸는 건 쉽다:
import pandas as pd

df = pd.DataFrame(all_reviews)
df.to_csv("amazon_reviews.csv", index=False)
print(f"{len(df)}개 리뷰를 amazon_reviews.csv로 내보냈습니다")
예시 결과:
| author | rating | title | content | date | country | verified |
|---|---|---|---|---|---|---|
| Sarah M. | 5.0 | 올해 최고의 구매 | 배터리가 하루 종일 가고, 화면이 정말 인상적이다... | January 15, 2025 | the United States | True |
| Mike T. | 2.0 | 2주 만의 실망 | 충전 포트가 작동을 멈췄다... | February 3, 2025 | the United States | True |
| Priya K. | 4.0 | 가격 대비 아주 좋음 | 필요한 건 다 하지만, 무거운 앱에서는 약간 느리다... | March 10, 2025 | the United States | False |
Excel로 내보내려면 df.to_excel("amazon_reviews.xlsx", index=False)를 쓰면 된다. 단, openpyxl이 필요하다.
Google Sheets는 gspread로 연결할 수 있지만, Google Cloud 설정만 8단계 이상 필요하다. 프로젝트 생성, API 활성화, 서비스 계정 자격 증명 만들기, 시트 공유까지 해야 한다. 이게 작업 자체보다 더 번거롭게 느껴진다면, 그건 맞는 판단이다. 그래서 바로 Thunderbit처럼 Google Sheets로 원클릭 내보내기를 해주는 도구가 더 매력적일 수 있다.
보너스: Python 5줄로 리뷰에 감성 분석 추가하기
대부분의 scraping 글은 CSV 저장에서 끝난다. 하지만 감성 분류를 넣어야 원시 데이터가 비즈니스 의사결정으로 바뀐다.
가장 단순한 시작점은 TextBlob이다:
from textblob import TextBlob

df["sentiment"] = df["content"].apply(lambda x: TextBlob(str(x)).sentiment.polarity)
이렇게 하면 각 리뷰마다 -1.0(매우 부정적)에서 +1.0(매우 긍정적) 사이의 점수가 나온다. 예시는 다음과 같다:
| content (truncated) | rating | sentiment |
|---|---|---|
| "배터리가 하루 종일 가고, 화면이 정말 인상적이다..." | 5.0 | 0.65 |
| "충전 포트가 작동을 멈췄다..." | 2.0 | -0.40 |
| "필요한 건 다 하지만, 조금 느리다..." | 4.0 | 0.25 |
| "정말 별로다. 바로 반품했다." | 1.0 | -0.75 |
| "괜찮다. 특별하진 않지만 작동한다." | 3.0 | 0.10 |
가장 흥미로운 건 불일치 사례다. 3성인데 문장은 긍정적이거나, 5성인데 표현은 부정적인 경우 말이다. 이런 차이는 별점만으로는 놓치기 쉬운 아주 미묘한 고객 의견을 드러낸다.
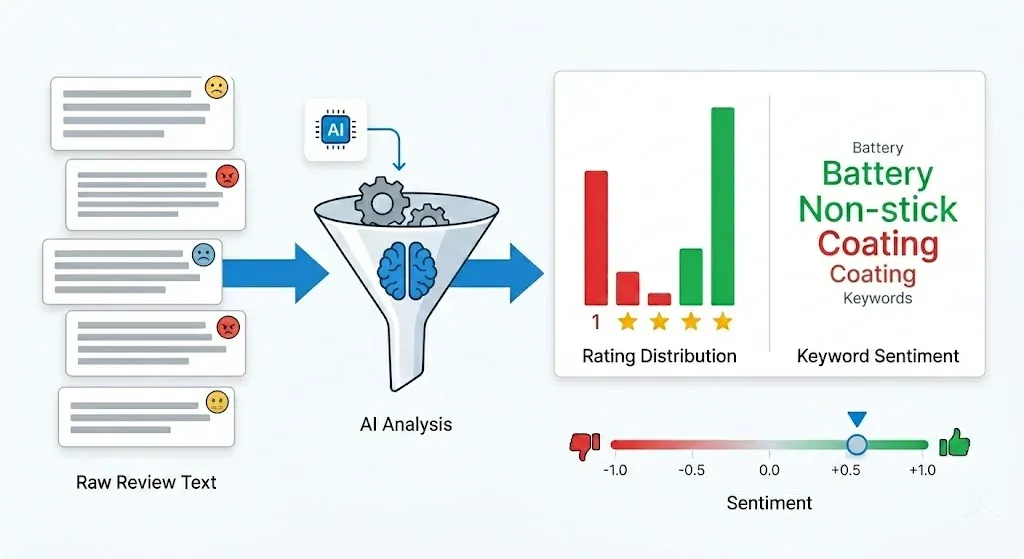
운영 수준의 정확도를 원한다면 Hugging Face Transformers를 추천한다. VADER는 트윗용으로 학습됐지 제품 리뷰용은 아니다. 반면 transformer 모델은 리뷰 감성 분류에서 98%가 넘는 정확도를 보이기도 한다. nlptown/bert-base-multilingual-uncased-sentiment 모델은 1~5성 점수를 바로 예측한다:
from transformers import pipeline

clf = pipeline("sentiment-analysis",
               model="nlptown/bert-base-multilingual-uncased-sentiment")
df["predicted_stars"] = df["content"].apply(
    lambda x: int(clf(str(x)[:512])[0]["label"][0])
)
Amazon 리뷰는 J자형 분포를 보인다. 5성에서 큰 봉우리, 1성에서 작은 봉우리, 가운데는 골짜기다. 그래서 평균 별점만으로는 실제 품질을 잘 설명하지 못하는 경우가 많다. 1성 리뷰 덩어리를 쪼개서 반복되는 주제를 뽑아보면, 고칠 수 있는 단 하나의 핵심 결함이 숨어 있는 경우가 많다.
솔직한 비교: 직접 Python 작성 vs 유료 scraping API vs Thunderbit
나는 Amazon용 Python scraper를 직접 운영해 봤는데, 솔직히 말해 자주 깨진다. 셀렉터가 바뀌고, 쿠키가 만료되고, Amazon이 새 봇 탐지층을 추가하면 어느새 토요일 아침이 scraper 고치는 데 다 날아간다. 포럼 사용자들도 같은 좌절을 말한다. “지난달엔 됐던” DIY 스크립트가 이제는 계속 패치가 필요하다는 것이다.
세 가지 주요 접근을 비교하면 이렇다:
| 기준 | Python 직접 작성(BS4/Selenium) | 유료 scraping API | Thunderbit(노코드) |
|---|---|---|---|
| 초기 설정 시간 | 1–3시간 | 30분(API 키) | 2분 |
| 비용 | 무료(+ 프록시 비용) | 월 50–200달러 이상 | 무료 플랜 있음 |
| 로그인 화면 대응 | 쿠키 수동 관리 | 대부분 처리됨 | 자동 처리 |
| 유지보수 | 높음(셀렉터가 깨짐) | 낮음(제공업체가 관리) | 거의 없음(AI가 적응) |
| 페이징 | 직접 코드 필요 | 내장됨 | 내장됨 |
| 다국가 지원 | 도메인별 별도 세션 | 대부분 지원 | 브라우저 기반이라 지역별 처리 |
| 감성 분석 | 직접 코드 추가 | 때로는 내장 | Sheets로 보내서 원하는 곳에서 분석 |
| 최적 대상 | 학습, 완전한 제어 | 대규모 운영 파이프라인 | 빠른 데이터 수집, 비기술 팀 |
Python은 완전한 제어권을 준다. web scraping이 내부적으로 어떻게 돌아가는지 이해하는 데도 가장 좋은 방법이다. 반면 ScrapingBee, Oxylabs, Bright Data 같은 유료 API는 안정성이 비용보다 중요할 때 좋은 선택이다. 그리고 매주 경쟁사 리뷰를 확인해야 하는 이커머스 운영팀이나, 광고 문구에 쓸 고객 언어를 모으는 마케팅팀처럼 개발 부담 없이 리뷰 데이터가 필요한 팀이라면, 세 번째 길이 있다.
Thunderbit로 Amazon 리뷰를 추출하는 방법(코드 없이, 유지보수 없이)
우리는 Thunderbit를, Python scraper 유지보수가 얻는 가치보다 더 피곤하게 느껴지는 상황을 위해 만들었다. 흐름은 아주 단순하다:
- Thunderbit Chrome Extension 설치
- 브라우저에서 Amazon 상품 리뷰 페이지로 이동(이미 로그인되어 있으니 로그인 화면 문제 없음)
- AI Suggest Fields 클릭 — Thunderbit가 페이지를 읽고 Author, Rating, Title, Review Text, Date, Verified Purchase 같은 열을 제안
- Scrape 클릭 — 내장 페이징 지원과 함께 바로 데이터 추출
- Excel, Google Sheets, Airtable, Notion으로 내보내기
핵심은 Thunderbit의 AI가 매번 페이지 구조를 다시 읽는다는 점이다. 유지보수할 CSS selector도 없고, 쿠키 관리도 없고, 봇 대응 코드도 없다. Amazon이 HTML을 바꾸면 AI가 그에 맞게 적응한다. 코드 없이도 프로그래밍 방식 접근이 필요하다면, Thunderbit는 Extract API도 제공한다. AI 필드 감지와 셀렉터 유지보수 없는 구조화 데이터 추출을 API로 쓸 수 있다.
Amazon 데이터에 더 깊이 들어가고 싶다면 Amazon 상품 및 리뷰 추출 방법과 Amazon 판매 데이터 추출 및 분석 가이드도 참고해 보자.
Python으로 Amazon 리뷰를 대량 추출할 때 유용한 팁
여러 ASIN에서 리뷰를 모을 거라면, 몇 가지 습관만으로도 골칫거리를 크게 줄일 수 있다:
- ASIN 단위로 묶어서 수집하되, 제품 사이에 쉬어라. 페이지 사이가 아니라 제품 사이에도 간격을 둔다. 나는 ASIN마다 10~15초 정도 쉰다.
- 중복 제거를 강하게 하라. 별점 필터와 정렬 조합을 여러 개 쓰면 겹치는 리뷰가 많이 나온다.
(title, author, date)형태의 튜플을 중복 제거 키로 쓰면 좋다. - 실패를 로그로 남겨라. 어떤 ASIN + page + filter 조합이 실패했는지 기록해야 나중에 전체를 다시 돌리지 않고 재시도할 수 있다.
- 대규모 프로젝트는 DB에 저장하라. 단순 SQLite 데이터베이스가 계속 커지는 CSV보다 훨씬 낫다:
import sqlite3

conn = sqlite3.connect("reviews.db")
df.to_sql("reviews", conn, if_exists="append", index=False)
- 정기 수집은 스케줄링하라. 지속 모니터링이 필요하다면 cron job을 돌리거나 Thunderbit의 Scheduled Scraper를 쓰면 된다. URL과 일정만 정하면, 서버 없이도 나머지는 알아서 처리된다.
더 많은 방법은 최고의 자동 web scraping 도구와 웹사이트 데이터를 Excel로 추출하는 방법 글에서 확인할 수 있다.
법적·윤리적 측면에 대한 짧은 참고
Amazon의 Conditions of Use는 “로봇, 스파이더, scraper 또는 기타 자동화된 수단으로 Amazon 서비스에 접근하는 행위”를 명시적으로 금지한다. 하지만 최근 미국 판례는 공개 데이터 추출에 더 우호적이었다. Meta Platforms v. Bright Data(2024년 1월) 사건에서 연방법원은 로그인한 “사용자”가 아닌 경우, 공개 데이터를 추출하는 것이 서비스 약관 위반이 아니라고 판단했다.
여기서 중요한 차이가 있다. 이 가이드가 다루는 것처럼 로그인 뒤에서 추출하는 행위는 계약법 영역으로 들어간다. 계정을 만들 때 Amazon 약관에 동의했기 때문이다. 반면 공개된 리뷰만 추출하는 경우는 로그인 뒤를 뚫는 것보다 법적 위험이 낮다.
실무적으로는, 추출한 데이터를 상업적으로 재배포하지 말고, 공개된 범위를 넘는 개인정보를 가져오지 말며, robots.txt를 존중하고, 상업적이거나 대규모 사용이라면 법률 자문을 받아라. 이건 법률 조언이 아니다. 더 자세한 내용은 웹 scraping의 법적 영향 글을 참고하면 된다.
결론: Python으로 Amazon 리뷰를 추출하거나, 아예 코드를 쓰지 않아도 된다
이 가이드의 핵심을 정리하면 이렇다:
- 로그인 화면은 실제로 존재하지만, 쿠키 기반 인증으로 우회할 수 있다 — 브라우저에서 7개 쿠키를 복사해
requests.Session()에 넣으면 된다 - 몇 주마다 깨지는 CSS class 대신
data-hook셀렉터를 써라 - 별점 필터와 정렬 조합을 섞어서 10페이지 한도를 넘어 500개 이상의 리뷰를 확보하라
- 감성 분석은 TextBlob으로 빠르게 시작하고, 운영 수준 정확도가 필요하면 Hugging Face Transformers를 써라
- 봇 차단 방어를 유지하라: 속도 완화, User-Agent 로테이션, 지수 백오프, 그리고 확장 시 residential proxy
Python은 완전한 통제권을 준다. 내부가 어떻게 돌아가는지 배우기에도 가장 좋다. 하지만 네 목표가 “생산용 파이프라인을 만들기”가 아니라 “금요일 전까지 경쟁사 리뷰를 스프레드시트로 받아보기”라면, 커스텀 scraper 유지보수는 그만한 가치가 없을 수 있다.
Thunderbit는 인증, 셀렉터, 페이징, 내보내기를 몇 번의 클릭으로 처리한다. 무료 플랜을 써 보고 작업 흐름에 맞는지 확인해 보자. Amazon이 봇 방어를 계속 강화하는 지금, 실시간으로 적응하는 AI 도구는 단순한 편의 기능이 아니라 점점 필수가 되고 있다.
시각적으로 보고 싶다면 Thunderbit YouTube 채널에서 scraping 튜토리얼도 볼 수 있다.
자주 묻는 질문
1. 로그인 없이 Amazon 리뷰를 추출할 수 있나?
가능하긴 하지만, 상품 상세 페이지(/dp/{ASIN}/)에 보이는 약 8개의 “추천 리뷰” 정도만 된다. 정렬, 필터, 페이징이 가능한 전체 리뷰 페이지는 2024년 말부터 인증이 필요하다. 대부분의 상업적 사용 사례에서는 로그인 화면을 다뤄야 한다.
2. Amazon 리뷰 추출은 합법인가?
Amazon 약관은 자동 추출을 금지한다. 다만 최근 미국 판례들(Meta v. Bright Data, 2024; hiQ v. LinkedIn)은 공개 데이터 추출을 어느 정도 지지한다. 로그인 뒤에서의 추출은 Amazon 약관에 동의한 상태이기 때문에 법적 위험이 더 높다. 상업적 사용이라면 법률 검토를 받아라.
3. 상품당 몇 개의 Amazon 리뷰를 추출할 수 있나?
Amazon은 별점 필터와 정렬 조합마다 10페이지로 제한한다. 5개의 별점 필터와 2개의 정렬을 모두 쓰면 최대 100페이지, 즉 상품당 약 1,000개 리뷰까지 갈 수 있다. 키워드 필터까지 활용하면 이론상 더 늘어나지만, 중복도 많아진다.
4. Amazon 리뷰 추출에 가장 좋은 Python 라이브러리는?
정적 HTML에는 requests와 BeautifulSoup 조합이 가장 흔하고 안정적이다. JavaScript 실행이 필요하면 Selenium이 유용하다. 로그인 화면과 페이징을 자동 처리하는 노코드 대안이 필요하다면 Thunderbit를 써 보자.
5. Amazon 추출 중 차단을 피하려면 어떻게 해야 하나?
10개 이상의 실제 브라우저 User-Agent를 돌리고, 요청 사이에 2~5초의 랜덤 딜레이를 넣고, 503/429 오류에는 지수 백오프를 적용하고, 대규모 작업에서는 residential proxy를 쓰고(데이터센터 IP는 미리 막히는 경우가 많다), 세션 쿠키를 요청마다 일관되게 유지하라. 유지보수 없는 방식이 필요하다면 Thunderbit가 브라우저 세션을 통해 봇 방어를 자동으로 처리한다.
더 알아보기



