
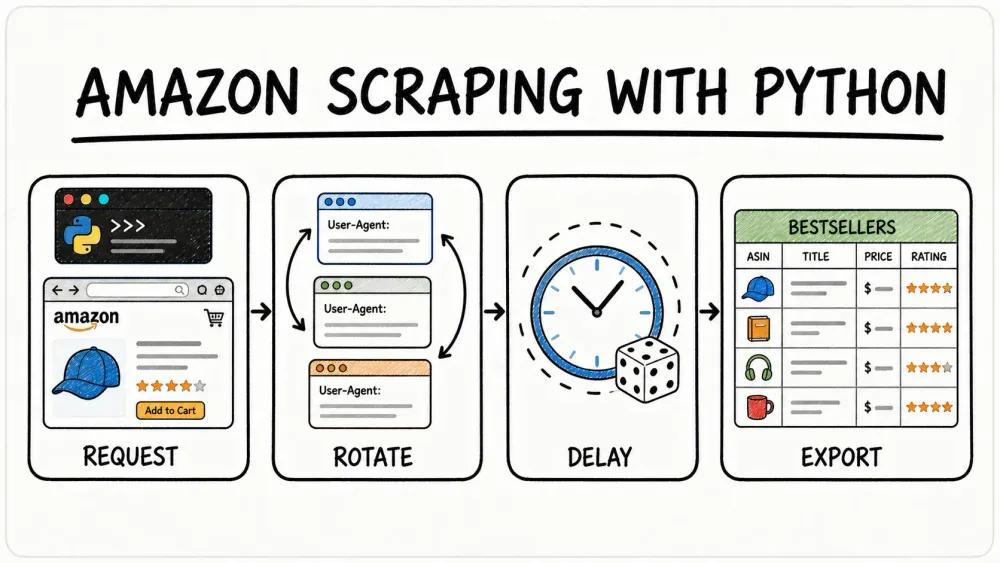
في عطلة نهاية الأسبوع الماضية، صرفت تقريبًا برميل قهوة كامل وأنا أجرّب أربع طرق مختلفة لاستخراج بيانات صفحة "الأكثر مبيعًا" في Amazon. طريقتان اشتغلتا بشكل ممتاز، وحدة منها كادت تودّعني بحظر عنوان IP، ووحدة ثانية احتاجت حرفيًا إلى نقرة واحدة فقط. وهذه خلاصة كل اللي تعلمته.
Amazon سوق هائل بكل معنى الكلمة — 600 مليون قائمة منتجات، وأكثر من 310 مليون حساب عميل نشط، ونظام Best Sellers Rank (BSR) يتحدّث كل ساعة. إذا كنت تشتغل في أبحاث منتجات FBA، أو تحليل التسعير التنافسي، أو حتى تحاول تلتقط الترند قبل منافسينك، فبيانات الأكثر مبيعًا تعتبر ذهب حقيقي.
لكن سحب هذه البيانات من Amazon إلى جدول بيانات؟ هنا تبدأ القصة تتعقّد. جرّبت requests + BeautifulSoup، وSelenium، وواجهة برمجة تطبيقات للاستخراج، وThunderbit (أداة AI Web Scraper بدون كود منّا) عشان أشوف أي نهج يشتغل فعلًا — وأيها بيخلّيك قدام صفحة CAPTCHA.
ما هي Amazon Best Sellers ولماذا ينبغي أن تهتم بها؟
Best Sellers Rank (BSR) في Amazon هو جدول ترتيب لحظي يفرز المنتجات حسب حجم المبيعات داخل كل فئة. تقدر تعتبره سباق شعبية يتجدد كل ساعة، ويعتمد على بيانات المبيعات الحديثة والتاريخية معًا. وAmazon نفسها تشرح ذلك بهذا الشكل:
"يعتمد احتساب Amazon Best Sellers على مبيعات Amazon ويتم تحديثه كل ساعة ليعكس المبيعات الحديثة والتاريخية لكل عنصر يُباع على Amazon." — Amazon Seller Central
صفحة Best Sellers تعرض أفضل 100 منتج في كل فئة، مقسّمة على صفحتين، 50 منتجًا في كل صفحة. الصفحة الأولى من #1 إلى #50، والثانية من #51 إلى #100. وAmazon أكدت أيضًا أن عدد زيارات الصفحة ومراجعات العملاء لا يؤثران على BSR — العامل كله يعتمد على المبيعات.
مين يهتم بهذه البيانات؟ باعة التجارة الإلكترونية الذين يدورون على منتجات FBA، وفرق المبيعات التي تبني ذكاءً تنافسيًا، وفرق العمليات التي تراقب اتجاهات التسعير، وباحثو السوق الذين يتابعون نمو الفئات. ومن تجربتي، أي شخص يبيع على Amazon أو ينافسها ينتهي به الأمر محتاج هذه البيانات داخل جدول بيانات.
لماذا نستخدم Python لاستخراج Amazon Best Sellers؟
البحث اليدوي عن المنتجات يأخذ وقتًا طويلًا. فقد وجدت دراسة لـ McKinsey أن الموظفين يقضون 9.3 ساعات أسبوعيًا فقط في البحث عن المعلومات وجمعها. وبالنسبة لفرق التجارة الإلكترونية، يعني هذا ساعات من التنقّل بين صفحات Amazon، ونسخ أسماء المنتجات والأسعار، ولصقها في الجداول — ثم إعادة نفس الدورة في الأسبوع التالي.
إليك لمحة سريعة عن حالات الاستخدام التي تجعل استخراج Best Sellers مفيدًا:
| حالة الاستخدام | ما الذي تحصل عليه | من يستفيد |
|---|---|---|
| أبحاث منتجات FBA | تحديد المنتجات عالية الطلب ومنخفضة المنافسة عبر BSR وعدد المراجعات | بائعو Amazon، الدروبشيبنغ |
| التسعير التنافسي | تتبع تغيّرات الأسعار عبر أفضل المنتجات في فئتك | فرق التجارة الإلكترونية، محللو التسعير |
| مراقبة اتجاهات السوق | رصد الفئات الصاعدة والتحولات الموسمية | مدراء المنتجات، باحثو السوق |
| توليد العملاء المحتملين | بناء قوائم بأفضل العلامات التجارية مبيعًا وخطوط منتجاتها | فرق المبيعات، التواصل مع الشركات |
| تحليل المنافسين | مقارنة منتجاتك مع رواد الفئة | مدراء العلامات التجارية، فرق الاستراتيجية |
العائد على الاستثمار واضح: فقد أظهر استطلاع لـ Salesforce شمل 2700 متخصص في التجارة أن أدوات AI توفّر لمتخصصي التجارة الإلكترونية متوسط 6.4 ساعات أسبوعيًا. كما أن البائعين الذين يستخدمون تتبع الأسعار تلقائيًا يحتفظون بـ Buy Box 67% من الوقت مقابل 42% فقط للمتعقبين اليدويين — وهذا يعني زيادة في المبيعات بنسبة 37% نتيجة الاستجابة الأسرع لتغيّرات السعر.
4 طرق لاستخراج Amazon Best Sellers باستخدام Python: مقارنة سريعة
قبل ما ندخل في الشرح خطوة بخطوة، إليك مقارنة جانبية تمنيت لو شفتها قبل ما أبدأ الاختبار. هذا الجدول يساعدك تختار الطريقة الأنسب لوضعك:
| المعيار | requests + BS4 | Selenium | Scraping API (مثل Scrape.do) | Thunderbit (بدون كود) |
|---|---|---|---|---|
| صعوبة الإعداد | متوسطة | عالية (Driver، متصفح) | منخفضة (API key) | منخفضة جدًا (إضافة Chrome) |
| التعامل مع Lazy Loading | لا | نعم (محاكاة التمرير) | نعم (HTML مُعالج) | نعم (AI يتولى العرض) |
| مقاومة الحظر | ضعيفة (حظر IP) | متوسطة (يمكن اكتشافه) | عالية (تدوير البروكسي) | عالية (وضع السحابة + المتصفح) |
| عبء الصيانة | مرتفع (تتغير المحددات) | مرتفع (تحديثات driver + المحددات) | منخفض | منخفض جدًا (AI يتكيف مع تغييرات التخطيط) |
| التكلفة | مجانية | مجانية | مدفوعة (حسب الطلب) | باقة مجانية + خطط مدفوعة |
| الأفضل لـ | عمليات استخراج لمرة واحدة، والتعلم | الصفحات الثقيلة بـ JS، والصفحات التي تتطلب تسجيل دخول | التشغيل واسع النطاق / الإنتاج | غير المطورين، البحث السريع، المراقبة المتكررة |
إذا كنت تبغى تتعلم أساسيات الاستخراج بـ Python، ابدأ بالطريقة 1 أو 2. إذا كنت تحتاج موثوقية بمستوى الإنتاج، روح للطريقة 3. وإذا كنت تريد نتائج بنقرة واحدة بدون كتابة أي كود، انتقل مباشرة إلى الطريقة 4.
قبل أن تبدأ
- مستوى الصعوبة: مبتدئ إلى متوسط (حسب الطريقة)
- الوقت المطلوب: حوالي 15 دقيقة مع Thunderbit، وحوالي 45 دقيقة لطرق Python
- ما تحتاجه: Python 3.8+ (للطُرق 1–3)، ومتصفح Chrome، وThunderbit Chrome Extension (للطريقة 4)، ورابط صفحة Amazon Best Sellers المستهدفة
الطريقة 1: استخراج Amazon Best Sellers باستخدام requests + BeautifulSoup
هذا الأسلوب خفيف ومناسب للمبتدئين — بدون أتمتة متصفح، فقط طلبات HTTP وتحليل HTML. وقد علّمني أكثر شيء عن دفاعات Amazon ضد الاستخراج.
الخطوة 1: إعداد البيئة
ثبّت الحزم المطلوبة:
pip install requests beautifulsoup4 pandas
ثم جهّز الاستيرادات:
import requests
from bs4 import BeautifulSoup
import pandas as pd
import random
import time
الخطوة 2: إرسال طلب مع ترويسات واقعية
Amazon تمنع الطلبات التي تظهر كأنها جاية من روبوتات. أبسط وسيلة دفاع هي ترويسة User-Agent تحاكي متصفحًا حقيقيًا. إليك مقتطفًا يضم مجموعة من سلاسل User-Agent حديثة وواقعية (من Geekflare، مارس 2026):
USER_AGENTS = [
    "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/147.0.0.0 Safari/537.36",
    "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/147.0.0.0 Safari/537.36",
    "Mozilla/5.0 (Windows NT 10.0; Win64; x64; rv:149.0) Gecko/20100101 Firefox/149.0",
    "Mozilla/5.0 (Macintosh; Intel Mac OS X 15.7; rv:149.0) Gecko/20100101 Firefox/149.0",
    "Mozilla/5.0 (Macintosh; Intel Mac OS X 15_7_5) AppleWebKit/605.1.15 (KHTML, like Gecko) Version/26.0 Safari/605.1.15",
]

headers = {"User-Agent": random.choice(USER_AGENTS)}
url = "https://www.amazon.com/Best-Sellers-Electronics/zgbs/electronics/"
response = requests.get(url, headers=headers)
print(response.status_code)  # Should be 200
إذا ظهرت لك حالة 200، فأنت تمام. أما إذا ظهر 503 أو أُعيد توجيهك إلى صفحة CAPTCHA، فهذا يعني أن Amazon صنّفت طلبك كمريب.
الخطوة 3: تحليل بيانات المنتجات باستخدام BeautifulSoup
افحص HTML الخاص بصفحة Amazon باستخدام أدوات المطوّر في المتصفح (انقر بزر الماوس الأيمن → Inspect). حاويات المنتجات تحمل المعرّف gridItemRoot. وداخل كل حاوية ستجد اسم المنتج والسعر والتقييم والرابط.
soup = BeautifulSoup(response.text, "html.parser")
products = []

for item in soup.find_all("div", id="gridItemRoot"):
    title_tag = item.find("div", class_="_cDEzb_p13n-sc-css-line-clamp-3_g3dy1")
    price_tag = item.find("span", class_="_cDEzb_p13n-sc-price_3mJ9Z")
    link_tag = item.find("a", class_="a-link-normal")

    title = title_tag.get_text(strip=True) if title_tag else "N/A"
    price = price_tag.get_text(strip=True) if price_tag else "N/A"
    url = "https://www.amazon.com" + link_tag["href"] if link_tag else "N/A"

    products.append({"Title": title, "Price": price, "URL": url})
تحذير: الأسماء الصنفية التي تبدأ بـ
_cDEzb_هي بصمات CSS module hashes تعيد Amazon توليدها بشكل دوري. أما المعرّفgridItemRootوالصنفa-link-normalفهما أكثر ثباتًا، لكن لازم دائمًا تتأكد من المحددات عبر DevTools قبل تشغيل الأداة.
الخطوة 4: التصدير إلى CSV
df = pd.DataFrame(products)
df.to_csv("amazon_best_sellers.csv", index=False)
print(f"Scraped {len(products)} products")
ماذا تتوقع — وما الذي قد يتعطل
في اختباري، رجعت هذه الطريقة حوالي 30 منتجًا بدلًا من 50. وهذا ليس خطأ في الكود — بل بسبب Lazy Loading في Amazon. حوالي 30 منتجًا فقط تظهر في التحميل الأولي للصفحة؛ أما الباقي فيظهر بعد التمرير، وهذا يحتاج JavaScript، وrequests ما يقدر يتعامل معه.
قيود ثانية:
- قد يحدث حظر IP بسرعة إذا ما استخدمت تدوير البروكسي (تم حظري بعد نحو 15 طلبًا متتاليًا بسرعة)
- تتغير محددات CSS عندما تحدّث Amazon تخطيط الصفحة — وهي تفعل ذلك باستمرار
- ما فيه تعامل تلقائي مع الصفحات التالية
هذه الطريقة ممتازة لتعلم Python scraping، لكنها هشة لو بتستخدمها بشكل إنتاجي.
الطريقة 2: استخراج Amazon Best Sellers باستخدام Selenium
Selenium يحل مشكلة التحميل المتأخر عبر تشغيل متصفح حقيقي — الإعداد أثقل، لكنه يلتقط كل المنتجات الخمسين في الصفحة.
الخطوة 1: تثبيت Selenium
pip install selenium pandas
والخبر الجيد: بدءًا من Selenium 4.6، ما عاد تحتاج webdriver-manager. Selenium Manager يتولى تنزيل driver تلقائيًا.
from selenium import webdriver
from selenium.webdriver.chrome.options import Options
from selenium.webdriver.common.by import By
from selenium.webdriver.common.keys import Keys
import time
import pandas as pd

options = Options()
options.add_argument("--headless=new")
options.add_argument("--window-size=1920,1080")
options.add_argument("--disable-blink-features=AutomationControlled")

driver = webdriver.Chrome(options=options)
الوسم --headless=new (الذي دخل في Chrome 109+) يستخدم نفس مسار العرض الذي يستخدمه Chrome العادي، وهذا يخلي اكتشافه أصعب على Amazon.
الخطوة 2: التمرير لتجاوز Lazy Loading
هذه هي الخطوة اللي تخلي Selenium يستاهل الإعداد. Amazon Best Sellers تعرض فقط حوالي 30 منتجًا بالبداية — والباقي يظهر بعد التمرير.
def scroll_page(driver, scrolls=5, delay=2):
    for _ in range(scrolls):
        driver.find_element(By.TAG_NAME, "body").send_keys(Keys.PAGE_DOWN)
        time.sleep(delay)

driver.get("https://www.amazon.com/Best-Sellers-Electronics/zgbs/electronics/")
time.sleep(3)
scroll_page(driver)
بعد التمرير، المفروض تظهر كل المنتجات الخمسين داخل DOM. لقيت أن 5 مرات تمرير مع تأخير ثانيتين كانت كافية، لكن قد تحتاج تعدّلها حسب سرعة اتصالك.
الخطوة 3: استخراج بيانات المنتجات
items = driver.find_elements(By.ID, "gridItemRoot")
products = []

for item in items:
    try:
        title = item.find_element(By.CSS_SELECTOR, "div._cDEzb_p13n-sc-css-line-clamp-3_g3dy1").text
    except:
        title = "N/A"
    try:
        price = item.find_element(By.CSS_SELECTOR, "span._cDEzb_p13n-sc-price_3mJ9Z").text
    except:
        price = "N/A"
    try:
        url = item.find_element(By.CSS_SELECTOR, "a.a-link-normal").get_attribute("href")
    except:
        url = "N/A"

    products.append({"Title": title, "Price": price, "URL": url})
من المهم تحوط كل عملية استخراج بـ try/except — لأن بعض المنتجات قد تكون غير متوفرة أو ما فيها كل الحقول، وما تبغى عنصر واحد معطوب يوقف العملية كلها.
الخطوة 4: التعامل مع الترقيم الصفحي
Amazon تقسم أفضل 100 منتج مبيعًا على صفحتين ببنى URL مختلفة:
urls = [
    "https://www.amazon.com/Best-Sellers-Electronics/zgbs/electronics/",
    "https://www.amazon.com/Best-Sellers-Electronics/zgbs/electronics/ref=zg_bs_pg_2_electronics?_encoding=UTF8&pg=2"
]

all_products = []
for url in urls:
    driver.get(url)
    time.sleep(3)
    scroll_page(driver)
    # ... extract products as above ...
    all_products.extend(products)

driver.quit()
ماذا تتوقع
في اختباري، Selenium التقط كل المنتجات الخمسين في كل صفحة — وهذا أفضل بوضوح من requests + BS4. لكن السلبيات: استغرق تقريبًا 45 ثانية لكل صفحة (بما في ذلك تأخيرات التمرير)، وبرضه تعرّضت للإشارة كحالة مشبوهة بعد تشغيله عدة مرات بدون تدوير البروكسي. كما أن Amazon تقدر تكشف Selenium حتى مع وسوم مقاومة الاكتشاف — وللعمل الجاد ستحتاج إجراءات إضافية (راجع قسم Anti-Ban Playbook أدناه).
مشكلات ثانية:
- قد تحدث أحيانًا مشاكل عدم تطابق في إصدار WebDriver، رغم أن Selenium Manager خفّف هذا كثيرًا
- محددات CSS تحتاج تحديث كلما غيّرت Amazon DOM الخاص بها
- استهلاك الذاكرة مرتفع — لأن كل مثيل للمتصفح يستهلك 200–400 ميغابايت من RAM
الطريقة 3: استخراج Amazon Best Sellers باستخدام Scraping API
واجهات Scraping API هي خيار "خلّ غيرك يتولى الشغل الثقيل". خدمات مثل Scrape.do وOxylabs وScrapingBee تدير تدوير البروكسي، وعرض JavaScript، وإجراءات الحماية ضد البوتات — وأنت فقط ترسل الرابط وتستلم HTML أو JSON.
كيف تعمل
ترسل الرابط المستهدف إلى نقطة نهاية الـ API. الخدمة تعرض الصفحة عبر متصفح حقيقي على بنيتها التحتية، وتدوّر البروكسيات، وتتجاوز CAPTCHA، ثم تعيد HTML نظيفًا. بعد ذلك تحلل HTML المُعاد باستخدام BeautifulSoup كالمعتاد.
الخطوة 1: إرسال طلب عبر الـ API
إليك مثال باستخدام Scrape.do (تبدأ الأسعار من 29 دولارًا شهريًا مقابل 150,000 رصيد، و1 رصيد = 1 طلب بغض النظر عن العرض):
import requests
from bs4 import BeautifulSoup

api_token = "YOUR_API_TOKEN"
target_url = "https://www.amazon.com/Best-Sellers-Electronics/zgbs/electronics/"

api_url = f"https://api.scrape.do?token={api_token}&url={target_url}&render=true&geoCode=us"
response = requests.get(api_url)
soup = BeautifulSoup(response.text, "html.parser")
من هنا، التحليل يظل مثل الطريقة 1 — نفس المحددات، ونفس منطق الاستخراج.
مراجعة سريعة للتسعير
إليك ما تفرضه أبرز الواجهات مقابل كل 1,000 طلب على Amazon بأفضل سعر متاح:
| المزوّد | التكلفة لكل 1,000 طلب | ملاحظات |
|---|---|---|
| Scrape.do | حوالي $0.19 | سعر ثابت، دون مضاعفات للرصيد |
| Oxylabs | حوالي $1.80 | مضاعف 5x لعرض JavaScript |
| ScrapingBee | حوالي $4.90 | مضاعفات 5–25x للميزات المميزة |
| Bright Data | $5.00+ | أكثر البيانات شمولًا (686 حقلًا/منتج) لكنه الأبطأ (~66 ثانية/طلب) |
الإيجابيات والسلبيات
الإيجابيات: موثوقية عالية (~99% معدل نجاح على Amazon لدى المزودين الكبار)، ما تحتاج صيانة driver، ويتعامل مع الحظر تلقائيًا، ويتوسع بشكل ممتاز.
السلبيات: الدفع حسب الطلب، لذلك التكلفة تتراكم مع الحجم، وما زال عليك كتابة كود التحليل، كما يبقى قابلًا للتأثر بتغييرات CSS selectors. وعند 100,000 صفحة شهريًا، الفرق المالي كبير: البناء الداخلي يكلف تقريبًا $1.98 مليون خلال ثلاث سنوات مقابل $332 ألف مع مزود API — أي توفير بنسبة 71%.
نقطة التعادل عادة تكون بين 500 ألف ومليون طلب شهريًا. وتحت هذا المستوى، غالبًا وفورات الوقت مع الـ API تتفوّق بوضوح على تكلفته.
الطريقة 4: استخراج Amazon Best Sellers باستخدام Thunderbit (من دون Python)
للتوضيح الكامل: أنا أعمل في Thunderbit، لذلك خذ هذا القسم مع هذا السياق. ومع ذلك، أنا فعلًا اختبرت الطرق الأربع وحدة وحدة، وكان الفرق في سرعة الوصول إلى البيانات كبير جدًا.
Thunderbit هو AI web scraper يعمل كإضافة Chrome. الفكرة بسيطة: بدل ما تكتب CSS selectors أو كود Python، يقرأ الذكاء الاصطناعي الصفحة ويستنتج الحقول اللي لازم تنسحب. وبالنسبة إلى Amazon Best Sellers تحديدًا، لدى Thunderbit قوالب جاهزة تعمل بنقرة واحدة.
الخطوة 1: تثبيت إضافة Thunderbit على Chrome
ادخل إلى Chrome Web Store واضغط "Add to Chrome". بعدها أنشئ حسابًا مجانيًا — الباقة المجانية تعطيك رصيدًا كافيًا لتجربة الأداة.
الخطوة 2: الانتقال إلى صفحة Amazon Best Sellers
افتح أي صفحة فئة Best Sellers في Amazon عبر Chrome. مثلًا:
https://www.amazon.com/Best-Sellers-Electronics/zgbs/electronics/
الخطوة 3: النقر على "One Click Extract"
افتح الشريط الجانبي لـ Thunderbit واضغط "One Click Extract". سيحلل الذكاء الاصطناعي بنية الصفحة ويستنتج الأعمدة: اسم المنتج، السعر، التقييم، رابط الصورة، البائع، رابط المنتج، والترتيب. في اختباري، تعرّف على كل الحقول ذات الصلة بشكل صحيح خلال حوالي 3 ثوانٍ.
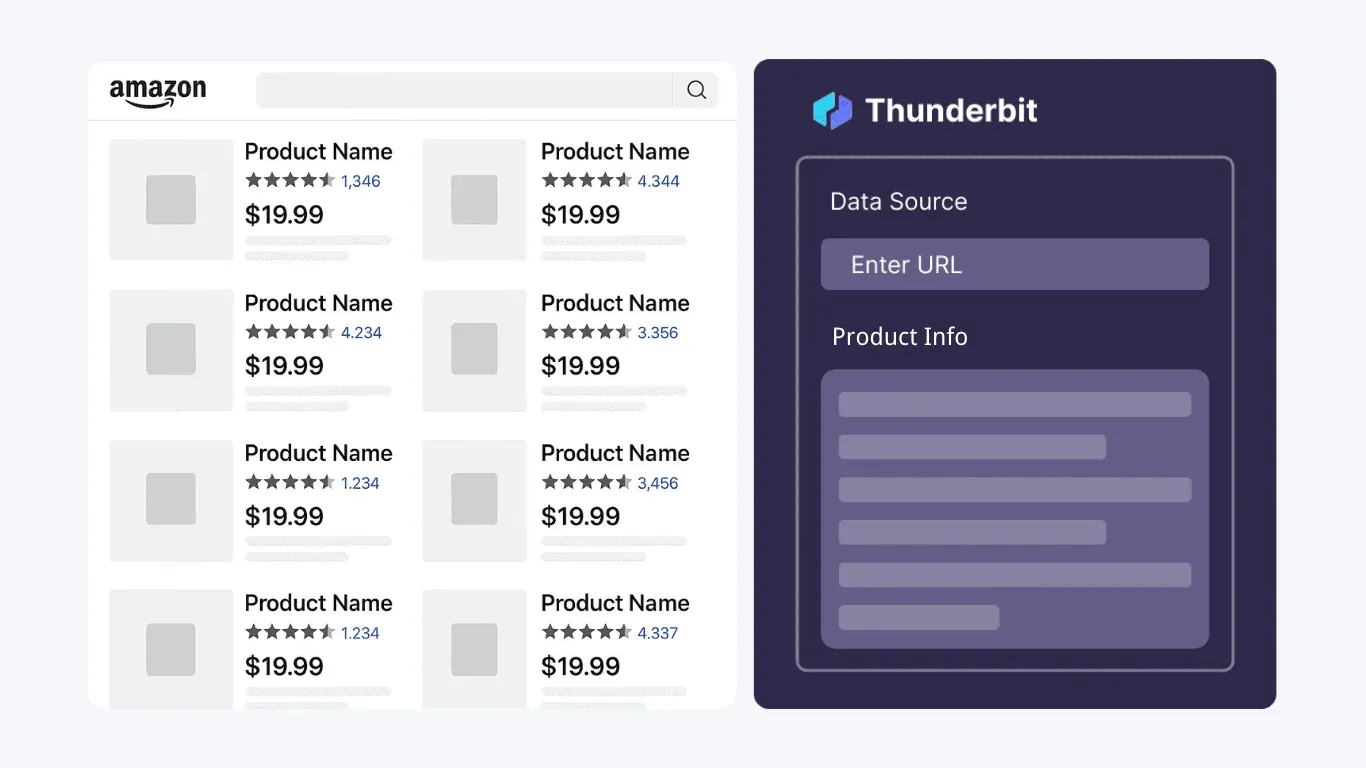
تقدر تعيد تسمية الأعمدة أو تحذفها أو تضيف أعمدة جديدة. وحتى تقدر تضيف تعليمات AI مخصصة لكل حقل — مثل "صنّف المنتج ضمن Electronics/Apparel/Home" لإضافة وسم فئة لكل منتج.
الخطوة 4: النقر على "Scrape"
اضغط زر "Scrape". Thunderbit يملأ جدولًا منظمًا بكل بيانات المنتجات من الصفحة. وفي وضع السحابة، يقدر يعالج حتى 50 صفحة دفعة واحدة بالتوازي، مع التعامل التلقائي مع Lazy Loading والترقيم الصفحي.
الخطوة 5: التصدير مجانًا
اضغط "Export" واختر وجهتك: Excel أو Google Sheets أو Airtable أو Notion. كل عمليات التصدير مجانية في جميع الباقات — بدون رسوم مخفية.
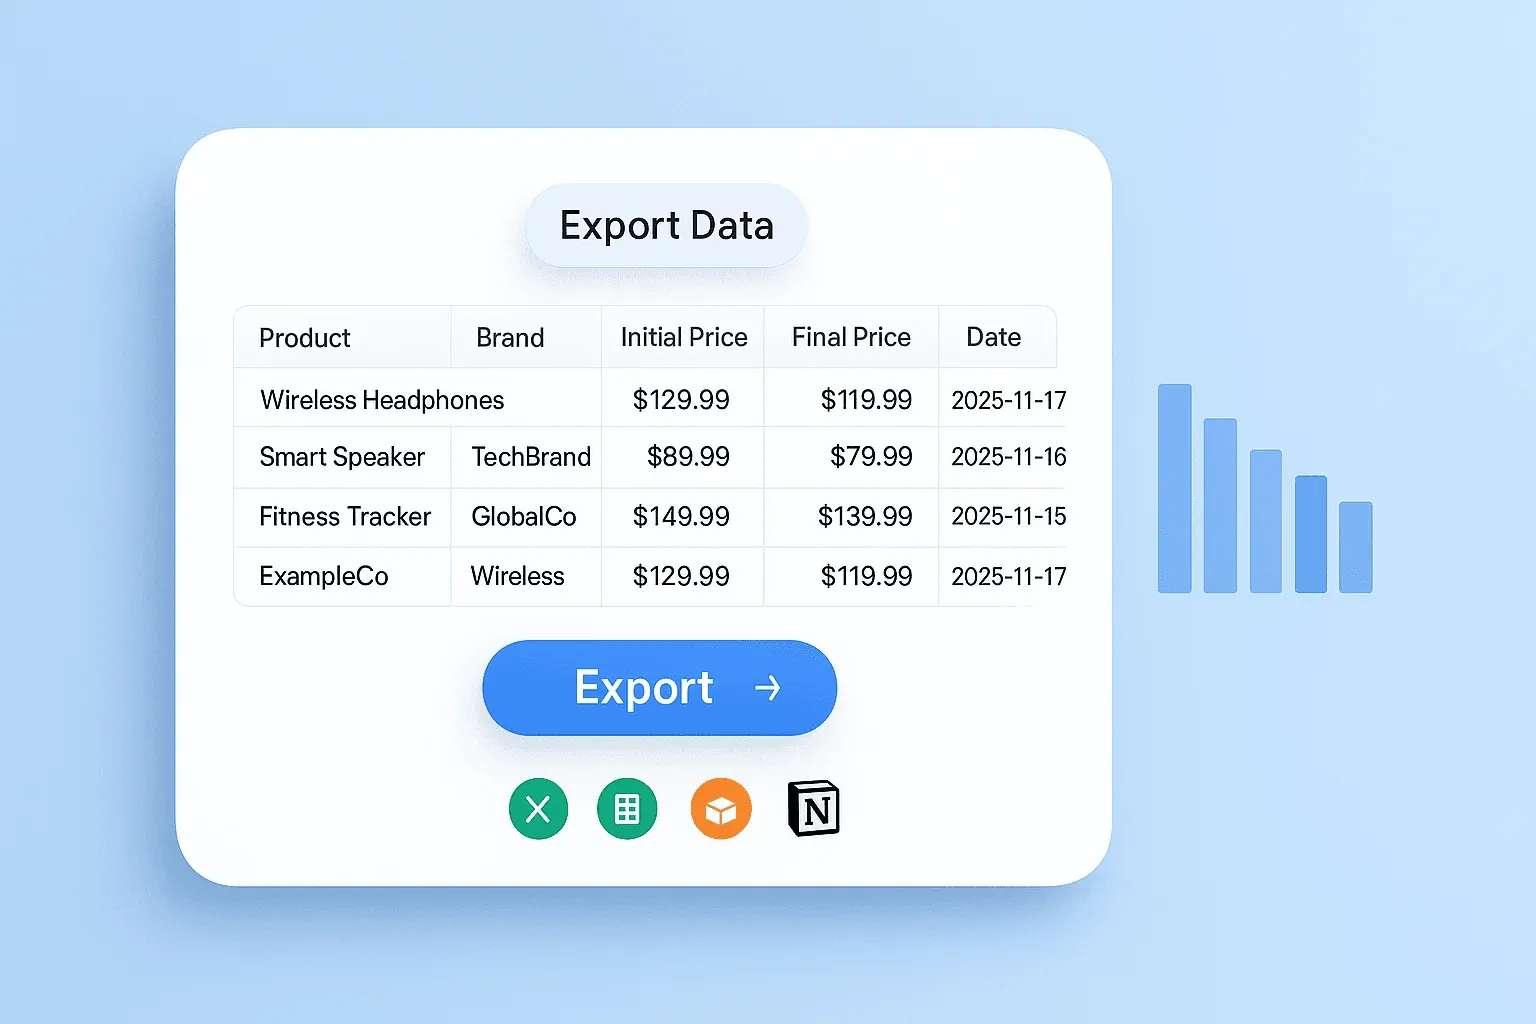
استغرقت العملية كاملة حوالي 90 ثانية، من فتح الصفحة إلى الحصول على جدول بيانات مكتمل. وللمقارنة: الطريقة 1 أخذت حوالي 20 دقيقة (بما فيها إصلاح مشكلة Lazy Loading)، والطريقة 2 حوالي 35 دقيقة (بما فيها إعداد Selenium)، والطريقة 3 حوالي 15 دقيقة (بما فيها إعداد حساب الـ API).
لماذا Thunderbit مناسب جدًا لـ Amazon
بما أن الذكاء الاصطناعي يقرأ الصفحة من جديد في كل مرة، فهو يتأقلم تلقائيًا مع تغييرات التخطيط — من دون أي CSS selectors تحتاج صيانة. وهذا يعالج مباشرة الشكوى الأكثر شيوعًا في منتديات الاستخراج: "لن يكفي web scraper بسيط، لازم تضيف استثناءات كثيرة كلما تغيّر شيء." وعندما تغيّر Amazon DOM الخاص بها — وهذا يحصل باستمرار — ما تحتاج تعدّل أي شيء.
أما وضع الاستخراج السحابي فيتولى تدوير البروكسي، والعرض، وإجراءات الحماية من البوتات بشكل شفاف. وللي يبي حل يشتغل مباشرة بدون لف ودوران، فهذا يزيل صداع الحظر بالكامل.
تخلّص من صيانة المحددات عندما يغيّر Amazon البنية البرمجية للصفحة، تتعطل محددات BeautifulSoup لديك. أما Thunderbit فيعيد قراءة الصفحة في كل تشغيل ويستنتج الحقول من جديد. Get Started Free
خطة تجنب الحظر: كيف تتفادى الحظر من Amazon
نظام Amazon لاكتشاف البوتات صارم جدًا. تم حظر عنوان IP الخاص بي مؤقتًا أثناء الاختبار، والناس في المنتديات يذكرون الشيء نفسه: "الأخطاء في كل مكان، وAmazon بدأت تعيد توجيهي إلى الصفحة الرئيسية." إذا كنت ناوي تمشي في طريق Python (الطرق 1–3)، فهذا القسم مهم جدًا.
إليك استراتيجية متعددة الطبقات، من الأساسيات إلى الأكثر تقدمًا:
1. تدوير سلاسل User-Agent
إرسال نفس User-Agent كل مرة يعتبر علامة حمراء. استخدم مجموعة من 5 سلاسل أو أكثر من مثال الطريقة 1، واختر واحدة عشوائيًا لكل طلب:
headers = {"User-Agent": random.choice(USER_AGENTS)}
2. إضافة تأخيرات عشوائية بين الطلبات
التأخيرات الثابتة سهلة الاكتشاف لأنها تكشف نمطًا. أما العشوائية فهي أأمن:
time.sleep(random.uniform(2, 5))
وجدت أن التأخير بين 2 و5 ثوانٍ بين الطلبات خلّاني بعيد عن الأنظار في الدُفعات الصغيرة (أقل من 50 طلبًا). وللتشغيلات الأكبر، ارفعها إلى 3–7 ثوانٍ.
3. استخدام تدوير البروكسي
هذه هي النقطة الأهم. اختبارات Proxyway تظهر أن البروكسيات السكنية تحقق متوسط نجاح يقارب 94% على Amazon مقابل نحو 59% لبروكسيات مراكز البيانات — فرق 35 نقطة مئوية. Amazon تعتمد في الكشف على بصمة TLS، والتحليل السلوكي، وتحديد المعدلات لكل IP، لذلك عناوين IP الخاصة بمراكز البيانات تُكتشف خلال ثوانٍ.
البروكسيات السكنية أغلى ($2–$12 لكل غيغابايت حسب المزود) لكنها أكثر موثوقية بكثير. مثال للكود:
proxies = {
    "http": "http://user:pass@residential-proxy.example.com:8080",
    "https": "http://user:pass@residential-proxy.example.com:8080"
}
response = requests.get(url, headers=headers, proxies=proxies)
4. تقوية بصمة المتصفح (Selenium)
options.add_argument('--disable-blink-features=AutomationControlled')
options.add_experimental_option("excludeSwitches", ["enable-automation"])
options.add_experimental_option('useAutomationExtension', False)

# After driver init, remove navigator.webdriver flag
driver.execute_cdp_command('Page.addScriptToEvaluateOnNewDocument', {
    'source': "Object.defineProperty(navigator, 'webdriver', {get: () => undefined})"
})
5. إدارة الجلسات وملفات تعريف الارتباط
الاحتفاظ بملفات تعريف الارتباط بين الطلبات يخلي أداة الاستخراج تبدو أقرب إلى جلسة مستخدم حقيقية:
session = requests.Session()
# Visit homepage first to get realistic cookies
session.get("https://www.amazon.com", headers=headers)
time.sleep(2)
# Then scrape your target page
response = session.get(target_url, headers=headers)
6. متى تتجاوز كل هذا الصداع بالكامل
إذا ما كنت تريد إدارة أي من هذا، فـ Thunderbit في وضع السحابة يتكفل بتدوير البروكسي، والعرض، وإجراءات مكافحة البوتات بشكل شفاف. كذلك Scraping APIs تدير معظم هذه التفاصيل تلقائيًا. ومن تجربتي، الوقت اللي يضيع في إصلاح مشاكل الحظر غالبًا أكثر من الوقت المطلوب لكتابة كود الاستخراج نفسه — لذلك نهج "يعمل مباشرة" له قيمة حقيقية.
إثراء الصفحات الفرعية: استخراج صفحات تفاصيل المنتجات لبيانات أغنى
صفحة Best Sellers تعرض معلومات أساسية فقط — العنوان، السعر، التقييم، والترتيب. لكن القيمة الحقيقية في أبحاث FBA تكمن في صفحات تفاصيل المنتج الفردية. إليك ما تفوته إذا اكتفيت بصفحة القائمة:
| الحقل | صفحة القائمة | صفحة تفاصيل المنتج |
|---|---|---|
| اسم المنتج | ✅ | ✅ |
| السعر | ✅ | ✅ |
| التقييم | ✅ | ✅ |
| ترتيب BSR | ✅ | ✅ (مع ترتيبات الفئات الفرعية) |
| العلامة التجارية | ❌ | ✅ |
| ASIN | ❌ | ✅ |
| تاريخ الإتاحة لأول مرة | ❌ | ✅ |
| الأبعاد / الوزن | ❌ | ✅ |
| عدد البائعين | ❌ | ✅ |
| الميزات النقطية | ❌ | ✅ |
| مالك Buy Box | ❌ | ✅ |
حقل "تاريخ الإتاحة لأول مرة" مهم جدًا — لأنه يوضح من متى المنتج موجود في السوق، وهذا مؤشر أساسي لتحليل المنافسة. ومعرفة عدد البائعين ومالك Buy Box تساعدك على تقييم ما إذا كانت الفئة تستاهل الدخول أصلًا (إذا كانت Amazon نفسها تملك أكثر من 30% من حصة Buy Box، فالمنافسة تصير صعبة جدًا).
نهج Python: المرور على روابط المنتجات
بعد ما تجمع روابط المنتجات من صفحة القائمة، مرّ على كل رابط مع تأخير:
for product in products:
    time.sleep(random.uniform(3, 6))
    detail_response = session.get(product["URL"], headers={"User-Agent": random.choice(USER_AGENTS)})
    detail_soup = BeautifulSoup(detail_response.text, "html.parser")

    # Extract brand
    brand_tag = detail_soup.find("a", id="bylineInfo")
    product["Brand"] = brand_tag.get_text(strip=True) if brand_tag else "N/A"

    # Extract ASIN from page source or URL
    # Extract Date First Available from product details table
    # ... additional fields ...
تنبيه: المرور على 100 صفحة منتج فردية يرفع خطر الحظر كثيرًا. لذلك لازم تحسب تكلفة تدوير البروكسيات وتأخيرات أطول.
نهج Thunderbit: استخراج الصفحات الفرعية بنقرة واحدة
بعد استخراج صفحة القائمة إلى جدول، اضغط "Scrape Subpages" في Thunderbit. يزور الذكاء الاصطناعي كل رابط منتج ويثري الجدول بأعمدة إضافية — العلامة التجارية، ASIN، المواصفات، والميزات — تلقائيًا. بدون أي كود إضافي أو محددات أو إعدادات. وهذا مفيد جدًا لفرق التجارة الإلكترونية التي تحتاج الصورة الكاملة لاتخاذ قرارات التوريد، لكنها لا تريد كتابة أو صيانة محلل لصفحات التفاصيل.
أتمتة الاستخراج المتكرر: مراقبة Best Sellers بمرور الوقت
الاستخراج لمرة واحدة مفيد، لكن المراقبة المستمرة هي مكان الميزة التنافسية الحقيقية. تتبع المنتجات التي تصعد وتهبط، ورصد الترند مبكرًا، ومراقبة تغيّرات الأسعار على مدى أسابيع أو أشهر — هذا اللي يفصل بين البحث العابر والقرار المبني على البيانات.
نهج Python: الجدولة باستخدام Cron
على Linux/Mac، تقدر وجدولة سكربت Python باستخدام cron. إليك إدخال crontab لاستخراج يومي عند 8 صباحًا:
0 8 * * * /usr/bin/python3 /home/user/amazon_scraper.py >> /home/user/logs/scrape.log 2>&1
ولتنفيذ استخراج أسبوعي كل يوم إثنين عند 9 صباحًا:
0 9 * * 1 /usr/bin/python3 /home/user/amazon_scraper.py >> /home/user/logs/scrape.log 2>&1
على Windows، استخدم Task Scheduler لنفس الغرض. أما إذا أردت جدولة تعمل دائمًا من دون إبقاء اللابتوب شغال، فيمكنك النشر على VPS أو AWS Lambda — لكن هذا يضيف تعقيدًا تقنيًا إضافيًا.
أضف تسجيلًا للأحداث وإشعارات عند الأخطاء حتى تكتشف الأعطال بسرعة. ما في شيء أسوأ من اكتشاف أن الأداة تعطلت بصمت قبل أسبوعين.
نهج Thunderbit: Scheduled Scraper بلغة طبيعية
تتيح لك ميزة Scheduled Scraper في Thunderbit وصف الجدولة بلغة طبيعية — اكتب "every Monday at 9am" أو "every day at 8am" والذكاء الاصطناعي يفهمها. تُنفذ عمليات الاستخراج على خوادم Thunderbit السحابية (من دون الحاجة لتشغيل متصفح أو جهاز)، وتُصدّر البيانات تلقائيًا إلى Google Sheets أو Airtable. وهذا يبني لوحة مراقبة حيّة من غير أي إدارة خوادم — مثالي لفرق العمليات التي تريد رؤية مستمرة بدون صداع DevOps.
الاعتبارات القانونية والأخلاقية عند استخراج بيانات Amazon
أنا لست محاميًا، وهذا ليس استشارة قانونية. لكن تجاهل الجوانب القانونية في مقال تعليمي عن الاستخراج سيكون تصرفًا غير مسؤول — فمستخدمو المنتديات يطرحون أصلًا مخاوف شروط الاستخدام، ولسبب وجيه.
robots.txt الخاص بـ Amazon: حتى عام 2026، يحتوي robots.txt في Amazon على أكثر من 80 مسارًا محددًا بـ Disallow، لكن /gp/bestsellers/ ليست محظورة صراحةً على وكلاء المستخدم العاديين. ومع ذلك، أكثر من 35 وكيل مستخدم خاص بالذكاء الاصطناعي (مثل ClaudeBot وGPTBot وScrapy وغيرها) يتلقون حظرًا عامًا Disallow: /. عدم وجود حظر محدد لا يعني أن Amazon تؤيد الاستخراج.
شروط خدمة Amazon: تنص Conditions of Use الخاصة بـ Amazon (المحدّثة في مايو 2025) بشكل صريح على حظر "استخدام أي عملية أو تقنية آلية للوصول إلى أي جزء من موقع Amazon أو الحصول عليه أو نسخه أو مراقبته" من دون إذن خطي. وهذا ليس مجرد كلام نظري — فقد رفعت Amazon دعوى ضد Perplexity AI في نوفمبر 2025 بسبب وصول آلي غير مصرح به، وحصلت على أمر قضائي أولي.
سابقة hiQ ضد LinkedIn: في قضية hiQ Labs v. LinkedIn (الدائرة التاسعة، 2022)، قضت المحكمة بأن استخراج البيانات المتاحة للعامة لا ينتهك غالبًا قانون Computer Fraud and Abuse Act. لكن hiQ انتهت بالتسوية ووافقت على التوقف عن الاستخراج — فالفوز في قضية CFAA لا يحمي من دعاوى خرق العقد.
إرشادات عملية:
- استخرج فقط البيانات المتاحة للعامة (الأسعار، BSR، عناوين المنتجات — وليس البيانات الشخصية)
- احترم حدود المعدل ولا تثقل الخوادم
- استخدم البيانات لذكاء تنافسي مشروع
- استشر مستشارك القانوني قبل الاستخراج على نطاق واسع
- كن على دراية بأن أكثر من 20 ولاية أمريكية لديها الآن تشريعات خصوصية شاملة
يستخدم Thunderbit في وضع السحابة أنماط طلبات شبيهة بالمتصفح العادي، لكن لازم دائمًا تتحقق من الالتزام القانوني مع مستشارك الخاص.
ما تحتاج Python هنا إذا كان هدفك جدول بيانات وليس خط أنابيب بيانات، فبنقرة واحدة توصل إليه. صدّر مباشرة إلى Excel أو Google Sheets أو Airtable أو Notion. Get Started Free
أي طريقة يجب أن تختار؟ دليل قرار سريع
الخلاصة المختصرة:
- "أنا أتعلم Python وأريد مشروع نهاية أسبوع." → الطريقة 1 (requests + BeautifulSoup). ستتعلّم الكثير عن طلبات HTTP وتحليل HTML ودفاعات Amazon ضد البوتات.
- "أحتاج إلى استخراج صفحات ثقيلة بـ JavaScript أو جلسات تسجيل دخول." → الطريقة 2 (Selenium). أثقل لكنها تتعامل مع المحتوى الديناميكي.
- "أشغّل عمليات استخراج إنتاجية على نطاق واسع." → الطريقة 3 (Scraping API). خلّ غيرك يدير البروكسيات والعرض. إجمالي تكلفة الملكية يميل لصالح الـ API تحت 500 ألف طلب شهريًا.
- "لست مطورًا وأريد البيانات خلال دقيقتين." → الطريقة 4 (Thunderbit). لا كود، لا محددات، لا صيانة.
- "أحتاج إلى مراقبة مستمرة من دون إدارة خادم." → Thunderbit Scheduled Scraper. اضبطه وانسَه.
جرّب Thunderbit لـ Amazon Best Sellers Get Started Free
الخاتمة وأهم النقاط
بعد عطلة نهاية أسبوع من الاختبار، هذا اللي بقي فعلًا:
requests + BeautifulSoup ممتازة للتعلم، لكن محدودية Lazy Loading (إظهار حوالي 30 فقط من أصل 50 منتجًا) ومحددات CSS الهشّة تجعلها غير مناسبة للاستخدام الإنتاجي.
Selenium يحل مشكلة Lazy Loading ويلتقط كل المنتجات الخمسين في الصفحة، لكنه بطيء، ويستهلك الذاكرة، وما يزال قابلًا للاكتشاف من قبل دفاعات Amazon ضد البوتات.
Scraping APIs تعطي أفضل موثوقية للاستخراج على مستوى الإنتاج — نحو 99% معدل نجاح على Amazon — لكن التكاليف تتراكم، وما زال عليك كتابة كود التحليل.
Thunderbit قدّم أسرع وصول إلى البيانات بفارق واضح. الذكاء الاصطناعي يتكفّل بتغييرات التخطيط، وLazy Loading، والترقيم الصفحي، وإجراءات مكافحة البوتات من دون أي إعدادات. بالنسبة لغير التقنيين أو الفرق التي تحتاج بيانات متكررة بدون عبء DevOps، فهو الخيار الأكثر عملية.
أكبر درس؟ دفاعات Amazon ضد البوتات وتغيّرات التخطيط المتكررة تعني أن الحلول التي لا تحتاج صيانة توفّر أكثر وقت على المدى الطويل. فكل ساعة تضيعها في إصلاح محددات معطلة وتدوير البروكسيات هي ساعة لا تقضيها في التحليل الحقيقي.
إذا تبغى تجرب نهج بدون كود، فـ الباقة المجانية في Thunderbit تعطيك رصيدًا كافيًا لاستخراج عدة فئات من Best Sellers وتشوف النتائج بنفسك. وإذا تفضّل طريق Python، فالأمثلة أعلاه المفروض تساعدك تبدأ. في كلتا الحالتين، ستحصل على بيانات Amazon Best Seller داخل جدول بيانات بدلًا من التحديق في تبويب متصفح.
ولمزيد من المعلومات حول أساليب استخراج البيانات من الويب، راجع أدلّتنا حول استخراج منتجات Amazon والمراجعات، واستخراج البيانات من المواقع إلى Excel، وأفضل أدوات AI web scraper. يمكنك أيضًا مشاهدة شروحات خطوة بخطوة على قناة Thunderbit على YouTube.
اعرف المزيد



