
يُصنَّف MarkItDown كثيرًا مع أدوات الزحف إلى الويب، لكن هذا التصنيف غير دقيق. فهو لا يضم زاحفًا، ولا محرك JavaScript، ولا أي طريقة لجلب عنوان URL ثم تنظيف العناصر الجانبية والمكررة منه. ما يفعله ببساطة هو أخذ البيانات الموجودة لديك أصلًا — مثل PDF أو مستند Word أو جدول بيانات أو عرض شرائح — ثم تحويلها بالكامل إلى Markdown يمكن لنموذج لغوي قراءته.
قضيت بضعة أسابيع أجرّب Microsoft MarkItDown على مجموعة من المستندات الحقيقية على جهاز Mac واحد، مع تقييم كل جدول وفق قائمة مرجعية أعددتها قبل الاختبار، وقياس زمن كل عملية تحويل. والخلاصة السريعة: مع المدخلات النظيفة هو سريع ودقيق، لكن حزمة التثبيت تخبئ خلفها بيئة تشغيل تعلم آلي بحجم 73 ميجابايت لم تطلبها أصلًا، والجداول فيه تتعثر بطرق قد تجعل اختبارًا بسيطًا مثل «هل بقي النص؟» ناجحًا، بينما يفشل اختبار «هل بقيت البيانات في العمود الصحيح؟». فيما يلي الصورة الكاملة بالأرقام.
ما هو MarkItDown فعلًا
MarkItDown أداة بايثون من Microsoft تحوّل الملفات ومستندات Office إلى Markdown محسَّن للنماذج اللغوية الكبيرة. يمكنك توجيهه إلى PDF أو .docx أو .xlsx أو .pptx أو صورة أو ملف HTML أو غيرها من الصيغ، فيُرجع لك Markdown. ويمكن استخدامه بثلاث طرق: عبر سطر الأوامر (markitdown file.pdf -o out.md أو عبر stdin)، أو عبر واجهة Python (MarkItDown().convert(...))، أو عبر خادم MCP اختياري لسير العمل المعتمد على الوكلاء.
وأهم نقطة لازم تفهمها هي ما لا يفعله، لأن ملف README لا يدّعي ذلك، ولأنني تأكدت منه في الاختبار: لا زحف، لا تنفيذ لـ JavaScript، لا تتبّع للروابط، لا تنقّل بين الصفحات، ولا استخراج للمحتوى الرئيسي على طريقة أدوات القراءة. إنه محوّل للمستند كاملًا: أنت تقدّم البيانات الخام، وهو يطبعها بشكل موحّد. هذا الفرق وحده هو الذي يحدد إن كانت الأداة مناسبة لمنظومتك أم لا، لذلك سأعود إليه أكثر من مرة.
المستودع نفسه ضخم وفق مقاييس GitHub الاستعراضية — 165,282 نجمة و11,790 تفرعًا حتى منتصف يوليو 2026، ومرخّص MIT، مع أحدث إصدار (v0.1.6) في 2026-05-26. لكن هذا العدد الكبير من النجوم يعكس شعبية Microsoft واتجاه الأدوات المرتبطة بـ LLM أكثر مما يعكس نضج البنية الداخلية لعملية التحويل. وهناك أيضًا 833 مشكلة مفتوحة، وبعضها مهم قبل التثبيت (وسأعود إليه أدناه).
من HTML إلى Markdown: سريع وكامل، مع بقاء العناصر الجانبية أيضًا
وبما أن بقية سلسلة مراجعات أدوات الاستخراج لدي تتعامل مع نفس أربع عينات ويب، فقد دفعت MarkItDown إلى ملفات HTML المحلية نفسها — ليس لتقييمه كأداة زحف، بل لمعرفة جودة تحويل HTML إلى Markdown لديه. وعلى الصفحات المهيكلة جيدًا، النتيجة فعلًا ممتازة.
تحوّلت الصفحات الأربع كلها على التثبيت الأساسي من دون الحاجة إلى إضافات، وبقيت كل مؤشرات نص الجسم. مقالة ويكيبيديا عن «Web scraping» (حجمها 226 كيلوبايت) خرجت مع شجرة عناوينها محفوظة كما هي — عنوان h1 واحد، وسبعة عناوين h2، واثنا عشر عنوان h3، بما يطابق البنية الحقيقية للأقسام — ومع 418 رابطًا محفوظة بصيغة [text](url) الصحيحة. وجدول إحصاءات الهوكي 25×9 في صفحة Scrape This Site forms تحوّل إلى جدول GFM أنيق من 27 صفًا (العنوان + الفاصل + 26 صفًا للبيانات)، مع الخلايا الفارغة أيضًا. أما السرعة فلم تكن مشكلة: الوسيط كان 48 مللي ثانية لصفحة الاقتباسات الصغيرة، وصولًا إلى 352 مللي ثانية لصفحة ويكيبيديا ذات 226 كيلوبايت.
لكن هنا تظهر الملاحظة المهمة، وهي قرار تصميمي أكثر من كونها عيبًا. MarkItDown لا يزيل العناصر الجانبية أو النصوص المكررة. فهو يحوّل كامل <body>، لذلك تنتقل معه عناصر واجهة الموقع — ويزداد أثرها كلما كثرت هذه العناصر في الصفحة.
| الصفحة | عدد أحرف الخرج | العناوين (h1/h2/h3) | الروابط | أسطر عناصر الواجهة |
|---|---|---|---|---|
| Books to Scrape | 10,478 | 1 / 0 / 0 | 94 | 0.6% (1/159) |
| Quotes to Scrape | 2,973 | 1 / 1 / 0 | 55 | 1.2% (1/86) |
| ScrapeThisSite forms | 3,385 | 1 / 0 / 0 | 31 | 6.7% (5/75) |
| Wikipedia Web scraping | 60,159 | 1 / 7 / 12 | 418 | 12.4% (42/338) |
في صفحة Books الأقرب إلى خلوّها من عناصر الواجهة، 0.6% فقط من الأسطر هي عناصر واجهة. أما في ويكيبيديا فالنسبة 12.4% — أي 42 من أصل 338 سطرًا غير فارغ هي أشياء مثل «الانتقال إلى المحتوى»، و«إظهار/إخفاء جدول المحتويات»، و«22 لغة»، و«مسترجع من»، وتذييلات ملفات تعريف الارتباط والترخيص. حتى لافتات الصيانة في ويكيبيديا مثل «تحتاج هذه المقالة إلى مزيد من المراجع» تُحوَّل بدقة إلى جداول Markdown ثنائية الأعمدة، وهذا ما يفسر وجود تسعة صفوف جداول في صفحة لا تحتوي على جدول بيانات حقيقي.
وليس هذا أن MarkItDown يخطئ في ذلك؛ بل لأنه محوّل للمستند كاملًا، وليس مستخرجًا للمقالات القابلة للقراءة. التحويل الأمين من HTML إلى Markdown يختلف تمامًا عن استخراج المقالة النظيفة. أدوات مثل Trafilatura وFirecrawl تهدف إلى إعادة المحتوى الرئيسي فقط، بينما MarkItDown يعيد الصفحة نفسها. ومن الداخل، تقوم _html_converter.py بإزالة <script> و<style> ثم تمرر كامل body إلى مكتبة markdownify — من دون أي منطق لاكتشاف المحتوى الرئيسي. إذا كنت تريد المقال فقط، فأنت تستخدم الطبقة الخاطئة.
المجال الذي صُمّم له: PDF وDOCX وXLSX وPPTX
المستندات هي ما بُني MarkItDown من أجله. اختبرته على ملفات عامة حقيقية — ورقة arXiv تحتوي على طبقة نصية، وورقة Bitcoin البيضاء، وملف PDF ممسوح ضوئيًا لا يحتوي على نص قمت بتصييره بحيث يصبح بلا نص، إضافة إلى ملفات DOCX وXLSX وPPTX من مجموعة الاختبارات الخاصة بـ MarkItDown نفسه (مع قيم UUID عشوائية حتى أستطيع كشف فقدان المحتوى الصامت).
| المستند | حجم الإدخال | عدد أحرف الخرج | المؤشرات | الزمن الوسيط | ملاحظات |
|---|---|---|---|---|---|
| arXiv 1706.03762 (PDF بطبقة نصية) | 2.2 MB | 40,174 | 7/7 | 3.7 ث (دافئ) | العنوان، و"Transformer"، و"BLEU"، و"References" كلها موجودة |
| الورقة البيضاء لبيتكوين (9 صفحات PDF) | 184 KB | 22,485 | 6/6 | 1.4 ث | "Satoshi Nakamoto" و"proof-of-work" و"Conclusion" موجودة |
| PDF ممسوح ضوئيًا (بلا طبقة نصية) | 89 KB | 0 | 0/4 | 15 مللي ثانية | خرج فارغ، بلا خطأ، بلا OCR |
| DOCX (test.docx) | 136 KB | 4,651 | — | 70 مللي ثانية | العناوين + جدول GFM؛ قيم UUID المضمَّنة بقيت سليمة |
| DOCX مع معادلات | 15 KB | 240 | — | 101 مللي ثانية | Office Math حُفظ بصيغة LaTeX |
| XLSX (test.xlsx) | 12 KB | 808 | — | 57 مللي ثانية | كل ورقة → ## اسم_الورقة + جدول GFM |
| PPTX (test.pptx) | 278 KB | 2,047 | — | 52 مللي ثانية | علامات أرقام الشرائح، والجداول، والمخطط → جدول |
كان استرجاع النص في ملفات PDF ذات الطبقة النصية ممتازًا — 7 من 7 مؤشرات متفق عليها مسبقًا في ورقة arXiv «Attention Is All You Need»، و6 من 6 في الورقة البيضاء لبيتكوين — ولم تفقد أي من ملفات Office رمز UUID واحدًا، أي لا يوجد فقدان صامت للمحتوى في ملفات الاختبار المرجعية الخاصة بالمشرفين. وهناك فائدة دقيقة لكنها مهمة: مسار DOCX (عبر mammoth) يحافظ على معادلات Office Math بصيغة LaTeX، بحيث يتحول equations.docx إلى رياضيات حقيقية بصيغة $$...$$. إذا كنت تغذّي نماذج لغوية بمستندات Word غنية بالمعادلات، فهذه ميزة فعلية، وإن كانت متخصصة، ولم أجدها موثقة بوضوح في مكان آخر.
وهناك نتيجتان في هذا المجال تستحقان وقفة خاصة، لأنهما الأكثر احتمالًا لإيقاعك في الخطأ.
ملف الـ PDF الممسوح ضوئيًا الذي يختفي
إذا أعطيت MarkItDown ملف PDF مصوَّرًا فقط بلا طبقة نصية، فسيُرجع سلسلة فارغة. صفر محارف، بلا استثناء، بلا تحذير — ويكتمل التحويل في نحو 15 مللي ثانية لأن هناك لا شيء يمكن استخراجه. مسار PDF في MarkItDown يعتمد على استخراج النص فقط (pdfminer وpdfplumber في الخلفية)، ولا يضم OCR في التثبيت الأساسي ولا ضمن أي خيار pip إضافي.
وهذا مهم جدًا عند المعالجة الدفعية. المطوّر الذي يمرر مجلدًا من ملفات PDF، وفيه بعض الملفات الممسوحة ضوئيًا، سيحصل على نتائج فارغة بصمت لتلك الملفات من دون أي إشارة إلى أنه تم تجاوزها. وقد تحققت من أن العينة نفسها ليست مكسورة عبر تشغيل extract_text الخاص بـ pdfminer مباشرة عليها — وكانت النتيجة صفر محارف مقتطعة، بلا طبقة نصية، وهذا يؤكد أن السلوك الفارغ هو السلوك الحقيقي لـ MarkItDown على ملف ممسوح ضوئيًا فعليًا. وهذا يعيد إنتاج فجوة قديمة في الرجوع إلى OCR (#1268) ما زالت مفتوحة منذ فترة. والطريق الموثق هنا هو استخدام Azure Document Intelligence كخلفية اختيارية أو إضافة plugin؛ ولا شيء منهما موجود في التثبيت الافتراضي.
ملفات PDF تخرج كنص مسطح لا كبنية
في كلا ملفي PDF ذوي الطبقة النصية، لم يُنتج MarkItDown أي مؤشرات عناوين Markdown. ملف PDF لا يحتوي على وسوم دلالية للعناوين، وMarkItDown لا يستنتجها من حجم الخط، لذلك تقع كل الأسطر على مستوى النص الأساسي. استرجاع النص ممتاز، لكن البنية مسطحة.
وهذا ليس مجرد انطباعي الشخصي. فالمعايير العامة المنشورة تقيّم هرمية عناوين PDF في MarkItDown بنحو 0.0، وتقيّم دقة الجداول بحوالي 0.27، وهو أقل بكثير من 0.88 في Docling المدعوم بـ TableFormer (انظر مقارنة MarkItDown vs Docling vs Marker ومعيار READoc). ونتائجي تعيد إنتاج هذه الصورة، وهذه نقطة قوة في الدليل، لأن أرقامي تتفق مع مصدر خارجي. والمقابل الذي تذكره هذه المعايير نفسها هو أن MarkItDown أسرع بنحو 100 مرة من Docling، وهو ما يتوافق مع أزمنة الثواني لا الدقائق التي رأيتها في مستندات تستهلك فيها أدوات النمذجة البنيوية دقائق عدة. والخلاصة: MarkItDown يمنحك نص PDF نظيفًا وسريعًا، لكنه لا يمنحك بنية الـ PDF. إذا كانت العناوين والجداول يجب أن تبقى سليمة، فالأداة المناسبة هي Docling أو Marker.
الجداول: المحتوى ينجو دائمًا، لكن البنية لا تنجو دائمًا
الجداول هي الموضع الذي ينفصل فيه سؤال «هل بقي النص؟» عن سؤال «هل البيانات صالحة للاستخدام؟»، لذلك بنيت مصفوفة من 13 حالة — جدول HTML واحد لكل حالة، مع تقييم كل حالة مقابل قائمة مرجعية أُعدت قبل التشغيل — لمعرفة بدقة أي الأشكال تصمد وأيها يتعثر.
العنوان الأبرز: MarkItDown لم يفقد محتوى أي جدول أبدًا. فكل الحالات الـ13 احتفظت بنسبة 100% من الرموز المحددة مسبقًا. لكن الدقة البنيوية انقسمت إلى ثلاثة مستويات. سبع حالات من أصل 13 خرجت بشبكة GFM سليمة (الجدول البسيط، وجدول العنوان-امتداد-عمود، والجدول عريض 24 عمودًا، والجدول بلا رأس، وجدول الخلايا الفارغة، والخانة التي بداخلها كتلة، والجدول العربي من اليمين إلى اليسار). وأربع حالات خرجت بشكل رديء، لأن Markdown لا يملك مفهوم الخلية الممتدة، لذا فإن rowspan وcolspan والمصادر المشوَّهة تنتج صفوفًا قصيرة. وحالتان كانتا مكسورتين تمامًا.
والحالتان المكسورتان تستحقان التسمية. الجدول المتداخل (أي <table> داخل <td>) يُسطَّح داخل السطر، فيسكب أنابيبه وصفّه الفاصل داخل خلية الجدول الأصلية، وينتج صفًا عشوائيًا يبدو وكأنه يحتوي على 14 «عمودًا». كما أن الرمز | الحرفي داخل الخلية لا يُهرب — فالنص a | b يتحول إلى عمودين، وx || y يتحول إلى ثلاثة — ولذلك فإن جدولًا من عمودين قد يخرج بصفوف من عمودين وثلاثة وأربعة أعمدة، وأي محلل Markdown لاحق سيقرأ الحدود بشكل خاطئ. ومن الغريب أن النجوم والشرطات المائلة العكسية داخل الخلية تُهرب بالفعل، أما الأنابيب فلا. والسبب الجذري هو أن مسار HTML في MarkItDown يستخدم معالجة الجداول الافتراضية في markdownify، بينما تتجاوز فئته المخصصة الروابط والصور والعناوين فقط، لا خلايا الجداول. وتوجد فئة الخطأ نفسها المتعلقة بعدم الهروب من الأنابيب كـ مشكلة مفتوحة في محوّل CSV (#2019)، لكن ذلك الإصلاح لا يمس مسار HTML الذي اختبرته هنا.
أما الحالة الدقيقة — وهي النتيجة التي كنت أود لو يراها مهندس بيانات تحديدًا — فهي rowspan. الحالة t03 لا تصبح رديئة فحسب؛ بل تزيح البيانات بصمت. تسمية rowspan=2 مثل «Fruit» تُخرَج مرة واحدة فقط، ثم يصبح الصف الذي تحتها صفًا قصيرًا من عمودين (| Banana | 8 |)، فينتهي الأمر بكلمة «Banana» تحت عمود Group بدلًا من Item. كل الرموز موجودة. لكن أي مستهلك بسيط يعتمد على «اقرأ العمود الثاني» سيأخذ القيمة الخطأ. هذا نوع من الأخطاء ينجح أمام اختبار بقاء النص، لكنه يفسد مجموعة البيانات بصمت.
والقيد نفسه الخاص بالامتدادات هو قيد تصميم معروف ومُتتبَّع (#1211، #1248) — فشبكة GFM المسطحة لا تستطيع فعلًا تمثيل الامتدادات أو التداخل، لذلك يضحّي المحوّل بالبنية مقابل اكتمال المحتوى. وهناك سلوكيات جيدة أيضًا: الجداول بلا رأس تحصل على صف رأس فارغ مُولَّد تلقائيًا (حتى لا تُرفع البيانات بصمت إلى عنوان)، والخلايا الفارغة تُحفظ، ووسم <caption> يبقى كسطر نصي فوق الجدول.
التثبيت ووقت البدء: الضريبة التي لا يحذرك منها وصف «أداة خفيفة»
لم يفاجئني شيء هنا بقدر هذا الجزء، وهو الموضع الذي يبالغ فيه وصف «أداة Python خفيفة» من غير أن يقول ذلك صراحة.
أولًا، لا تشغّل pip install 'markitdown[all]'. على Python 3.14، سيتراجع بصمت إلى markitdown 0.0.2 — إصدار عمره سنتان — وقد كررت ذلك مباشرة في بيئة افتراضية نظيفة. وعند التثبيت الثابت يتضح السبب: pip install 'markitdown[all]==0.1.6' يفشل لأن الإضافة [all] تثبّت youtube-transcript-api~=1.0.0، وفي PyPI الحالي كل الإصدارات ضمن هذا النطاق محصورة في Python أقل من 3.14، بينما الإصدارات المتوافقة مع 3.14 تقع خارج هذا التثبيت المقيد. لذلك يعود الـ resolver إلى أقدم إصدار يمكنه إرضاء الاعتماديات. وهذا يتوافق مع مشكلة مفتوحة upstream (#2179). والحل مباشر: ثبّت الإصدار أولًا، ثم أضف الإضافات كلٌّ على حدة: pip install 'markitdown==0.1.6'، ثم pip install 'markitdown[pdf,docx,pptx,xlsx,xls]==0.1.6'. كل واحدة من هذه الأوامر تعمل بسلاسة؛ المشكلة فقط في حزمة [all] المجمّعة التي تحمل التثبيت المعيب. (وهذه الفخّة تعتمد على إصدار Python — ففي Python 3.13 أو أقدم قد لا تظهر المشكلة بهذه الصورة، لذا قد يُحلَّل [all] بشكل مختلف.)
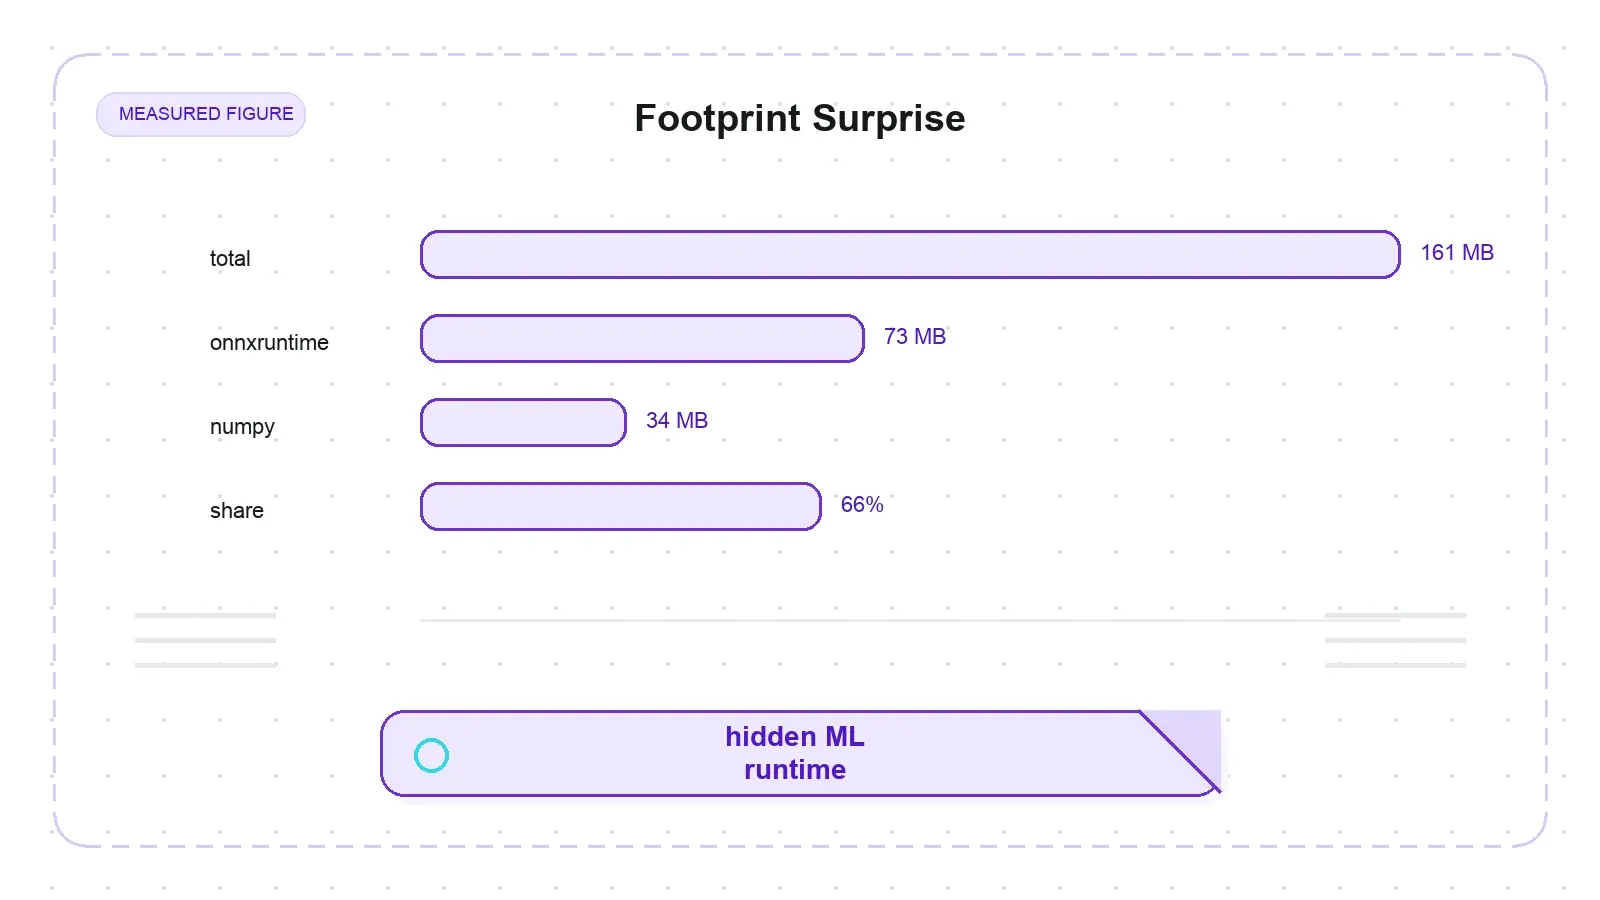
ثانيًا، حجم الحزمة. التثبيت الأساسي يصل إلى 161 ميجابايت (بيئة افتراضية فارغة بحجم 13 ميجابايت + 148 ميجابايت إضافية). ومن هذا الحجم، يشكل كلٌّ من onnxruntime (73 ميجابايت) وnumpy (34 ميجابايت) معًا 107 ميجابايت — أي 66% من إجمالي البصمة الأساسية — وكلاهما يأتي عبر اعتماد مباشر واحد: magika، وهو كاشف نوع الملفات بالتعلم الآلي من Google. أي أن محوّلًا للنصوص يشحن مع التثبيت الأساسي بيئة تشغيل ONNX حجمها 73 ميجابايت قبل أن تضيف أي ملحق خاص بالمستندات. وإذا أضفت ملحقات المستندات كلها، يصل حجم البيئة إلى 310 ميجابايت. هذا أخف كثيرًا من حزمة متصفح بدون واجهة، لكن إذا كنت تتوقع أداة صغيرة من نوع «pip install وانتهينا»، فاعرف أن بيئة ONNX سترافقك.
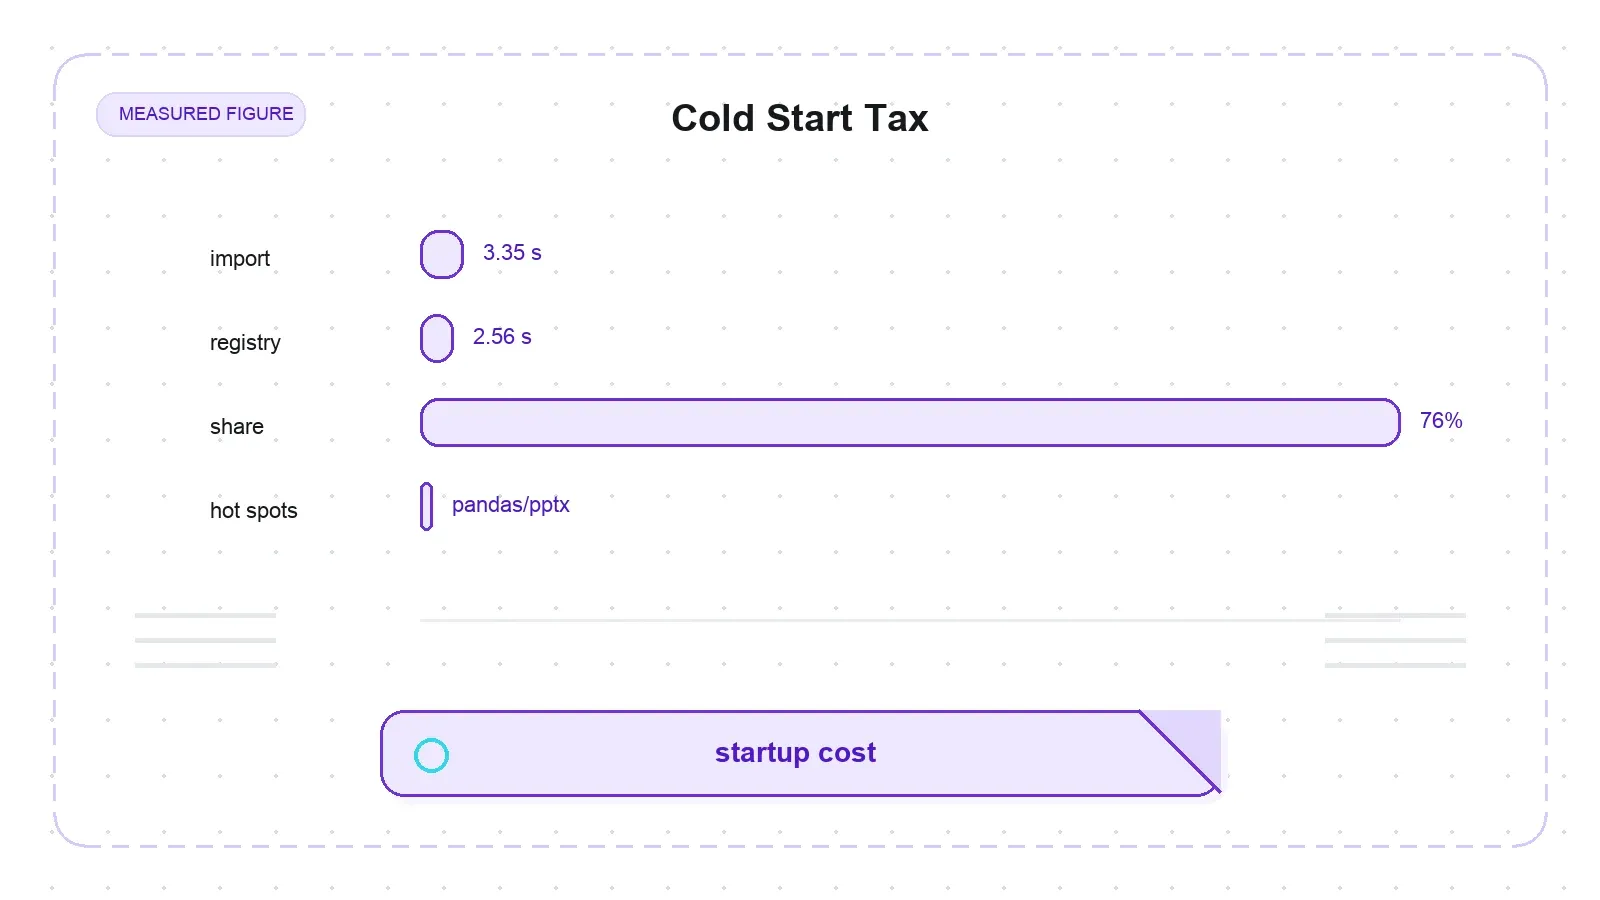
ثالثًا — وهذه هي النتيجة الوحيدة في هذه المجموعة التي اجتازت كل اختبارات الحداثة التي أجريتها — حتى بعد تثبيت نظيف، فإن import markitdown يكلّف نحو 3.35 ثانية على هذا الجهاز. والتكلفة تقع تقريبًا كلها في وقت الاستيراد نفسه: markitdown._markitdown يستورد مسبقًا سجل المحوّلات بالكامل (2.56 ثانية متراكمة، أي 76% من الإجمالي)، وهذا يسحب معه pandas (1.21 ثانية عبر محوّل XLSX)، وpython-pptx (427 مللي ثانية)، وmagika (354 مللي ثانية)، وrequests (270 مللي ثانية) — سواء كنت ستستخدم هذه الصيغ أم لا. في خدمة طويلة التشغيل، هذه الكلفة تتوزع وتصبح غير مهمة. أما في استدعاء CLI أو بدء تشغيل بارد ضمن خادم عديم الحالة، فهي ضريبة فعلية على كل عملية لا يتوقعها وصف «أداة خفيفة». (وملاحظة عادلة: هذا تشغيل واحد ملفوف بالقياس، أي ملاحظة واحدة، لا توزيع متعدد التشغيلات.)
على نطاق كبير: لا يتعطل، لكن احسب CPU للـ PDF وRAM للجداول
مرّرت أربعة موضوعات كبيرة عبر الأداة، كل واحد في عملية منفصلة حتى لا تتلوث ذروة الذاكرة من تشغيل سابق. لم ينهَر شيء. لكن نمط التكلفة غير متوازن.
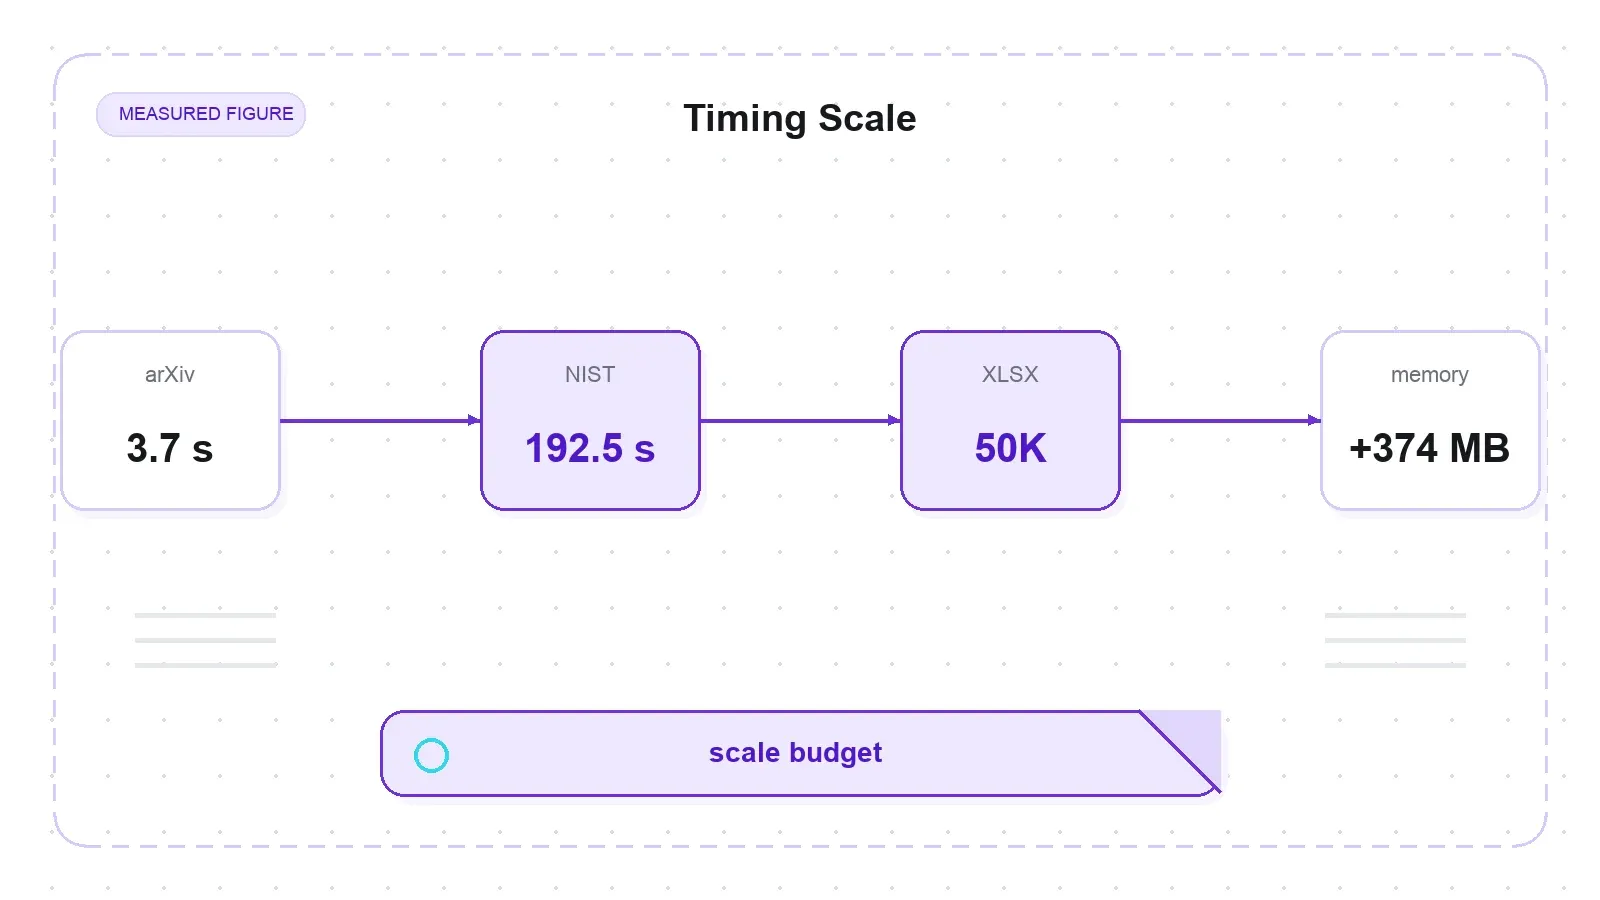
| الموضوع | الإدخال | عدد أحرف الخرج | الزمن الوسيط | أعلى زيادة في RSS |
|---|---|---|---|---|
| NIST SP 800-53r5 (PDF من 492 صفحة) | 6.07 MB | 1,625,365 | 192.5 ث | +40 MB |
| XLSX بـ 50,000 صف × 8 أعمدة | 2.1 MB | 3,722,955 | 62.1 ث | +374 MB |
| arXiv 1706.03762 (PDF بنحو 15 صفحة) | 2.2 MB | 40,174 | 12.6 ث | +25 MB |
| XLSX بـ 200 صف × 64 عمودًا | 46 KB | 120,129 | 2.9 ث | +22 MB |
ملف NIST PDF المكوَّن من 492 صفحة احتاج في الوسيط إلى 192.5 ثانية — أي نحو 3.2 دقيقة، أو 0.39 ثانية لكل صفحة — لأن pdfplumber يجري كشف الحقول/النماذج عبر مواضع الكلمات في كل صفحة. وبقيت زيادة RSS القصوى عند +40 ميجابايت، أي إن المشكلة هنا CPU وليس ذاكرة. حتى PDF الخاص بـ arXiv من 15 صفحة استغرق 12.6 ثانية في عملية منفصلة، وهو تقريبًا 3.4 مرات الزمن الذي ظهر لنفس الملف عندما كان التشغيل دافئًا ضمن مجموعة المستندات لدي. هذه الفجوة هي كلفة العملية الباردة، وتؤكد أن العمل لكل صفحة هو السبب الرئيسي وليس حجم الملف الخام. وإذا أردت رقمًا واحدًا قابلًا للنقل لذلك الـ PDF، فاستخدم 12.6 ثانية في التشغيل المعزول.
أما مسار الجداول فيعكس عنق الزجاجة. فقد تضخم ملف XLSX بحجم 2.1 ميجابايت ويحتوي 50,000 صف إلى +374 ميجابايت RSS في الذروة (و3.7 مليون حرف خرج) لأن المحوّل يحمّل الورقة كاملة ويبني سلسلة Markdown ضخمة واحدة في الذاكرة. إذن الإرشاد العملي واضح: للـ PDF الكبير، احسب دقائق من CPU؛ ولجدول البيانات الكبير، احسب مئات الميجابايت من RAM. هذه أرقام من جهاز واحد على macOS arm64 وPython 3.14، والثوابت لكل صفحة ولكل صف تعتمد على المنصة — لكن الشكل العام (PDF بطيء ويستهلك CPU، وXLSX يستهلك الذاكرة، ولا شيء ينهار) هو الجزء الذي ينتقل فعلًا.
أين يناسب Thunderbit — وأين لا يناسبه
جرّب Thunderbit لاستخراج بيانات الويب
هذه المقارنة بالذات سهلة المبالغة، لذلك سأرسم الحد بدقة. MarkItDown وThunderbit يحلان مشكلتين متجاورتين، لا المشكلة نفسها.
MarkItDown يحوّل الملفات التي لديك أصلًا. أما Thunderbit فيقوم أولًا بجلب الصفحة. نقطة النهاية /distill في Thunderbit تحوّل صفحة ويب حيّة إلى Markdown نظيف جاهز للنماذج اللغوية — مع معالجة تنفيذ JavaScript، والحماية من البوتات، والمحتوى الديناميكي الذي لا يملك MarkItDown أي آلية للتعامل معه — بينما تعيد نقطة النهاية /extract JSON منظمًا مطابقًا للمخطط، لا Markdown خامًا فقط. وللمطورين، يتوفر ذلك عبر API (POST /distill / POST /extract)، وخادم MCP، وسطر أوامر (npx @thunderbit/thunderbit-cli) يعمل فوق محرك ذكاء اصطناعي واحد، وهو نفسه الذي يقف خلف الإضافة التي يستخدمها أكثر من 100,000 مستخدم.
إذًا التداخل بينهما في نقطة واحدة فقط — كلاهما يمكنه إخراج «Markdown جاهز للنماذج اللغوية» — لكن نطاق الإدخال مختلف: Thunderbit distill يأخذ عنوان URL من الويب المفتوح، بينما MarkItDown يأخذ ملفًا محليًا. وهما ليسا بديلين مباشرين، ولا أريد التظاهر بذلك. الاستخدام الواقعي يجمعهما: اجلب الويب وازحف فيه عبر Thunderbit (أو خدمة على نمط Firecrawl)، ثم وحِّد المستندات المحلية المختلطة التي لديك أيضًا — مثل PDF والعروض وجداول البيانات — باستخدام MarkItDown. واحد يتعامل مع الشبكة؛ والآخر يتعامل مع درج الملفات.
الإيجابيات والسلبيات
نقاط القوة
- استرجاع كامل لمحتوى body في HTML النظيف (4/4 صفحات)، مع الحفاظ الأمين على شجرة العناوين والروابط
- استرجاع قوي لنص PDF/DOCX (arXiv 7/7 مؤشرات، وBitcoin 6/6) من دون فقدان صامت في ملفات Office الخاصة بالمشرفين
- الحفاظ على معادلات Office Math بصيغة LaTeX — ميزة متخصصة لكنها حقيقية
- لم يتعطل أبدًا في أي حجم اختبرته، حتى مع PDF من 492 صفحة وXLSX من 50 ألف صف
- سهل الاستدعاء: CLI، و
convert()، والتمرير عبر stdin، وخادم MCP اختياري - مرخّص MIT، ومُدار بنشاط من Microsoft، ونظام القضايا فيه متجاوب
نقاط الضعف
- يحتفظ بالعناصر الجانبية — حتى 12.4% من الأسطر في ويكيبيديا؛ ليس مستخرج مقالات
- الجداول تتعثر مع الامتدادات والتداخل والأنابيب داخل الخلية (2/13 مكسورة، و4/13 رديئة)، وrowspan قد يزيح البيانات بصمت
- ملفات PDF المصوّرة/الممسوحة تعود بخراج فارغ من دون OCR ومن دون خطأ
- خرج PDF بلا أي بنية عناوين (وهذا يتوافق مع المعايير العامة المنشورة)
- تثبيت أساسي بحجم 161 ميجابايت مع بيئة تشغيل ONNX بحجم 73 ميجابايت؛ و~3.35 ثانية لاستيراد بارد
- إضافة
[all]تتراجع بصمت إلى الإصدار القديم 0.0.2 على Python 3.14
من يجب أن يستخدمه، ومن يجب ألا يستخدمه
استخدم MarkItDown إذا كنت توحّد مجموعة كبيرة من المستندات المحلية المختلطة — Word وExcel وPowerPoint وPDF ذات الطبقة النصية — إلى Markdown ضمن خط معالجة لنموذج لغوي، وكنت تهتم بالنص الكامل أكثر من البنية المحفوظة. كمرحلة أخيرة في مهمة دفعية، لتغذية نموذج بنص نظيف، فهو سريع وأمين ومجاني.
أما إذا كانت مهمتك واحدة من هذه، فإما أن تتجنبه أو تقرنْه بأداة أخرى: إذا كنت تحتاج فقط إلى المقال الرئيسي من صفحة ويب، فاستعمل أداة قراءة أو خدمة على نمط Firecrawl؛ وإذا كنت تحتاج إلى بقاء عناوين PDF وجداولها كما هي، فهذا مجال Docling أو Marker؛ وإذا كانت مدخلاتك تشمل مستندات ممسوحة ضوئيًا تحتاج إلى OCR، فستحتاج إلى Azure backend أو إلى أداة أخرى بالكامل. وإذا كنت تعتقد أنك تبحث عن أداة scraper — أي شيء يجلب ويزحف — فهذا ليس ذلك على الإطلاق.
التقييم المبدئي الذي أجرته، وفق معيار يشبه معيار أدوات scraping، وضع MarkItDown عند 60/100، وهذا الرقم المنخفض هو أثر جانبي لتقييم محوّل بمعيار أداة زحف. أما على أرضه هو، فدرجاته في دقة النص عالية؛ ونقاط ضعفه هي بنيوية (الجداول، عناوين PDF) وحِزْمية/تغليفية (الحجم، الاستيراد، فخ [all])، لا في جودة النص. فإذا حكمت عليه على أنه ما هو عليه — محوّل ملفات إلى Markdown — فستجده أداة قوية ومصانة جيدًا، مع بعض الحواف الحادة التي ينبغي معرفتها قبل إدخالها إلى الإنتاج.
الأسئلة الشائعة
هل MarkItDown أداة زحف ويب؟
لا. لا يحتوي على زاحف، ولا تنفيذ JavaScript، ولا تتبّع روابط، ولا تنقّل بين الصفحات. هو يحول الملفات والمستندات التي لديك أصلًا — مثل PDF وDOCX وXLSX وPPTX والصور وHTML — إلى Markdown. إذا كنت تحتاج إلى جلب صفحات ويب حيّة والزحف فيها، فأنت بحاجة إلى أداة scraping مثل Thunderbit أو Firecrawl؛ أما MarkItDown فهو المرحلة التي تأتي بعد ذلك، أي تحويل الملفات المحلية أو التي تم جلبها إلى Markdown نظيف.
لماذا يؤدي pip install markitdown[all] إلى تثبيت إصدار قديم؟
على Python 3.14، تضبط الإضافة [all] الاعتماد youtube-transcript-api~=1.0.0، وكل الإصدارات ضمن هذا النطاق مقيدة بإصدارات Python أقل من 3.14. ولا يستطيع الـ resolver إرضاء هذا التثبيت، فيتراجع بصمت إلى markitdown 0.0.2، وهو إصدار عمره سنتان. والحل هو تثبيت الإصدار ثم إضافة الإضافات كلٌّ على حدة: pip install 'markitdown==0.1.6'، ثم pip install 'markitdown[pdf,docx,pptx,xlsx,xls]==0.1.6'. وهذه المشكلة موثقة في المشكلة #2179.
هل يقوم MarkItDown بعمل OCR على ملفات PDF الممسوحة ضوئيًا؟
ليس في التثبيت الافتراضي. مسار PDF فيه يعتمد على استخراج النص فقط، لذلك فإن ملف PDF المصوَّر بلا طبقة نصية يعود بسلسلة فارغة — من دون خطأ ومن دون تحذير. وOCR يتطلب Azure Document Intelligence backend الاختياري أو plugin، وهما غير موجودين في التثبيت الافتراضي. وهذه فجوة معروفة منذ مدة طويلة (المشكلة #1268).
ما مدى جودة MarkItDown في التعامل مع الجداول؟
من ناحية المحتوى، ممتاز جدًا — ففي اختباري ذي 13 حالة احتفظ بكل محتوى الجداول في كل حالة. لكن من ناحية البنية، يعتمد الأمر على الشكل: الجداول البسيطة والواسعة وبلا رأس وبها خلايا فارغة تخرج كشبكات GFM نظيفة، أما rowspan وcolspan فيجعلان الشكل رديئًا (وقد يزيح rowspan البيانات بصمت إلى عمود خاطئ)، والجداول المتداخلة تُسطَّح إلى صفوف مشوّهة، والأنابيب الحرفية داخل الخلايا لا تُهرب. تنسيق Markdown الجدولي المسطَّح ببساطة لا يستطيع تمثيل الامتدادات أو التداخل.
هل MarkItDown سريع بما يكفي للمستندات الكبيرة؟
هو لا ينهار مع الملفات الكبيرة، لكن عليك أن تخطط للموارد بحسب النوع. ملف PDF من 492 صفحة استغرق نحو 3.2 دقيقة (حوالي 0.39 ثانية لكل صفحة) لأنه يجري كشف النماذج لكل صفحة، ولذلك فهو معتمد على CPU. أما جدول بيانات بـ 50,000 صف فأنهى العمل في نحو دقيقة، لكنه استخدم +374 ميجابايت من RAM لأنه يبني سلسلة Markdown كبيرة واحدة في الذاكرة. للـ PDF الكبيرة، احسب دقائق من CPU؛ ولجداول البيانات الكبيرة، احسب مئات الميجابايت من RAM.
جرّب Thunderbit لاستخراج بيانات الويب Get Started Free




