
الملخص التنفيذي
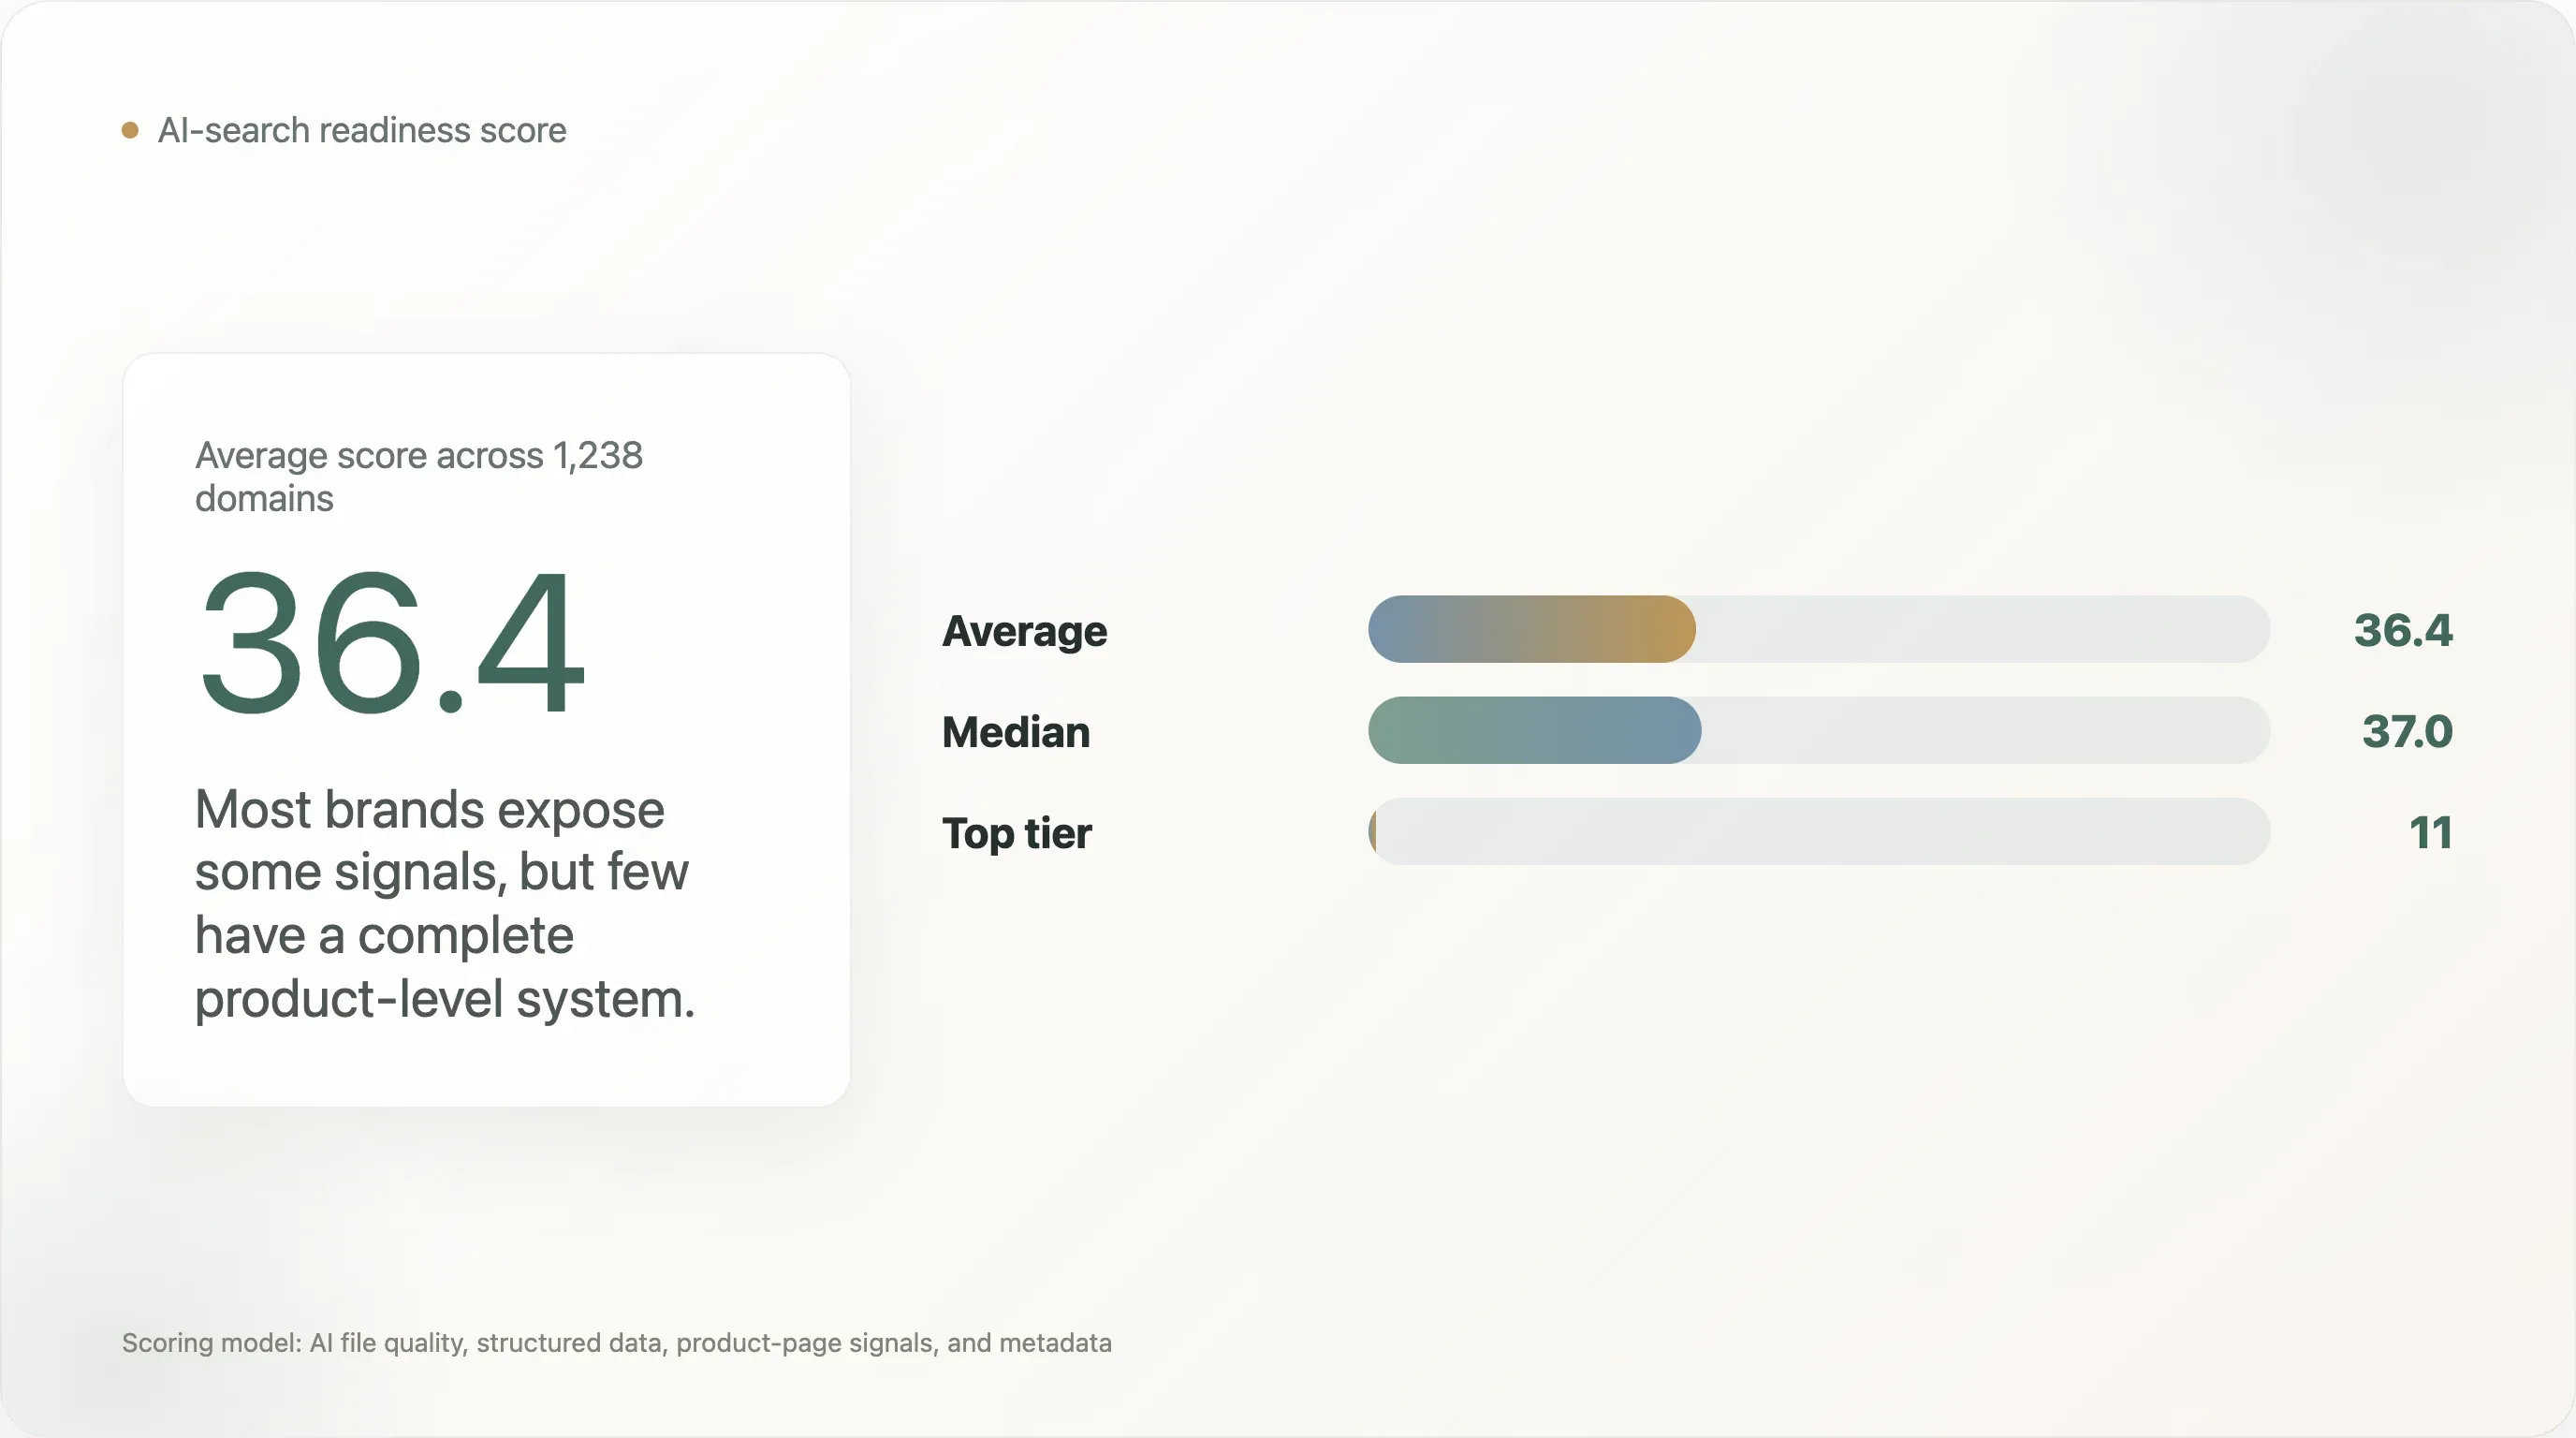
يُقيّم هذا البحث 1,238 نطاقًا من نطاقات DTC من حيث الجاهزية للبحث بالذكاء الاصطناعي عبر أربعة مستويات: جودة ملف الذكاء الاصطناعي، والبيانات المنظمة العامة، والإشارات المنظمة في صفحات المنتجات، والبيانات الوصفية. بلغ متوسط النتيجة 36.4 من 100، والوسيط 37.0. ولم يصل إلى فئة ai_ready وفق هذا النموذج إلا 11 نطاقًا.
أهم نتيجة هي الفجوة بين سهولة الاكتشاف على السطح والفهم على مستوى المنتج. أكبر شريحة في جودة llms.txt كانت platform_default، مع 629 نطاقًا. وهذا يعني أن كثيرًا من العلامات التجارية لديها ملف قابل للقراءة آليًا لأن منصتها أنشأته تلقائيًا. لكن مخطط Product في الصفحة الرئيسية ظهر في 0.9% فقط من النطاقات التي خضعت للتقييم، بينما ظهر مخطط Product في صفحات المنتجات في 39.2% من النطاقات التي جرى فيها اختبار صفحات المنتجات. كما ظهرت إشارات السعر في صفحات المنتجات في 48.1%، وإشارات التقييمات أو المراجعات في 43.5%.
ويُظهر توزيع الفئات مدى بدائية السوق حتى الآن:
| فئة الجاهزية للذكاء الاصطناعي | النطاقات |
|---|---|
| غير جاهز | 435 |
| جاهز جزئيًا | 425 |
| قابل للاكتشاف بشكل أساسي | 367 |
| جاهز للذكاء الاصطناعي | 11 |
هذا التقسيم مفيد لأنه يفرّق بين ثلاث أفكار غالبًا ما تختلط معًا. قد تكون العلامة قابلة للاكتشاف. وقد يكون لديها بيانات وصفية. وقد يكون لديها llms.txt. لكن قابلية الاكتشاف ليست هي نفسها الفهم على مستوى المنتج.
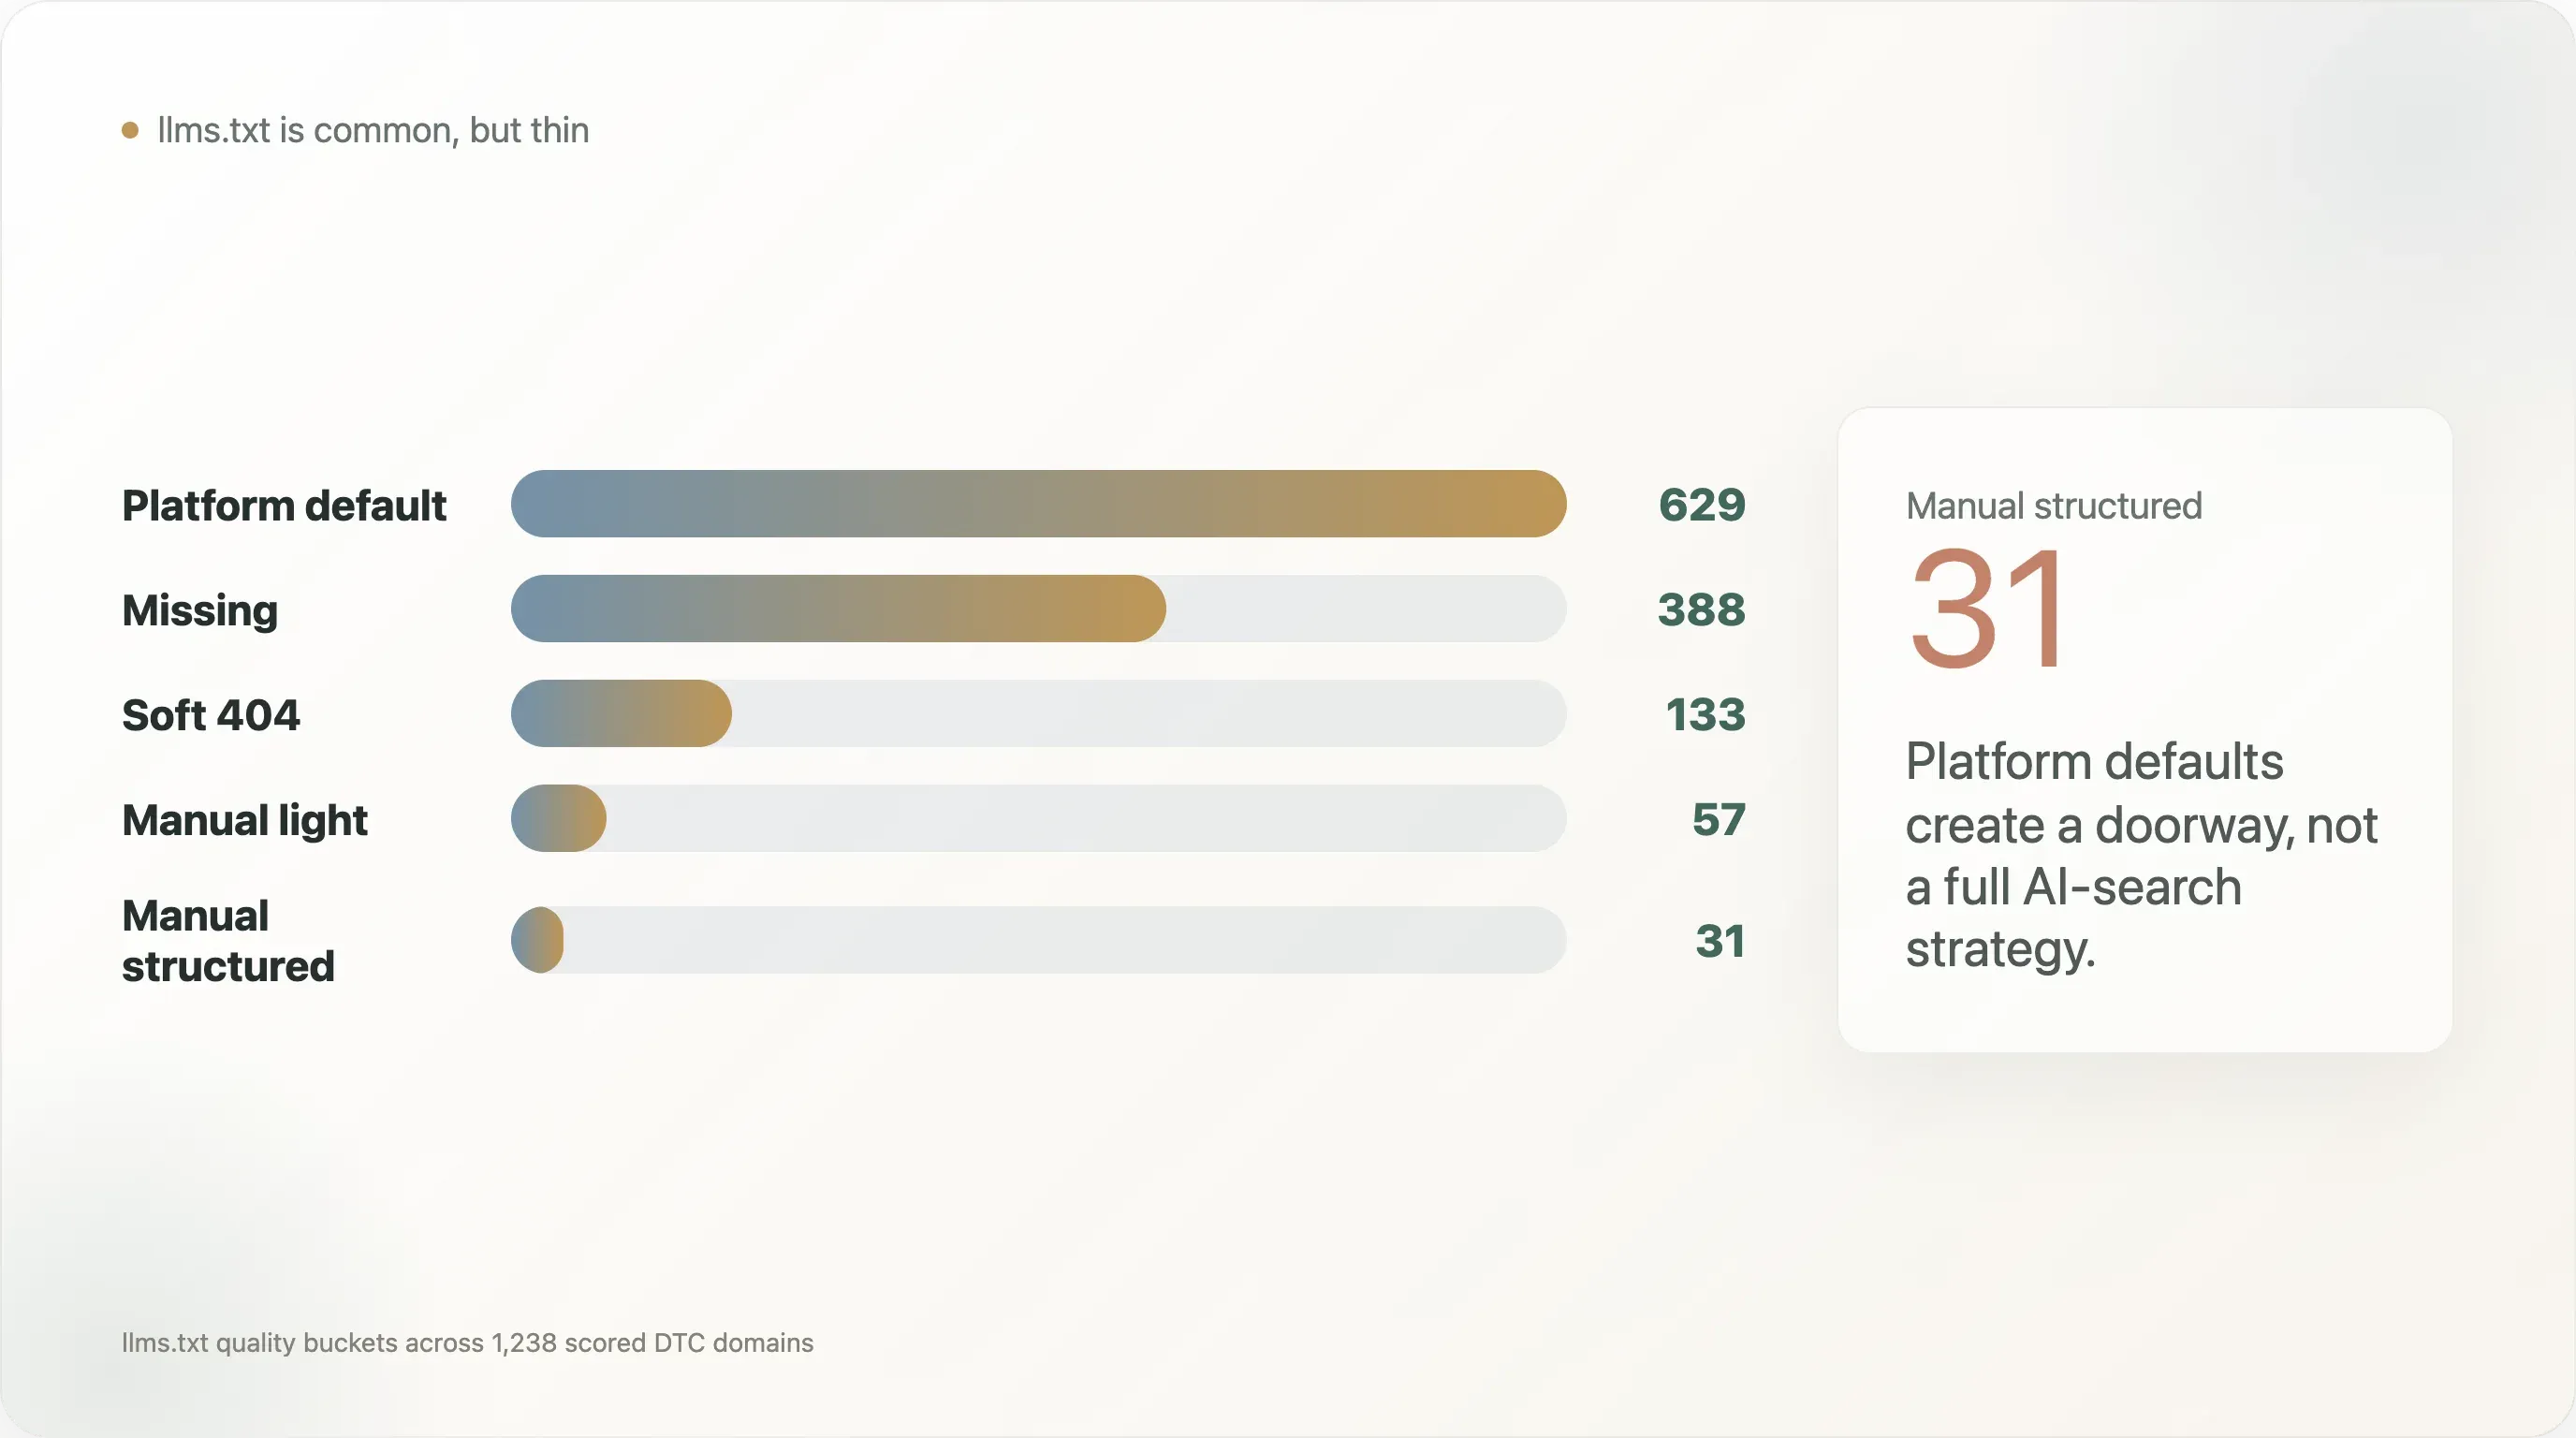
ويجعل توزيع جودة llms.txt هذه النقطة أوضح:
| شريحة جودة llms.txt | النطاقات |
|---|---|
| افتراضي من المنصة | 629 |
| مفقود | 388 |
| خطأ 404 ناعم | 133 |
| يدوي خفيف | 57 |
| يدوي منظم | 31 |
لذلك، فإن الزاوية الأقوى في التقرير ليست "علامات DTC لديها llms.txt". هذا عنوان سطحي أكثر من اللازم. الزاوية الأفضل هي: الافتراضات التي تنشئها المنصات وفّرت طبقة أولى رقيقة من قابلية الاكتشاف بالذكاء الاصطناعي، لكن معظم علامات DTC لم تبنِ بعد طبقة البيانات المنظمة على مستوى المنتج اللازمة للتسوق بالذكاء الاصطناعي ومحركات الإجابة.
وتُظهر الأمثلة الإيجابية كيف تبدو الجاهزية الأفضل. تشمل فئة ai_ready علامات مثل Mokobara وMagic Mind وLe Petit Ballon وMaine Lobster Now وYo Mama's Foods وLa Maison Convertible وUnbloat وNuRange Coffee وThree Ships Beauty وManukora. وهذه الأمثلة مهمة لأنها تُظهر أن الجاهزية للذكاء الاصطناعي ليست حكرًا على فئة واحدة أو نوع واحد من العلامات. فالأغذية، والجمال، والعافية، والأثاث، والملابس، والتجارة المتخصصة كلها تستطيع تحسين طبقة المنتج القابلة للقراءة آليًا.
أكثر النتائج قابلية للمشاركة
-
متوسط درجة جاهزية DTC للبحث بالذكاء الاصطناعي لا يتجاوز 36.4/100.
-
11 نطاقًا فقط من أصل 1,238 نطاقًا خاضعًا للتقييم وصلت إلى فئة
ai_ready. -
llms.txtشائع، لكنه في الغالب مُنشأ تلقائيًا من المنصة. أكبر شريحة جودة هي الافتراضي من المنصة، مع 629 نطاقًا. -
llms.txtالمنظم يدويًا نادر. لا يقع في شريحة اليدوي المنظم سوى 31 نطاقًا. -
مخطط Product في الصفحة الرئيسية شبه غائب. فهو يظهر في 0.9% فقط من النطاقات التي خضعت للتقييم.
-
مخطط Product في صفحات المنتجات أفضل، لكنه ما يزال غير مكتمل. يظهر في 39.2% من النطاقات التي جرى فيها اختبار صفحات المنتجات.
-
الجاهزية للتسوق بالذكاء الاصطناعي تحتاج إلى حقائق المنتج، لا مجرد الوصول عبر الزاحف. فالسعر، والعرض، والمراجعات، والتوافر، وإشارات Product schema أهم من ملف رقيق وحده.
1. لماذا تختلف جاهزية البحث بالذكاء الاصطناعي عن أساسيات SEO
يسأل SEO التقليدي ما إذا كانت الصفحة قابلة للزحف، والفهرسة، والترتيب، والنقر. أما البحث بالذكاء الاصطناعي فيضيف طبقة مختلفة: هل يستطيع النظام فهم العلامة، والمنتج، والعرض، والسعر، والمراجعات، والتوافر، والسياسات، وعلاقات الكيانات بما يكفي للإجابة عن الأسئلة أو التوصية بالمنتجات؟
هذا الفرق مهم في عالم DTC لأن صفحات التجارة الإلكترونية مليئة بتفاصيل قد تكون سهلة على الإنسان لكنها مربكة للآلة. فالمتسوق يمكنه النظر إلى صفحة المنتج وفهم اسم المنتج، والسعر، والحجم، وخيار الاشتراك، والخصم، والمراجعات، وحالة المخزون، وسياسة الإرجاع. لكن الزاحف أو وكيل الذكاء الاصطناعي يحتاج إلى أن تُعبَّر هذه الحقائق بشكل متسق.
البيانات الوصفية تساعد. وOpen Graph يساعد. والوسوم canonical تساعد. وقد يساعد llms.txt الزواحف في العثور على المحتوى المهم. لكن البنية على مستوى المنتج هي الاختبار الحقيقي. فإذا كان مساعد تسوق بالذكاء الاصطناعي يقارن بين خمسة أنواع من مسحوق البروتين، أو منتجات العناية بالبشرة، أو الشموع، أو الفساتين، أو اشتراكات القهوة، فهو يحتاج إلى حقائق منظمة. وبدون هذه الحقائق، قد تكون العلامة مرئية لكنها ليست مفهومة بشكل موثوق.
يقسّم هذا التقرير الجاهزية إلى أربعة مستويات:
- طبقة ملف الذكاء الاصطناعي: هل يوجد
llms.txt، وهل هو مفقود، أو 404 ناعم، أو افتراضي من المنصة، أو يدوي خفيف، أو يدوي منظم. - طبقة البيانات المنظمة العامة: JSON-LD، وOrganization، وWebSite، وBreadcrumbList، وProduct schema.
- طبقة صفحة المنتج: Product schema، وإشارات العرض أو السعر، وإشارات التقييم أو المراجعة، وإشارات التوافر.
- طبقة البيانات الوصفية: canonical، ووصف meta، وصورة Open Graph، وبطاقة Twitter، وhreflang، وسياق آلي مشابه.
هذا النموذج الطبقي مهم لأنه يمنع الاستنتاج السطحي. فالعلامة التي لديها llms.txt من دون حقائق المنتج ليست جاهزة كما تبدو. وقد تكون العلامة التي لا تملك llms.txt لكنها تعرض مخططًا غنيًا لصفحات المنتج أكثر قابلية للفهم مما توحي به طبقة الملف.
رؤية البيانات المنظمة للمنتج أثناء العمل
2. قصة llms.txt: طبقة رقيقة، تنشئها المنصات في الغالب
أسفر تدقيق llms.txt عن خمس شرائح جودة:
| شريحة الجودة | النطاقات | التفسير |
|---|---|---|
| افتراضي من المنصة | 629 | ملف قياسي تُنشئه المنصة تلقائيًا، يكون غالبًا رقيقًا لكنه صالح |
| مفقود | 388 | لم يُعثر على ملف قابل للاستخدام |
| خطأ 404 ناعم | 133 | استجابة مضللة أو غير مفيدة |
| يدوي خفيف | 57 | ملف أنشأه إنسان أو ملف مخصص، لكن ببنية محدودة |
| يدوي منظم | 31 | ملف يدوي أكثر ثراءً يتضمن عناوين وروابط ومصطلحات للمنتجات أو السياسات |
هذه هي النقطة الأهم في التقرير. فظاهريًا تبدو معدلات تبنّي llms.txt قوية لأن ملفات الافتراضي من المنصة شائعة. لكن الافتراضي من المنصة لا يعني استراتيجية مدروسة للبحث بالذكاء الاصطناعي. فهو غالبًا مجرد طبقة إشارة أولية.
ولا يعني هذا أن ملفات الافتراضي من المنصة بلا قيمة. فقد تساعد الزواحف في العثور على المسارات المهمة. كما أنها تُظهر مدى السرعة التي يمكن بها لقرارات المنصة أن تحرك السوق. فقد تمنح المنصة مئات المتاجر ملفًا آليًا جديدًا قبل أن تناقش معظم فرق العلامة التجارية عمليات البحث بالذكاء الاصطناعي أصلًا.
لكن شريحة اليدوي المنظم أصغر بكثير: 31 نطاقًا. ومن الأمثلة التي ظهرَت في التدقيق ملفات يدوية منظمة من علامات مثل Dermalogica وAd Hoc Atelier وDKNY، بالإضافة إلى أمثلة ai_ready مثل Magic Mind وLe Petit Ballon وMaine Lobster Now وYo Mama's Foods وThree Ships Beauty. وهذه أمثلة إيجابية مفيدة لأنها تُظهر معنى تجاوز الملف الافتراضي: روابط أكثر، وعناوين أكثر، ومصطلحات أكثر للمنتجات، ومصطلحات أكثر للسياسات، وبنية أكثر قصدًا.
كما أن شريحة 404 الناعم مهمة أيضًا. فـ 404 الناعم يعني أن الطلب يعود بشيءٍ ما، لكن ليس بملف llms.txt مفيد. وقد يضلّل هذا عمليات التدقيق البسيطة. وفي جاهزية البحث بالذكاء الاصطناعي، لا تكفي مجرد معرفة وجود الملف. ففحص الجودة مهم.
3. البنية على مستوى المنتج هي الفجوة الحقيقية
أقوى فجوة في البيانات هي مخطط Product.
يظهر مخطط Product في الصفحة الرئيسية في 0.9% فقط من النطاقات التي جرى تقييمها. ويظهر مخطط Product في صفحات المنتجات في 39.2% من النطاقات التي جرى فيها اختبار صفحات المنتجات. كما تظهر إشارات السعر في صفحات المنتجات في 48.1%، وتظهر إشارات المراجعات أو التقييمات في 43.5%.
هذه الأرقام تروي قصة واضحة. فحقائق المنتج الأساسية لا تكون قابلة للقراءة آليًا بشكل متسق، حتى عندما تمتلك العلامة متجرًا إلكترونيًا.
وهذا مهم لأن البحث بالذكاء الاصطناعي والتسوق بالذكاء الاصطناعي من المرجح أن يكافئا الوضوح. فإذا كانت صفحة المنتج تعرض Product schema، والعروض، والسعر، والتوافر، وإشارات المراجعات، وروابط السياسات، فإنها تمنح الآلات حقائق أكثر موثوقية. أما إذا كانت هذه الحقائق مخبأة داخل JavaScript، أو قوالب غير متسقة، أو صور، أو عناصر واجهة ديناميكية، فقد يساء فهمها أو يتم تجاهلها.
الفجوة في الجاهزية لا تتعلق بالترتيب فقط. إنها تتعلق بالتمثيل. فعندما تُلخّص أنظمة الذكاء الاصطناعي فئة منتجات، أو تقارن بين الخيارات، أو تجيب عن أسئلة "الأفضل لـ"، أو تولّد توصيات تسوق، تكون العلامات التي تملك حقائق منتج أوضح أسهل في الإدراج الدقيق.
وتؤكد الأمثلة الإيجابية من مجموعة ai_ready هذه الفكرة:
- Mokobara حققت أعلى درجة في النتائج، وهي 83.
- Magic Mind وLe Petit Ballon وMaine Lobster Now حققت 81.
- Yo Mama's Foods حققت 80.
- La Maison Convertible وUnbloat وVinocheepo وNuRange Coffee حققت 79.
- Three Ships Beauty حققت 77.
- Manukora حققت 75.
تغطي هذه الأمثلة فئات متعددة. فالجاهزية للذكاء الاصطناعي ليست مشكلة تقتصر على الجمال أو التقنية. إنها مهمة للأغذية، والعافية، والأثاث، والملابس، والمنتجات المتخصصة، وأي فئة قد يطلب فيها المتسوق من نظام ذكاء اصطناعي توصيات أو مقارنات أو شروحات.
4. شرائح الجاهزية للذكاء الاصطناعي: معظم العلامات ما تزال تحت الخط
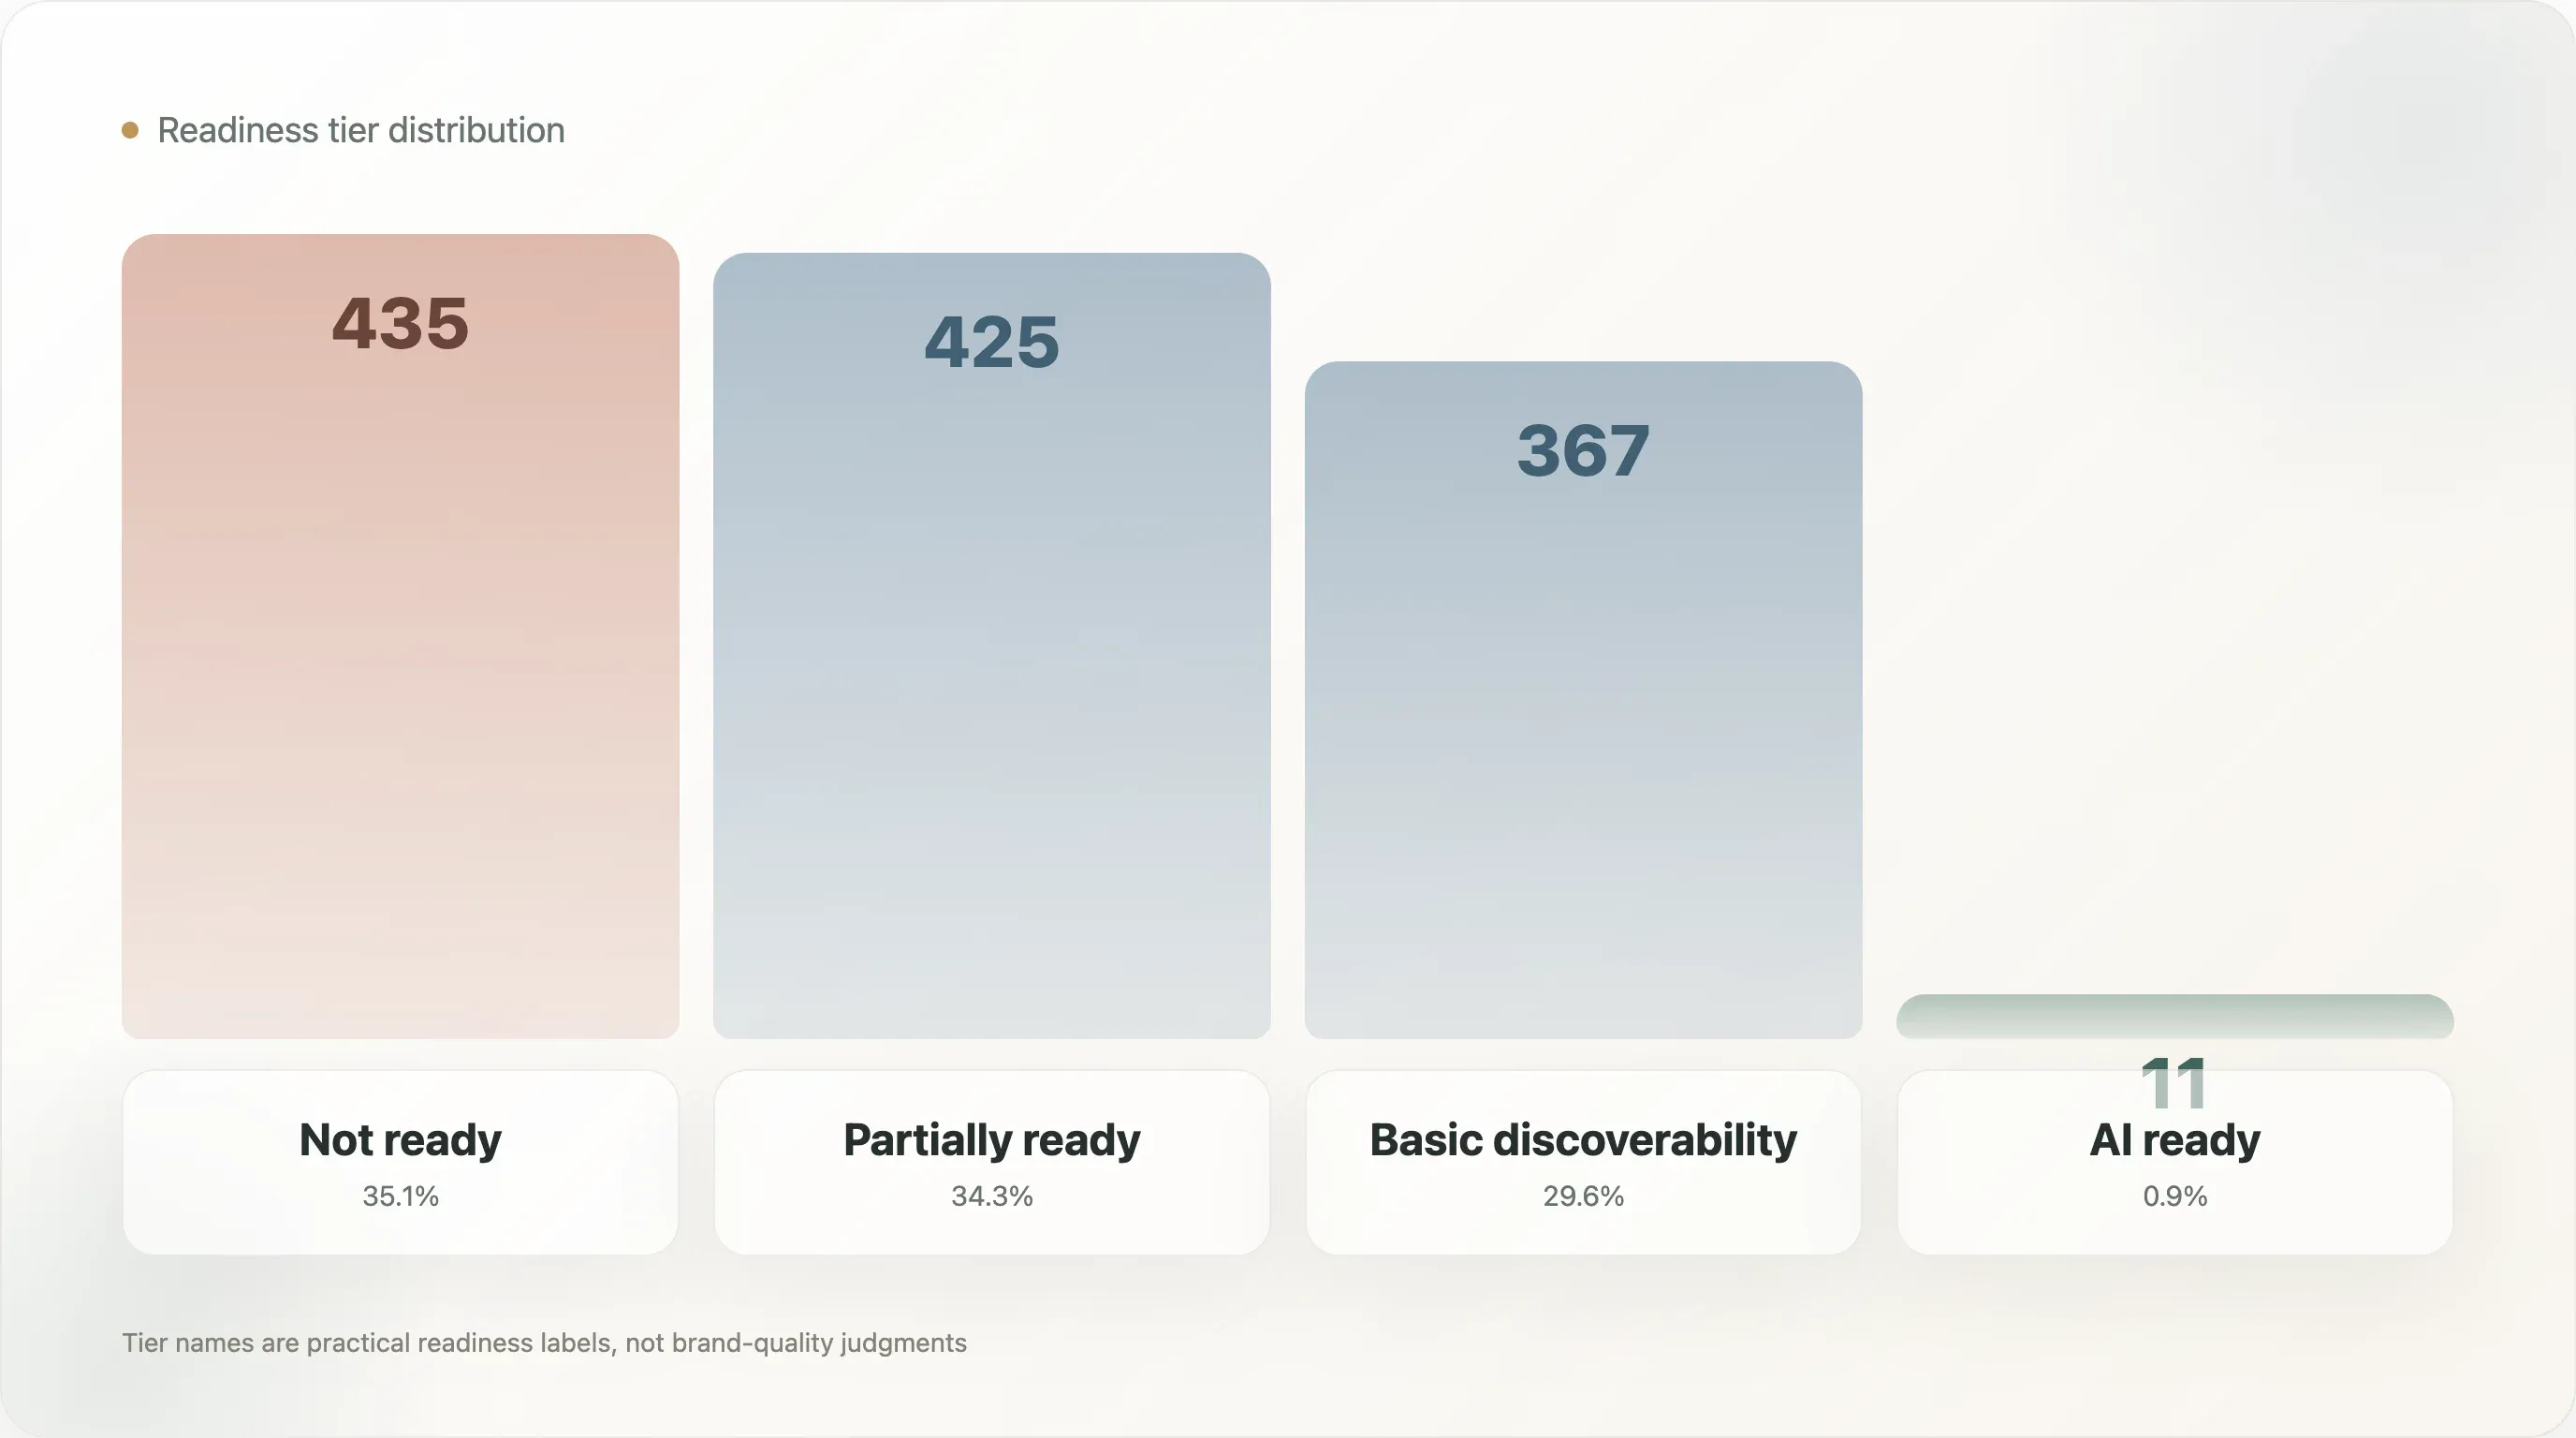
توزيع الشرائح هو:
| الشرائح | النطاقات | حصة العينة |
|---|---|---|
| غير جاهز | 435 | 35.1% |
| جاهز جزئيًا | 425 | 34.3% |
| قابل للاكتشاف بشكل أساسي | 367 | 29.6% |
| جاهز للذكاء الاصطناعي | 11 | 0.9% |
أسماء الشرائح مقصودة وعملية. فـ Not ready لا يعني أن العلامة سيئة. بل يعني أن الإشارات العامة المستخدمة في هذا النموذج لا تُظهر جاهزية كافية للبحث بالذكاء الاصطناعي. أما Partially ready فيعني أن بعض الأجزاء موجودة، لكن طبقات مهمة مفقودة. وBasic discoverability يعني أن العلامة أكثر ظهورًا للآلات، لكنها قد تفتقر مع ذلك إلى الاكتمال على مستوى المنتج. أما AI ready فيعني أن النطاق يُظهر مزيجًا أقوى من جودة الملف، والبيانات المنظمة، وحقائق المنتج، والبيانات الوصفية.
لم تصل إلى أعلى شريحة إلا 11 نطاقًا. وهذه هي العناوين الرئيسية، لكن الفائدة الحقيقية تكمن في شكل المنطقة الوسطى. فالعينة تنقسم تقريبًا بالتساوي بين غير جاهز، وجاهز جزئيًا، وقابل للاكتشاف بشكل أساسي. السوق ليس فارغًا. إنه في طور الانتقال. فالكثير من العلامات لديها بعض الإشارات، لكن القليل منها فقط يمتلك نظامًا كاملًا.
وهذا يخلق فرصة قريبة الأمد. فما تزال جاهزية البحث بالذكاء الاصطناعي مبكرة بما يكفي لتمكن العلامة من الانتقال من المتوسط إلى القوي عبر عمل عملي نسبيًا: تحسين llms.txt، والتحقق من صحة schema، وإظهار حقائق المنتج، وتنظيف البيانات الوصفية، وجعل صفحات المنتج أسهل على الآلات في التحليل.
5. أنماط الفئات: الجمال والملابس في المقدمة، لكن لا توجد فئة منتهية
تصنيف الفئات إرشادي لا دقيق تمامًا. ومع ذلك، يُظهر جدول الفئات أنماطًا مفيدة:
| الفئة | العينة | متوسط جاهزية الذكاء الاصطناعي | llms يدوي أو منظم | Product schema في صفحة المنتج | معدل Product schema في صفحة المنتج |
|---|---|---|---|---|---|
| الجمال والعناية بالبشرة | 98 | 46.2 | 3 | 56 | 57.1% |
| الملابس والأحذية | 149 | 45.7 | 6 | 79 | 53.0% |
| المجوهرات والإكسسوارات | 34 | 44.5 | 0 | 20 | 58.8% |
| الحيوانات الأليفة | 15 | 43.5 | 0 | 8 | 53.3% |
| الأطفال والرضّع | 27 | 42.6 | 1 | 15 | 55.6% |
| الطعام والمشروبات | 118 | 42.5 | 5 | 58 | 49.2% |
| المنزل والأثاث | 48 | 42.3 | 0 | 23 | 47.9% |
| الصحة والعافية | 58 | 40.7 | 6 | 27 | 46.6% |
| الهواء الطلق والرياضة | 49 | 39.8 | 1 | 23 | 46.9% |
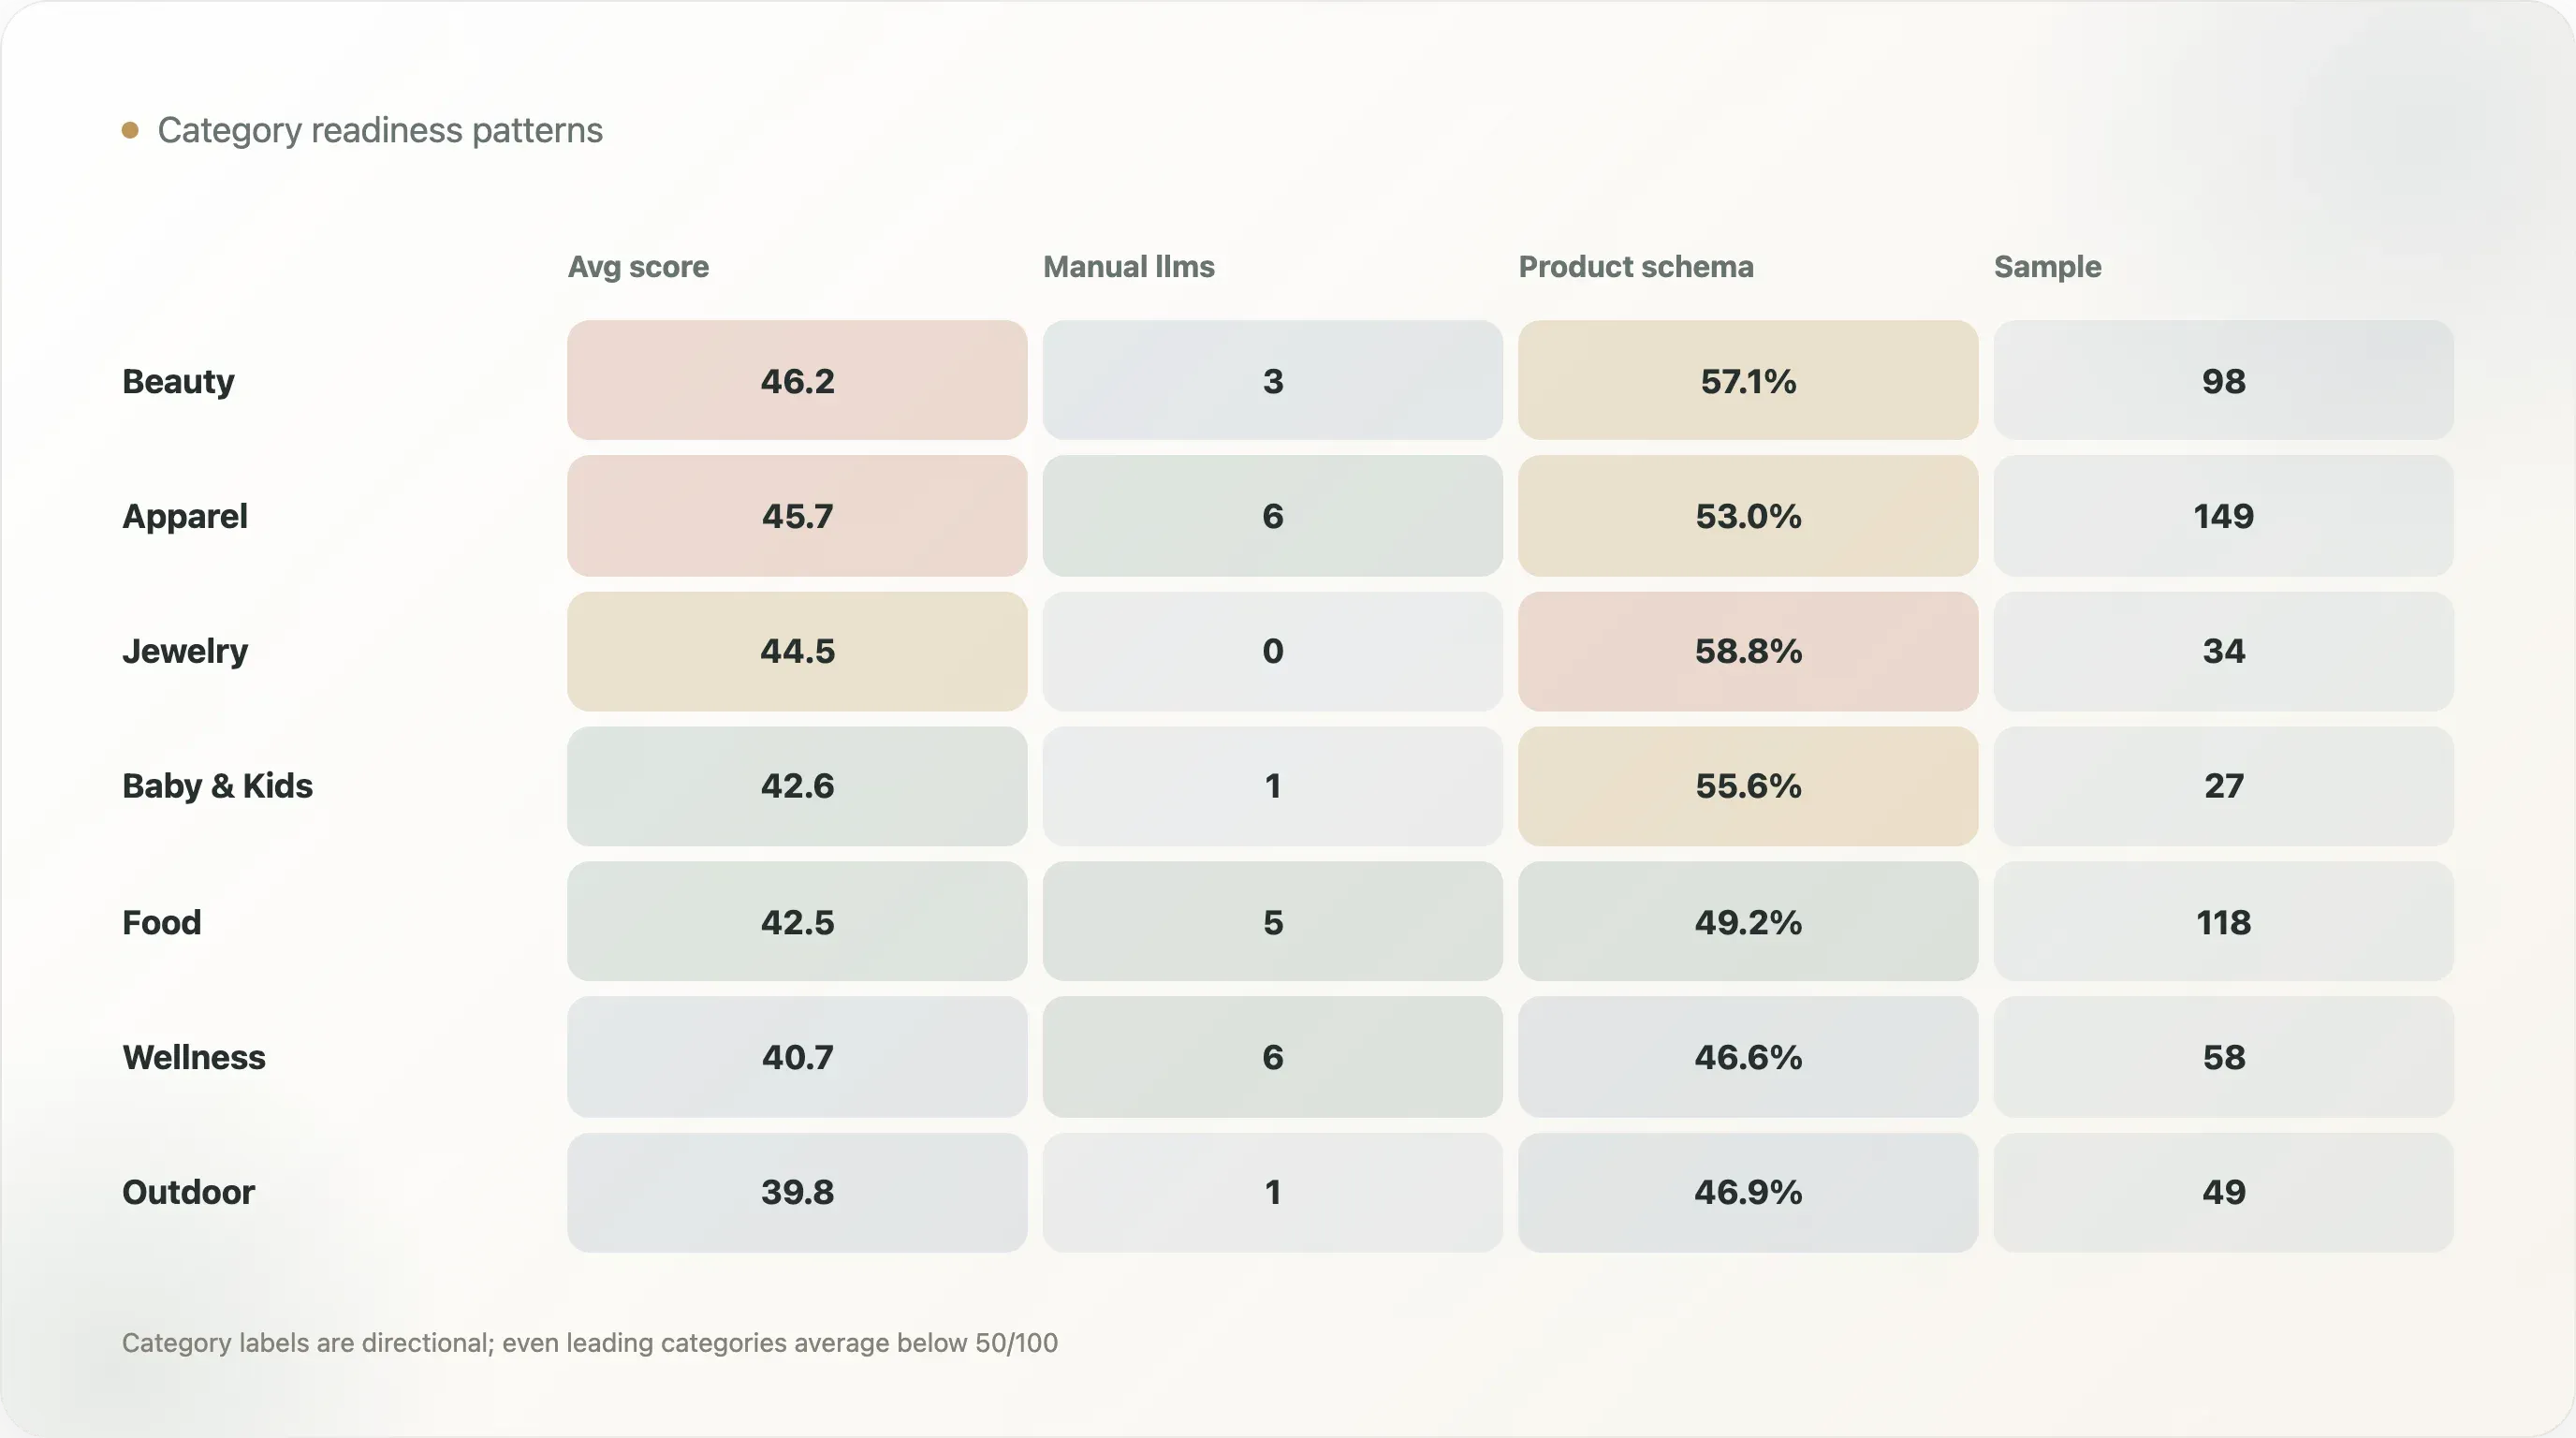
تملك فئة الجمال والعناية بالبشرة أعلى متوسط لدرجة الجاهزية للذكاء الاصطناعي عند 46.2. وتأتي الملابس والأحذية بعدها عند 45.7. وغالبًا ما تتمتع هذه الفئات بقوالب تجارة إلكترونية قوية، وكتالوجات منتجات غنية، ومراجعات، ومتغيرات، وأصول بصرية، واحتياجات محتوى كبيرة. لذا قد تستفيد أسرع من العمل المنظم على المنتج.
تتمتع فئة المجوهرات والإكسسوارات بمعدل مرتفع لمخطط Product في صفحة المنتج عند 58.8%، لكنها لا تُظهر أي اكتشافات لـ llms.txt اليدوي أو المنظم في جدول الفئات. وهذا يوضح لماذا يجب أن تكون الجاهزية طبقية. فقد تكون الفئة قوية في schema المنتج وضعيفة في جودة ملف الذكاء الاصطناعي.
تتضمن فئة الطعام والمشروبات عدة أمثلة إيجابية قوية، منها Maine Lobster Now وYo Mama's Foods وNuRange Coffee وManukora. وهذا مهم لأن منتجات الطعام والمشروبات غالبًا ما تحتاج إلى حقائق واضحة: المكونات، والقيم الغذائية، وحجم الحصة، والاشتراك، والمنشأ، والشحن، والتخزين، والمراجعات، والتوافر. ولا يمكن لأنظمة الذكاء الاصطناعي تمثيل هذه التفاصيل بدقة إلا إذا كشفها الموقع بوضوح.
أما فئة الصحة والعافية فلديها أعلى معدل لـ llms اليدوي أو المنظم عند 10.3% بين الفئات الرئيسية في الجدول، لكن متوسطها لا يتجاوز 40.7. وهذا يشير إلى أن بعض العلامات في هذه الفئة تختبر بنشاط ملفات قابلة للقراءة آليًا، بينما لا تزال بنية صفحات المنتجات قابلة للتحسين. وبالنظر إلى عبء الثقة والتثقيف في مجال العافية، ينبغي أن تكون هذه الفئة من أكثر الفئات جرأة في تبني الحقائق المنظمة.
لا توجد فئة منتهية. حتى الفئات الرائدة لا يتجاوز متوسطها 50/100. وهذا يجعل المحتوى الخاص بالجاهزية للذكاء الاصطناعي حسب الفئة فرصة قوية لكتّاب SEO والاستشاريين.
6. كيف يبدو الجيد: أنماط إيجابية من العلامات الجاهزة للذكاء الاصطناعي
مجموعة ai_ready صغيرة لكنها مفيدة لأنها تُظهر أنماطًا تستحق النسخ.
حققت Mokobara درجة 83، وهي الأعلى في النتائج. وتظهر مثالًا على جاهزية قوية مجتمعة، لا على نجاح بإشارة واحدة فقط.
حققت Magic Mind وLe Petit Ballon وMaine Lobster Now كل منها 81 وتقع ضمن شريحة llms.txt اليدوي المنظم. وهذا مهم لأنه يوضح عملًا مقصودًا على مستوى الملف، لا مجرد الاعتماد على الافتراضات الآلية للمنصة.
حققت Yo Mama's Foods درجة 80، أيضًا مع llms.txt يدوي منظم. ويمكن لعلامات الأغذية الاستفادة من البنية القابلة للقراءة آليًا لأن أنظمة الذكاء الاصطناعي قد تُسأل عن المكونات، والنكهة، وحالات الاستخدام، والوصفات، والملاءمة الغذائية، والمقارنات.
حققت Three Ships Beauty درجة 77 مع llms.txt يدوي منظم. وتُعد فئة الجمال مثالية للجاهزية المنظمة للذكاء الاصطناعي لأن المتسوقين يسألون عن نوع البشرة، والمكونات، والروتين، والملمس، والمراجعات، والبدائل.
حققت Manukora درجة 75. وغالبًا ما تحتاج منتجات العسل والأغذية المرتبطة بالعافية إلى تثقيف حول الأصل، والجودة، والفوائد، والشهادات، وطريقة الاستخدام، مما يجعل إشارات المنتج والسياسات المنظمة ذات قيمة كبيرة.
والدرس ليس أن كل علامة يجب أن تبدو متطابقة. الدرس هو أن الجاهزية للذكاء الاصطناعي نظام متكامل:
- ملف
llms.txtمفيد - بيانات وصفية نظيفة
- بيانات منظمة للمنظمة والموقع
- schema لصفحات المنتجات
- إشارات السعر والعرض
- إشارات المراجعة أو التقييم
- إشارات التوافر
- وضوح السياسات والدعم
كل طبقة تساعد. لكن التركيبة هي ما يصنع الجاهزية.
7. لماذا لا يكفي llms.txt وحده
أصبح llms.txt اختصارًا مريحًا للجاهزية للذكاء الاصطناعي. وهذا مفهوم لأنه مرئي، وسهل الفحص، وجديد بما يكفي ليبدو استراتيجيًا. لكن هذا البحث يوضح لماذا لا ينبغي اعتباره القصة كلها.
يمكن لملف llms.txt الافتراضي من المنصة أن يصنع بابًا أوليًا. فقد يوجّه الزواحف إلى الصفحات المهمة، وقد يخبر الآلات بأن الموقع لديه نقطة دخول قابلة للقراءة آليًا. لكن إذا لم تكشف صفحات المنتجات حقائق المنتج بوضوح، فإن الباب يقود إلى غرفة فوضوية.
ليست مشكلة البحث بالذكاء الاصطناعي: "هل يستطيع الزاحف العثور على الموقع؟" فقط. بل هي أيضًا:
- هل يستطيع الزاحف التعرف على المنتج؟
- هل يستطيع التعرف على العلامة؟
- هل يستطيع تحليل السعر؟
- هل يستطيع تحليل التوافر؟
- هل يستطيع التعرف على المراجعات أو التقييمات؟
- هل يستطيع التمييز بين محتوى المنتج والمحتوى التسويقي؟
- هل يستطيع فهم السياسات؟
- هل يستطيع مقارنة المتغيرات؟
- هل يستطيع الاستشهاد بالصفحة canonical الصحيحة؟
يساعد llms.txt في التنقل وتحديد الأولويات. وتساعد البيانات المنظمة للمنتج في الفهم. وتحتاج الجاهزية للذكاء الاصطناعي إلى الاثنين معًا.
8. دليل المشغّلين: كيف تحسّن جاهزية البحث بالذكاء الاصطناعي
بالنسبة لفرق DTC والتجارة الإلكترونية، فإن سير العمل العملي واضح.
الخطوة 1: افحص طبقة ملف الذكاء الاصطناعي. هل لدى النطاق llms.txt؟ وهل هو حقيقي أم 404 ناعم؟ هل هو افتراضي من المنصة، أم يدوي خفيف، أم منظم؟ وهل يشير إلى صفحات مفيدة؟
الخطوة 2: راجع البيانات الوصفية. تأكد من وسوم canonical، ووصف meta، وصور Open Graph، وبطاقات Twitter، وhreflang عند الحاجة، وmobile viewport. هذه العناصر ليست براقة، لكنها تساعد الآلات على بناء السياق.
الخطوة 3: تحقّق من JSON-LD. افحص Organization وWebSite وBreadcrumbList وProduct schema. ويُعد Product schema أهم فجوة في التجارة الإلكترونية.
الخطوة 4: راجع صفحات المنتجات، لا الصفحة الرئيسية فقط. لأن التسوق بالذكاء الاصطناعي سيهتم بصفحات المنتجات. تأكد من اسم المنتج، والوصف، والصورة، والسعر، والعرض، والتوافر، ورمز SKU، والمراجعات، والتقييمات، والمتغيرات، وسياسة الإرجاع.
الخطوة 5: اجعل حقائق المنتج مستقرة. تجنب إخفاء الحقائق المهمة للمنتج في الصور فقط، أو في التبويبات التي لا تُعرض بسلاسة، أو في عناصر JavaScript التي قد لا يحللها الزاحف.
الخطوة 6: حسّن وضوح السياسات. ينبغي أن تكون سياسات الشحن، والإرجاع، والاشتراكات، والضمانات، والشهادات، وادعاءات السلامة سهلة العثور وسهلة التحليل.
الخطوة 7: أعد الاختبار بعد تغييرات القوالب. فغالبًا ما ينكسر schema أثناء إعادة التصميم، أو تغيير القوالب، أو تحديث التطبيقات، أو الانتقال إلى headless. تعامل مع البيانات المنظمة كجزء من ضمان الجودة.
الخطوة 8: امتلك النظام. لا ينبغي أن تبقى جاهزية الذكاء الاصطناعي حكرًا على SEO. فهي تمس التجارة الإلكترونية، والمنتج، والمحتوى، والهندسة، والقانون، ودعم العملاء.
9. ما الذي يمكن لفرق SEO والمحتوى الاستشهاد به
يخلق هذا البحث عدة زوايا اقتباس قوية:
"11 نطاقًا فقط من أصل 1,238 نطاقًا خاضعًا للتقييم وصلت إلى فئة الجاهزية للذكاء الاصطناعي." وهذه أوسع نقطة جذب للجاهزية.
"llms.txt شائع، لكنه في الغالب مُنشأ من المنصة." تضم شريحة الافتراضي من المنصة 629 نطاقًا، بينما تظهر الملفات اليدوية المنظمة على 31 نطاقًا فقط.
"يظهر مخطط Product في الصفحة الرئيسية في 0.9% فقط من النطاقات الخاضعة للتقييم." وهذه هي فجوة البيانات المنظمة الأكثر حدة.
"يظهر مخطط Product في صفحات المنتجات في 39.2% من الحالات التي جرى فيها اختبار صفحات المنتجات." وهذا يضيف قدرًا من الدقة: صفحات المنتجات أفضل من الصفحات الرئيسية، لكنها ما تزال غير مكتملة.
"تتقدم فئتا الجمال والملابس في جدول الفئات، لكن متوسطهما ما يزال أقل من 50/100." وهذا يخلق زاوية خاصة بكل فئة.
"الجاهزية للذكاء الاصطناعي طبقية." وهذه أهم نقطة تعليمية للقراء الذين قد يساوون بين llms.txt والجاهزية.
والتحفّظ مهم: فالبيانات تعكس الإشارات العامة للموقع في هذه العينة، لا التبنّي الشامل في الصناعة، ولا أداء البحث الداخلي.
10. كيف يغيّر التسوق بالذكاء الاصطناعي عمل فرق DTC
بُني الاكتشاف التقليدي في التجارة الإلكترونية حول الصفحات، والترتيب، والإعلانات، والنقرات. كان المتسوق يبحث، ويقارن النتائج، ويفتح الصفحات، ويقرأ المراجعات، ثم يقرر. أما التسوق بالذكاء الاصطناعي ومحركات الإجابة فتضغط هذه الرحلة. فقد يسأل المتسوق: "ما أفضل صلصة منخفضة السكر لمعكرونة أيام الأسبوع؟" أو "حقيبة ظهر للسفر تحت 200 دولار مع مراجعات جيدة" أو "منظف لطيف للبشرة الحساسة بدون عطر". وقد يلخص نظام الذكاء الاصطناعي الخيارات قبل أن يرى المتسوق صفحة العلامة أصلًا.
وهذا يغيّر مهمة صفحة المنتج. فما زالت الصفحة تحتاج إلى إقناع البشر، لكنها تحتاج أيضًا إلى وصف المنتج بوضوح كافٍ للآلات كي تقارنه. فأسلوب العلامة وحده لا يكفي. والصور الجميلة وحدها لا تكفي. واسم المنتج الذكي وحده لا يكفي. فالآلة تحتاج إلى حقائق: ما هو المنتج، ولمن هو، وكم يكلف، وهل هو متاح، وما المتغيرات الموجودة، وماذا تقول المراجعات، وما الادعاءات المدعومة، وما المكونات أو المواد المهمة، وما السياسات المطبقة.
ولهذا السبب تكون البنية على مستوى المنتج أهم من ملف عام للذكاء الاصطناعي. يمكن لـ llms.txt أن يساعد الزاحف على معرفة أين ينظر. أما Product schema وحقائق صفحة المنتج النظيفة فتساعده على فهم ما وجده.
ولا يتمثل خطر العلامات التجارية DTC في الاستبعاد فقط، بل في سوء التمثيل أيضًا. فإذا كانت صفحة المنتج غير واضحة، فقد يلخص جواب الذكاء الاصطناعي ميزة خاطئة، أو يغفل فارقًا رئيسيًا، أو يحذف سياسة مهمة، أو يقارن المنتج مقارنة غير عادلة مع منافسين أفضل تنظيمًا. وبهذا المعنى، فإن الجاهزية للذكاء الاصطناعي هي أيضًا مسألة حماية للعلامة.
وفي الفئات ذات مسارات التقييم المعقدة، تكون المخاطر أعلى. فسُّؤال المتسوقين في الجمال يدور حول نوع البشرة، والمكونات، والروتين، والحساسية، والنتائج. وفي الطعام، يدور حول التغذية، والمواد المسببة للحساسية، والمنشأ، والنكهة، والوصفات، والملاءمة الغذائية. وفي الملابس، يدور حول المقاس، والحجم، والمواد، والإرجاع، والتنسيق. وفي العافية، يدور حول الأدلة، وطريقة الاستخدام، والسلامة، والثقة. وفي المنزل، يدور حول الأبعاد، والمواد، والتسليم، والتركيب، والمتانة. وهذه كلها مشكلات محتوى قابلة للقراءة آليًا بقدر ما هي مشكلات تسويق.
والفرصة أن معظم العلامات ما تزال في مرحلة مبكرة. فمتوسط درجة الجاهزية لا يتجاوز 36.4/100، ولم يصل إلى فئة ai_ready سوى 11 نطاقًا. ولا تحتاج العلامة إلى انتظار إعادة بناء كاملة للموقع. يمكنها أن تبدأ بالقوالب، وschema، ووضوح السياسات، وحقائق المنتج.
11. خطة جاهزية للذكاء الاصطناعي حسب القسم
لا ينبغي أن تكون جاهزية الذكاء الاصطناعي حكرًا على SEO. فهي تمس عدة فرق.
يتولى SEO قابلية الاكتشاف والتحقق من صحة schema. ينبغي لفرق SEO تدقيق وسوم canonical، والبيانات الوصفية، والبيانات المنظمة، وProduct schema، ومسارات التصفح، وhreflang، وقابلية الزحف. كما ينبغي لها مراقبة ما إذا كان Product schema يبقى سليمًا بعد تغييرات القوالب وتحديثات التطبيقات.
تتولى التجارة الإلكترونية حقائق صفحات المنتجات. يجب أن تكون أسماء المنتجات، والأسعار، والمتغيرات، والتوافر، والحزم، والاشتراكات، والمراجعات، وشروط الشحن، وتفاصيل الإرجاع واضحة ومتسقة. فإذا كانت هذه الحقائق موزعة بين عناصر واجهة، وتبويبات، وصور، وبرمجيات نصية، فقد تواجه الآلات صعوبة.
يتولى المحتوى العمق التفسيري. تكافئ أنظمة الذكاء الاصطناعي الصفحات التي تجيب بوضوح عن الأسئلة. يمكن لأدلة الشراء، وجداول المقارنة، وشرح المكونات، وصفحات حالات الاستخدام، وإرشادات المقاسات، وأقسام الأسئلة الشائعة أن تساعد البشر والآلات معًا.
تتولى الهندسة جودة التنفيذ. يجب أن يكون schema صالحًا ومستقرًا ومبنيًا على القوالب. ولا ينبغي أن تعتمد حقائق المنتج بالكامل على عرض عميل هش. كما يجب اختبار قوالب صفحات المنتج بعد الإصدارات.
يتولى القانون والامتثال الادعاءات. فإذا كان المنتج يقدم ادعاءات صحية، أو متعلقة بالاستدامة، أو بالسلامة، أو بالمكونات، أو بالأداء، فيجب أن تكون هذه الادعاءات دقيقة وقابلة للدعم وسهلة التفسير. وقد تضخم أنظمة الذكاء الاصطناعي الادعاءات غير الواضحة.
يتولى دعم العملاء الأسئلة المتكررة. تكشف تذاكر الدعم ما قد يسأله المتسوقون وأنظمة الذكاء الاصطناعي: وقت الشحن، والملاءمة، والمكونات، والتوافق، والإرجاع، وإلغاء الاشتراك، وتعليمات العناية، ومقارنات المنتجات. وينبغي أن تغذي هذه الأسئلة محتوى صفحة المنتج.
تتولى القيادة تحديد الأولويات. تتنافس جاهزية الذكاء الاصطناعي مع مشاريع كثيرة أخرى. والحجة القيادية بسيطة: فحقائق المنتج المنظمة تدعم SEO، والبحث بالذكاء الاصطناعي، وموجزات المنتجات، والتسوق المدفوع، والبحث داخل الموقع، والدعم، والتحويل. هذا ليس مشروعًا للذكاء الاصطناعي فقط.
12. الحد الأدنى من صفحة المنتج الجاهزة للذكاء الاصطناعي
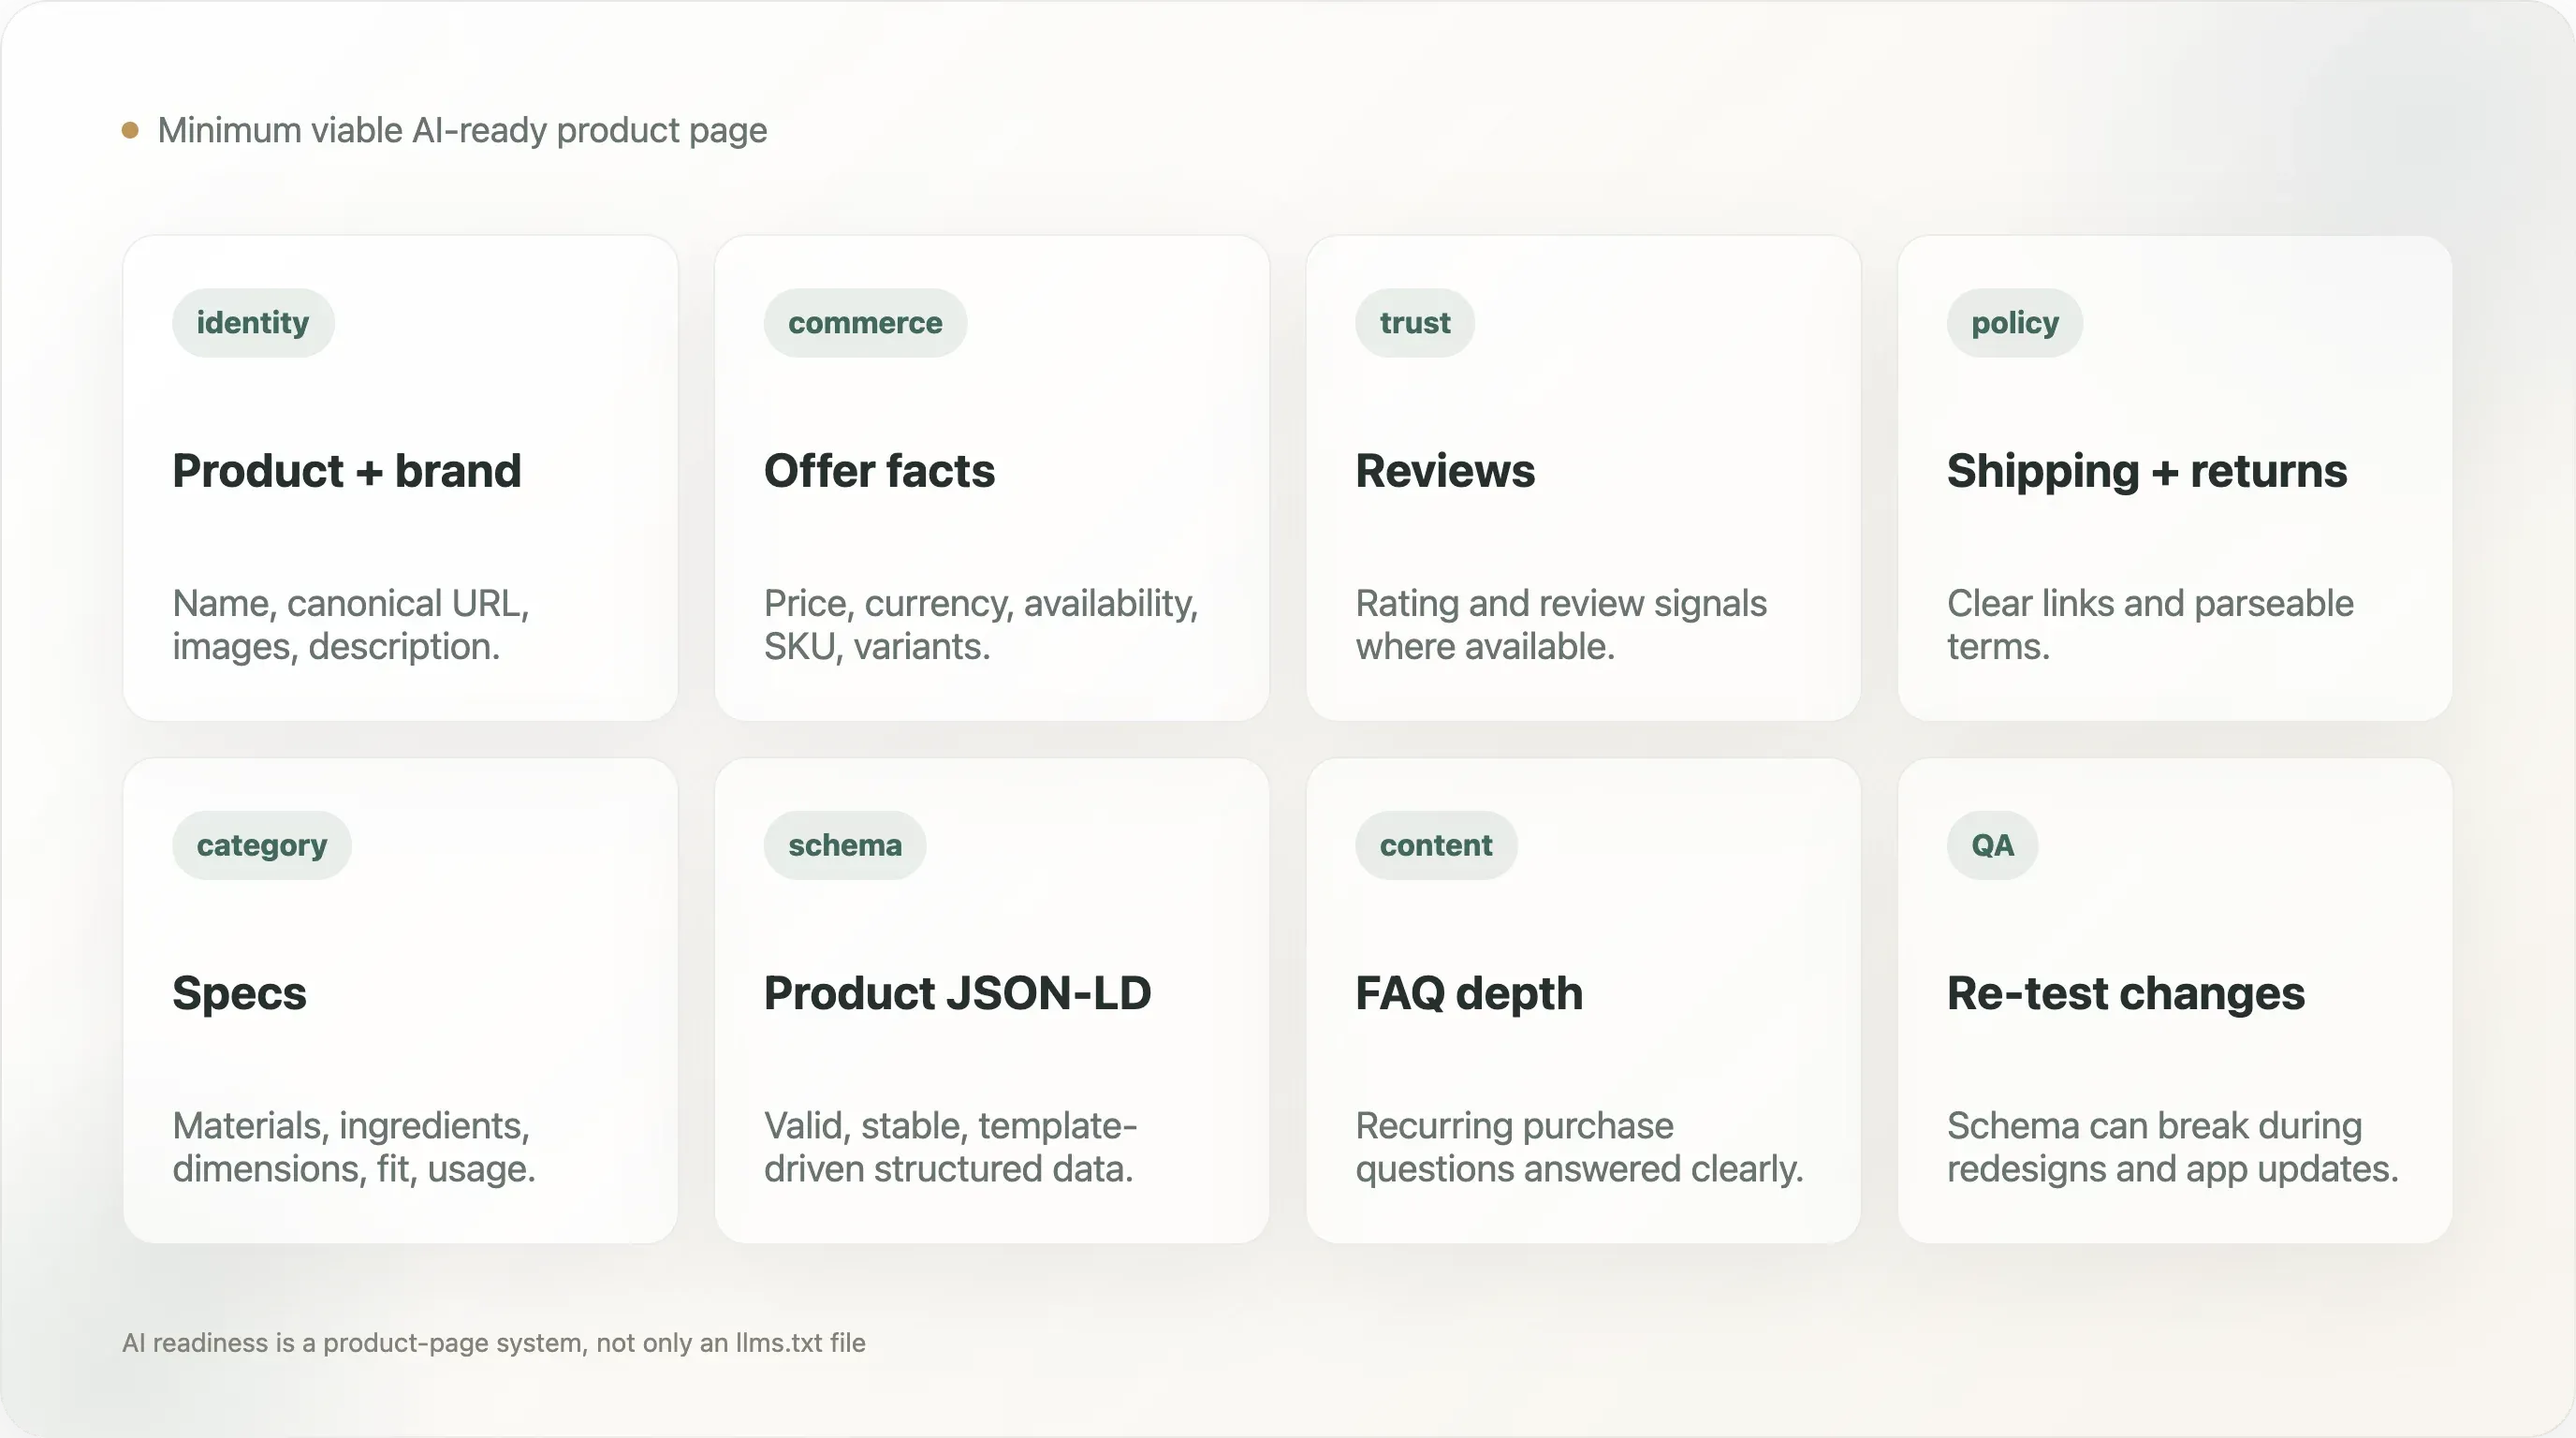
ينبغي لصفحة منتج عملية في DTC أن تكشف عن:
- اسم المنتج
- اسم العلامة التجارية
- الرابط canonical
- وصف المنتج
- صور المنتج
- السعر
- العملة
- التوافر
- معلومات المتغيرات
- رمز SKU أو معرف المنتج عند الحاجة
- إشارات المراجعة أو التقييم عند توفرها
- تفاصيل العرض
- روابط سياسة الشحن والإرجاع
- حقائق المواد أو المكونات أو المواصفات ذات الصلة بالفئة
- محتوى الأسئلة الشائعة أو الدعم للأسئلة المتكررة قبل الشراء
كما ينبغي أن تتضمن الصفحة Product schema صالحًا، وأن تتجنب إخفاء الحقائق المهمة داخل الصور أو البرمجيات النصية فقط، لأن الزواحف قد لا تحللها. ولا يتطلب هذا صفحات مملة. بل يتطلب فصلًا بين التصميم الإقناعي والحقائق المنظمة الموثوقة.
وبالنسبة إلى كثير من العلامات، فإن أسرع فوز ليس كتابة وثيقة استراتيجية طويلة عن الذكاء الاصطناعي. بل التحقق من عشر صفحات منتجات مهمة، وإصلاح schema، والتأكد من أن أهم حقائق المنتج مرئية في HTML وفي البيانات المنظمة.
المنهجية
يستخدم هذا البحث مجموعة بيانات تقرير DTC المزدوجة التي جُمعت في 11 مايو 2026. ويُقيّم 1,238 نطاقًا باستخدام master.csv وdetection.csv وseo_signals.csv، وملفات llms.txt الخام، وHTML الخام لصفحات المنتجات حيثما كان متاحًا.
يقسّم نموذج التقييم أربعة مستويات:
- طبقة ملف الذكاء الاصطناعي: وجود
llms.txtوجودته. - طبقة البيانات المنظمة العامة: JSON-LD، وOrganization، وWebSite، وBreadcrumbList، وProduct، والإشارات المنظمة ذات الصلة.
- طبقة صفحة المنتج: Product schema، وإشارات العرض أو السعر، وإشارات المراجعة أو التقييم، وإشارات التوافر.
- طبقة البيانات الوصفية: canonical، ووصف meta، وصورة Open Graph، وبطاقة Twitter، وhreflang، وسياق الصفحة ذي الصلة.
وينتج عن النموذج درجة جاهزية للذكاء الاصطناعي من 0 إلى 100، ويصنّف النطاقات إلى واحدة من أربع شرائح: غير جاهز، جاهز جزئيًا، قابل للاكتشاف بشكل أساسي، وai_ready.
التحفظات
-
الجاهزية للذكاء الاصطناعي ليست حركة مرور من الذكاء الاصطناعي. فالدرجة لا تقيس الإحالات الفعلية من أنظمة البحث أو وكلاء التسوق بالذكاء الاصطناعي.
-
الإشارات العامة تمثل حدًا أدنى. فقد تُحمَّل بعض البيانات المنظمة ديناميكيًا أو تظهر بطرق لم يلتقطها الزحف.
-
جودة
llms.txtتعتمد على الاستدلال. ويُحدَّد الملف اليدوي المنظم عبر خصائص ملف قابلة للرصد مثل العناوين، والروابط، ومصطلحات المنتج، ومصطلحات السياسة. -
يعتمد اكتشاف صفحة المنتج على محاولات جلب صفحات المنتج. لذا تنطبق نسب Product schema في صفحات المنتجات على الحالات التي جرى فيها اختبار صفحات المنتجات وكانت متاحة.
-
العينة ليست إحصاءً كاملًا لعالم DTC. فهي تميل إلى العلامات الظاهرة في منظومات أدوات التجارة الإلكترونية وقوائم DTC العامة.
-
ملصقات الفئات إرشادية. وهي مفيدة للمقارنة العامة لكنها ليست تصنيفًا دقيقًا.
-
معايير البحث بالذكاء الاصطناعي ما تزال تتطور. وقد صُمّم نموذج التقييم بوصفه معيارًا عمليًا لعام 2026، لا تعريفًا دائمًا.
ملاحظات لإعادة الإنتاج
يتضمن مجلد التسليم:
analyze_ai_search_readiness.py— نص التقييم المستخدم لقياس نطاقات DTC عبرllms.txt، والبيانات المنظمة، وإشارات صفحات المنتجات، وإشارات البيانات الوصفية.ai_search_readiness_scores.csv— درجات الجاهزية للذكاء الاصطناعي على مستوى النطاق، والشرائح، والإشارات المكوّنة.llms_quality_audit.csv— تدقيق جودةllms.txtعلى مستوى النطاق، بما في ذلك تصنيفات الافتراضي من المنصة، و404 الناعم، والمفقود، واليدوي الخفيف، واليدوي المنظم.category_ai_readiness.csv— مقارنة الجاهزية للذكاء الاصطناعي على مستوى الفئة.top_ai_ready_brands.csv— النطاقات الأعلى تقييمًا للمراجعة التحريرية واختيار الأمثلة.lowest_ai_ready_brands.csv— النطاقات الأقل تقييمًا لتحليل الفجوات والمراجعة التحريرية.summary.json— مقاييس التجميع الرئيسية المقتبسة في هذا التقرير، بما في ذلك حجم العينة، وعدد الشرائح، ومتوسط الدرجة، والوسيط، ومعدلات إشارات صفحات المنتجات.
تنزيل جميع النصوص البرمجية ومجموعات البيانات
نرحب بإرسال التصحيحات المنهجية، ومشكلات مجموعة البيانات، والتحليلات اللاحقة إلى support@thunderbit.com. يُنشر هذا التقرير مستقلًا عن أي موقف تجاري تمتلكه Thunderbit؛ فنحن نبني أداة استخراج ويب مدعومة بالذكاء الاصطناعي، ولدينا مصلحة بنيوية في أن تصبح مواقع التجارة الإلكترونية العامة أسهل على البشر ومحركات البحث ووكلاء الذكاء الاصطناعي في الفهم الدقيق. ويستند هذا المعيار إلى 1,238 نطاق DTC خاضعة للتقييم من إشارات مواقع عامة جُمعت في 11 مايو 2026. وتقف بيانات هذا التقرير على قدميها بذاتها. — فريق أبحاث Thunderbit، مايو 2026.
جرّب Thunderbit للجاهزية للبحث بالذكاء الاصطناعي Get Started Free



