
يُذكَر Docling كثيرًا جنبًا إلى جنب مع أدوات استخراج البيانات من الويب، لكنه في الحقيقة ليس واحدًا منها. هو حزمة لتحويل المستندات من IBM Research — وهي الآن مشروع تابع لـ LF AI & Data Foundation — تأخذ الملفات التي لديك أصلًا (PDF، وDOCX، وPPTX، وXLSX، وHTML، والصور) وتحولها إلى Markdown أو JSON. وحتى شعاره حرفيًا: "جهّز مستنداتك للذكاء الاصطناعي التوليدي".
إذًا هذه مراجعة عملية لمحوّل، لا لزاحف ويب. كل ما يلي تم قياسه على جهاز واحد يعمل بالمعالج فقط (macOS arm64، وPython 3.14.2، وDocling 2.111.0)، مع احتساب النتائج عبر سكربتات وتسجيل الإخفاقات على أنها إخفاقات فعلًا. والمستودع ضخم ويتغير يوميًا — 63,069 نجمة، و4,449 تفرّعًا، وتحديث في اليوم نفسه الذي سحبتُ فيه البيانات الوصفية — لذلك اعتبر أي رقم للإصدارات أو المشكلات هنا مجرد لقطة زمنية، لا قاعدة ثابتة.
ما هو Docling فعلًا وما الذي ليس عليه
الوحدة الأساسية في كل شيء داخل Docling هي DoclingDocument: تحلل الملف إلى هذه البنية، ثم تصدّر منها Markdown أو HTML أو DocTags أو JSON غير فاقد للمعلومات. الكود مرخّص بموجب MIT (مع اختلاف تراخيص النماذج الفردية)، وأصل المشروع من IBM Research Zurich، وحتى وقت كتابة هذا النص كان أحدث إصدار هو v2.112.0، وقد نُشر قبل يومين من تجربتي هذه.
أبرز ما يميّزه هو مسار PDF والصور. هذا المسار ليس مجرد تحليل نصي؛ بل يعتمد على طبقة من نماذج التعلم الآلي: نموذج تخطيط RT-DETR، ونموذج بنية الجداول TableFormer، ونموذج رؤية-لغة اختياري، وRapidOCR للنسخ الممسوحة ضوئيًا. هذه النماذج هي التي تعيد بناء تخطيط الصفحة، وترتيب القراءة، وبنية الجداول. وهذا بالتحديد هو الجزء الذي يستحق التقييم، وهو أيضًا الجزء الذي لن يظهر أبدًا في اختبار يكتفي بـ HTML.
وهنا فرق واحد يريحك من أسبوع كامل من اللخبطة: Docling لا يجلب أي شيء من الويب. لا يفسّر JavaScript، ولا يتخطى جدران الحماية ضد الروبوتات، ولا يزحف بين الصفحات. أنت تعطيه الملف، وهو يفهمه. أما الزحف فهو مهمة أداة أخرى، وهذه نقطة مهمة لاحقًا عندما يسأل الناس إن كان Docling بديلًا لـ Firecrawl (ليس كذلك — هما مكملان لبعضهما، وسأوضح السبب).
أول تشغيل لا يحذّرونك منه
pip install docling يمر بسلاسة على Python 3.14.2. ثم تنظر إلى البيئة الافتراضية فتجد أنها تستهلك 1.3 جيجابايت. Docling يسحب حزمة التعلم الآلي كاملة كاعتمادات أساسية حتى لو كنت ستحوّل ملف HTML فقط:
| الاعتمادية | الحجم على القرص (MiB، du) |
|---|---|
| torch (2.13.0) | 536 |
| opencv (cv2) | 119 |
| transformers (5.8.1) | 101 |
| scipy | 99 |
| sympy | 76 |
| pandas | 72 |
| rapidocr (+ النماذج المرفقة) | 72.1 |
| docling_parse | 30 |
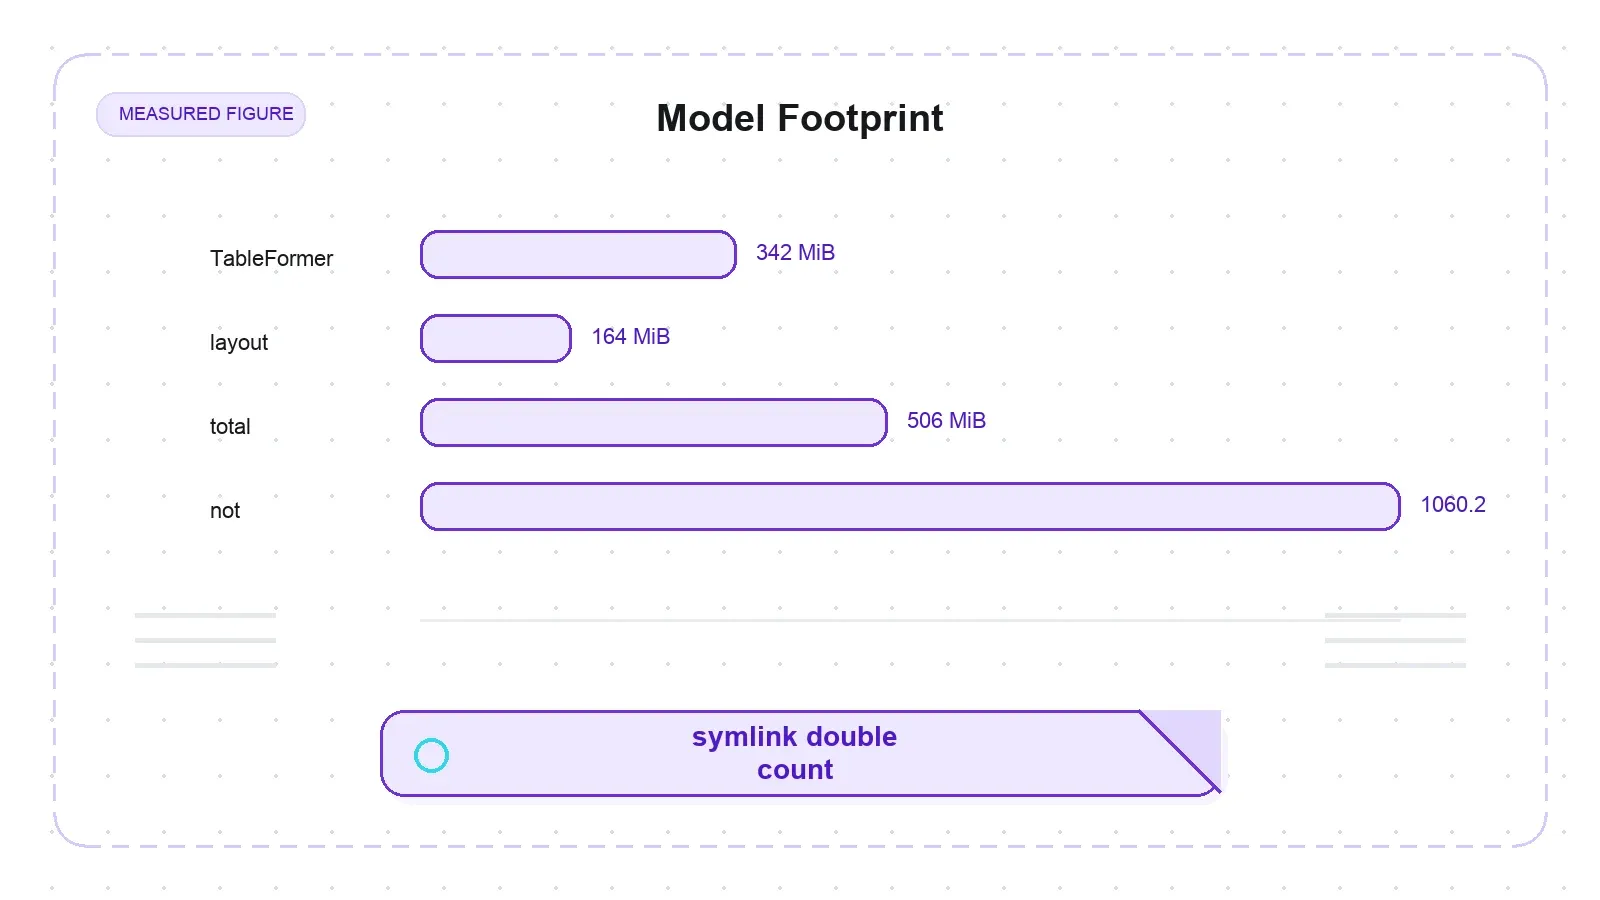
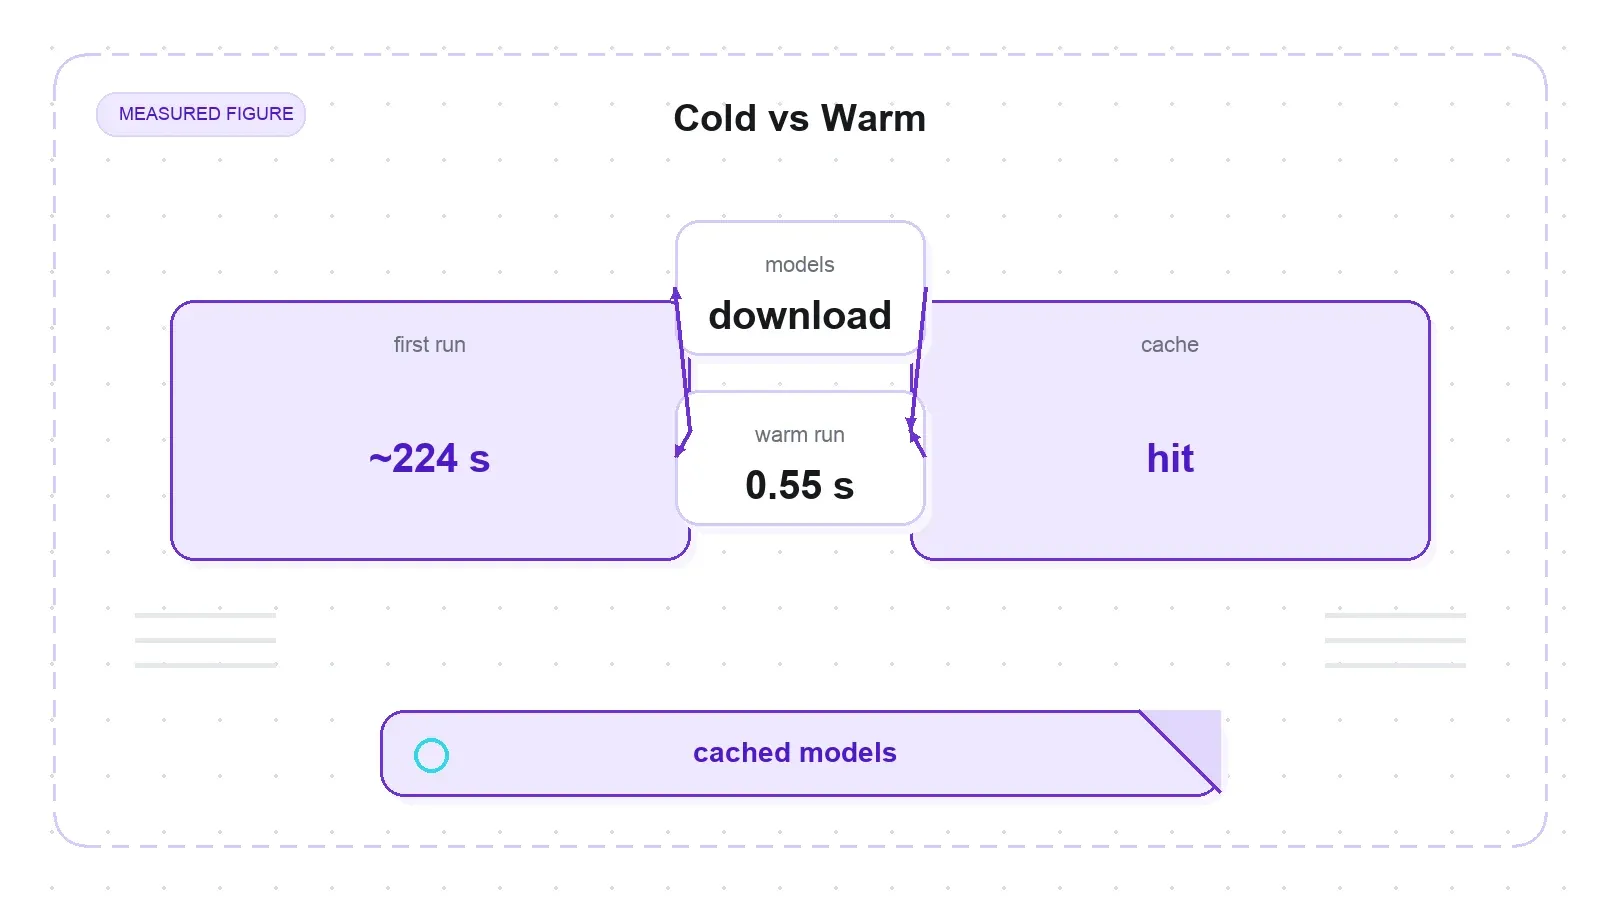
هذا كله قبل أن تحوّل ملف PDF واحدًا. أول تحويل لملف PDF هو حيث تظهر المعاناة الحقيقية، لأنه الوقت الذي تُنزَّل فيه النماذج. على ذاكرة HuggingFace نظيفة ومعزولة، استغرق أول تحويل لملف PDF نحو 224 ثانية — وكان معظم ذلك وقت تنزيل، لا وقت معالجة. نموذج التخطيط مع TableFormer يشغلان نحو 506 MiB على القرص (342 MiB لـ TableFormer + 164 MiB للتخطيط، وفق du)، كما يجلب RapidOCR نحو 40 MB من أوزان PP-OCRv4 إلى site-packages. أما التحويل الثاني لنفس الملف؟ 0.55 ثانية فقط. النماذج تُخزَّن في الكاش؛ تدفع الثمن مرة واحدة.
رقم واحد يجب ألا تنقلَه كما هو: سكربت البدء البارد يطبع model_download_mb بقيمة 1060.2. لا تعتبر هذا الرقم الحجم الفعلي. السبب أنه يعتمد على os.walk الذي يتبع الروابط الرمزية، بينما يخزّن HuggingFace كل ملف نموذج مرة واحدة تحت blobs/ ثم يعرضه من جديد كروابط رمزية داخل snapshots/ — لذلك يحسب المرور الملفات الـ14 مرتين. الرقم المطابق لـ du وبعد إزالة الازدواج الناتج عن symlink هو نحو 506 MiB (والـ blobs فقط 505.4 MiB). والخلاصة لأي شخص يقيس Docling: اذكر حجم التنزيل وحجم القرص كرقمين منفصلين، لأنهما مختلفان فعلًا.
وهناك تعقيد ثانٍ يربك أي شخص يبني حاوية Docling. الأوزان موزعة على موقعين وبجدولين مختلفين. نماذج التخطيط وTableFormer تلتزم بـ HF_HOME وتُحمَّل عند أول تحويل PDF. أما نماذج RapidOCR فلا — فهي تذهب إلى …/site-packages/rapidocr/models/ متجاوزة إعدادات الكاش تمامًا. إذا كنت تُجهّز صورة مسبقًا أو تعمل في بيئة معزولة عن الشبكة، فعليك التعامل مع الكاشين معًا، ولا يوجد أي ضبط لـ HF_HOME يلتقط الثاني.
والآن الجزء المنصف: منذ الإصدارات السابقة، أطلق المشروع docling-slim — نواة بحجم يقارب 50 MB تتيح لك pip install docling-slim[format-html] لملفات HTML من دون سحب torch. لذلك فإن وزن 1.3 جيجابايت حقيقي بالنسبة لحزمة docling الافتراضية، لكنه لم يعد أمرًا حتميًا. اختبرت الحزمة الافتراضية لأن هذا هو ما يقدمه pip install docling أصلًا، لكن الثقل هنا ليس عيبًا بلا حل — فالحل المعياري موجود، ومذكور في المشكلة #2393.
وأثناء الإعداد، ظهرت مشكلة صغيرة لكنها تستحق الذكر: import docling; docling.__version__ يرفع خطأ AttributeError: module 'docling' has no attribute '__version__'. ببساطة، الوحدة لا تعرض هذا الحقل. الاستعلام الذي يعمل هو importlib.metadata.version("docling")، ويُرجع '2.111.0'. هذا مزعج قليلًا لمطوّر التجربة، والمشكلة مفتوحة في المنبع منذ يوليو 2026 تحت #3733.
دقة الجداول: أين يثبت TableFormer قيمته
الجداول هي السبب الذي يجعل الناس يستخدمون Docling بدلًا من مجرد تفريغ نص PDF، لذلك أنشأت سبعة ملفات PDF تحتوي على جداول مع حقائق مرجعية قابلة للقراءة آليًا وقيّمت المخرجات خلية بخلية. هناك مقياسان مهمان، وهما ليسا الشيء نفسه: استرجاع الخلية هو نسبة القيم المرجعية الموجودة في أي مكان داخل الجدول المكتشف؛ أما معدل وجودها في الصف الصحيح فهو نسبة القيم التي انتهت في الصف المناسب. الخلط بينهما يجمّل أداء الأداة، لذا إليك الاثنين:
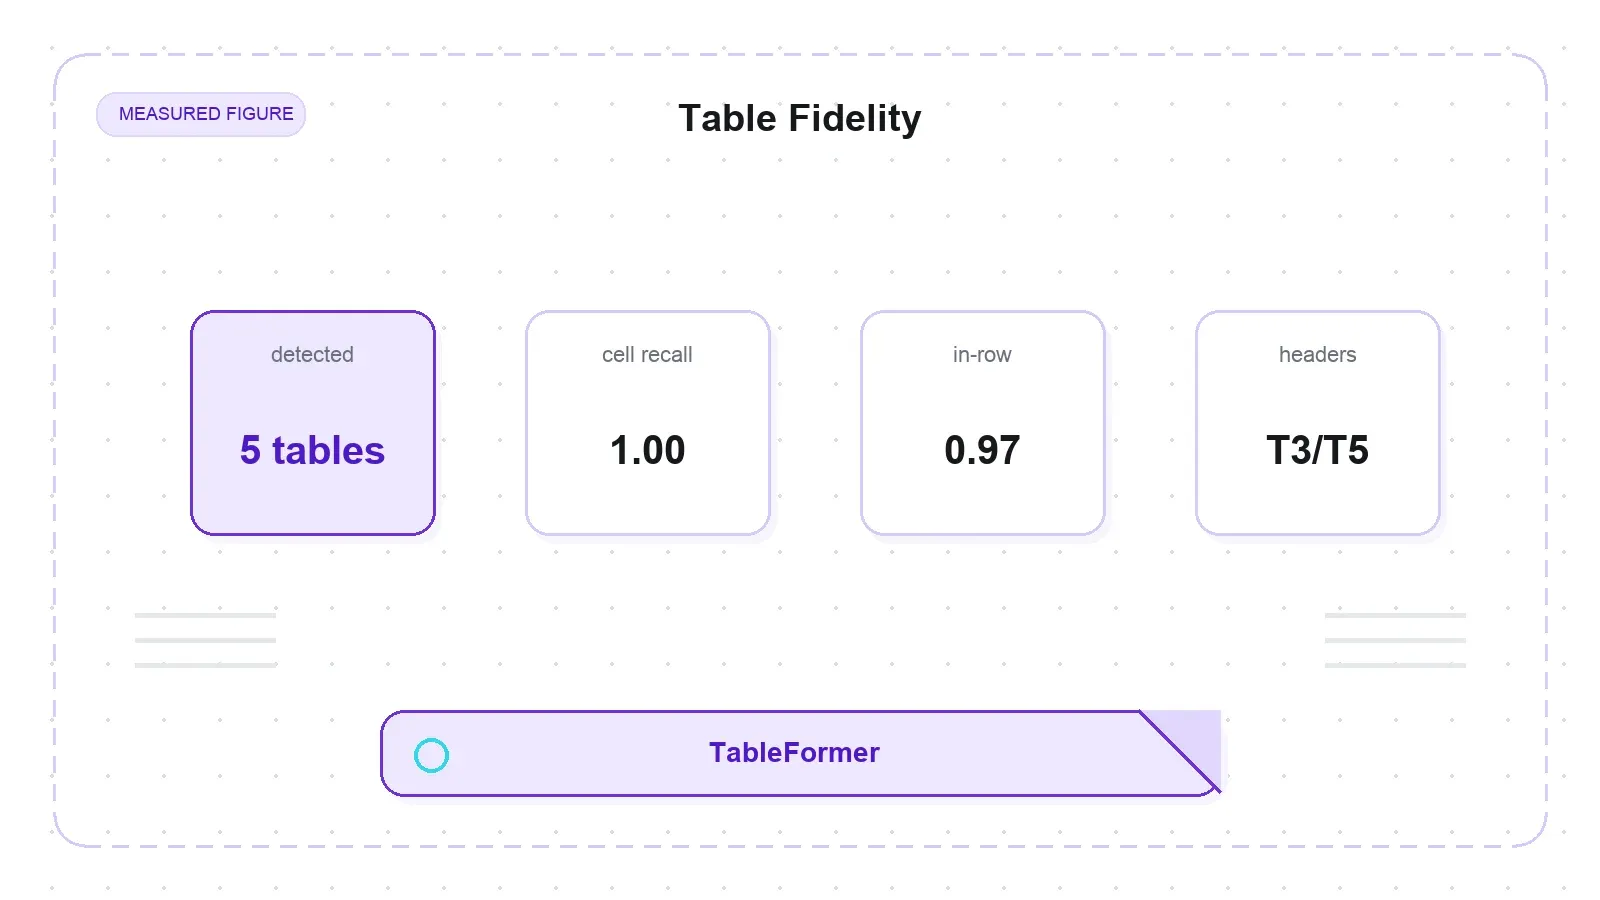
| الجدول (اختبار ضغط) | تم اكتشافه | استرجاع الخلايا | في الصف الصحيح | ملاحظة |
|---|---|---|---|---|
| T1 شبكة بسيطة بإطارات (8 صفوف × 5 أعمدة)، منفردة في الصفحة | لا | 0.0 | — | صُنّف كـ <!-- image -->، وسقطت كل الخلايا |
| T2 بلا حدود (فقط خط رأس) | نعم | 1.00 | 1.00 | مثالي، شبكة دقيقة |
| T3 رأس مدمج على مستويين colspan | نعم | 1.00 | 0.97 | كل القيم موجودة؛ قيمة واحدة في الرأس انزاحت إلى صف آخر |
| T4 صف تسمية مدمج rowspan، منفرد في الصفحة | لا | 0.0 | — | صُنّف كـ <!-- image --> |
| T5 رأس colspan + بلا حدود | نعم | 1.00 | 0.97 | كل القيم موجودة؛ الانزياح نفسه في صف الرأس كما في T3 |
| T6 بيانات مالية، عمود فارغ، ومحاذاة لليمين | نعم | 1.00 | 1.00 | حُفظ العمود الفارغ ولم يُحذف |
| T7 شبكة عريضة من 12 عمودًا | نعم | 1.00 | 1.00 | لا يوجد انزياح في الأعمدة رغم العرض |
في الجداول الخمسة التي اكتشفها Docling، وصلت كل قيمة مرجعية — استرجاع 1.00 في جميع الحالات. وفي ثلاثة من تلك الخمسة، استقرت كل قيمة أيضًا في الصف الصحيح. أما في حالتي الرأس متعدد المستويات (T3 وT5)، فانزلقت قيمة رأس واحدة من صفها الأصلي، فانخفض معدل الصف الصحيح إلى 0.97 — البيانات كلها موجودة، لكن توزيع الصفوف اهتز قليلًا عند الرأس المتراص.
أما الحالات البنيوية الأصعب فصمدت أفضل مما توقعت. رأس colspan بمستويين تحوّل بشكل صحيح إلى Markdown متوافق مع GitHub Flavored Markdown (وسم "Q1 2026" تكرر فوق العمودين اللذين يمتد عليهما، وهو الأسلوب الصحيح لطي colspan إلى GFM). الشبكة بلا حدود مع خط رأس فقط (T2) خرجت كما هي. والجدول العريض ذو 12 عمودًا (T7) لم ينزح. كما حُفظ عمود مالي فارغ بالكامل (T6) كخلايا فارغة بدلًا من حذفه أو دمجه. وهذا متسق مع درجات TableFormer الرسمية في TEDS — 95.4 للبسيط، و90.1 للمعقد، و93.6 لجميع الجداول — وهي درجات تتفوق جيدًا على Camelot (73.0) وEDD (88.3).
لكن انتبه عند الخلايا المدمجة، لأن هناك مشكلة مفتوحة تقول عكس ذلك. المشكلة #3698 تفيد بأن V1 وV2 يسيئان التعامل مع الصفوف والأعمدة المدمجة. في العينات التي اختبرتها، تم تسطيح قيم colspan البسيطة (T3/T5) وقيم rowspan بشكل صحيح، مع ملاحظة انزياح صف واحد فقط في رؤوس المستويات المتعددة كما ذُكر أعلاه. لكن الحالات الفاشلة في #3698 تشمل الدمج غير المنتظم متعدد الصفوف/الأعمدة والجداول متعددة الصفحات — أي الطرف المعقد من المشكلة. عيناتي تقع في الطرف البسيط. لذا فالتعبير الدقيق يكون ضيقًا: تم استرجاع colspan وrowspan البسيط هنا (مع احتمال انزياح صف واحد في الرؤوس متعددة المستويات)؛ أما الدمج المعقد وغير المنتظم فما يزال مشكلة مفتوحة موثقة. وليس "الخلايا المدمجة تعمل"، ولا "الخلايا المدمجة مكسورة".
الفخ: جدول منفرد في صفحة قد يختفي
ارجع إلى الجدول — T1 وT4 لم يُكتشفا أصلًا. أصدر Docling <!-- image --> وأسقط كل خلية من دون أي خطأ. T1 شبكة عادية تمامًا بإطارات، 8 صفوف و5 أعمدة. وهذا مقلق بما يكفي لأرفض اعتباره ضعفًا في تحليل الجداول قبل أن أحدد سببه فعلًا، لذلك بنيت اختبار A/B برمجيًا.
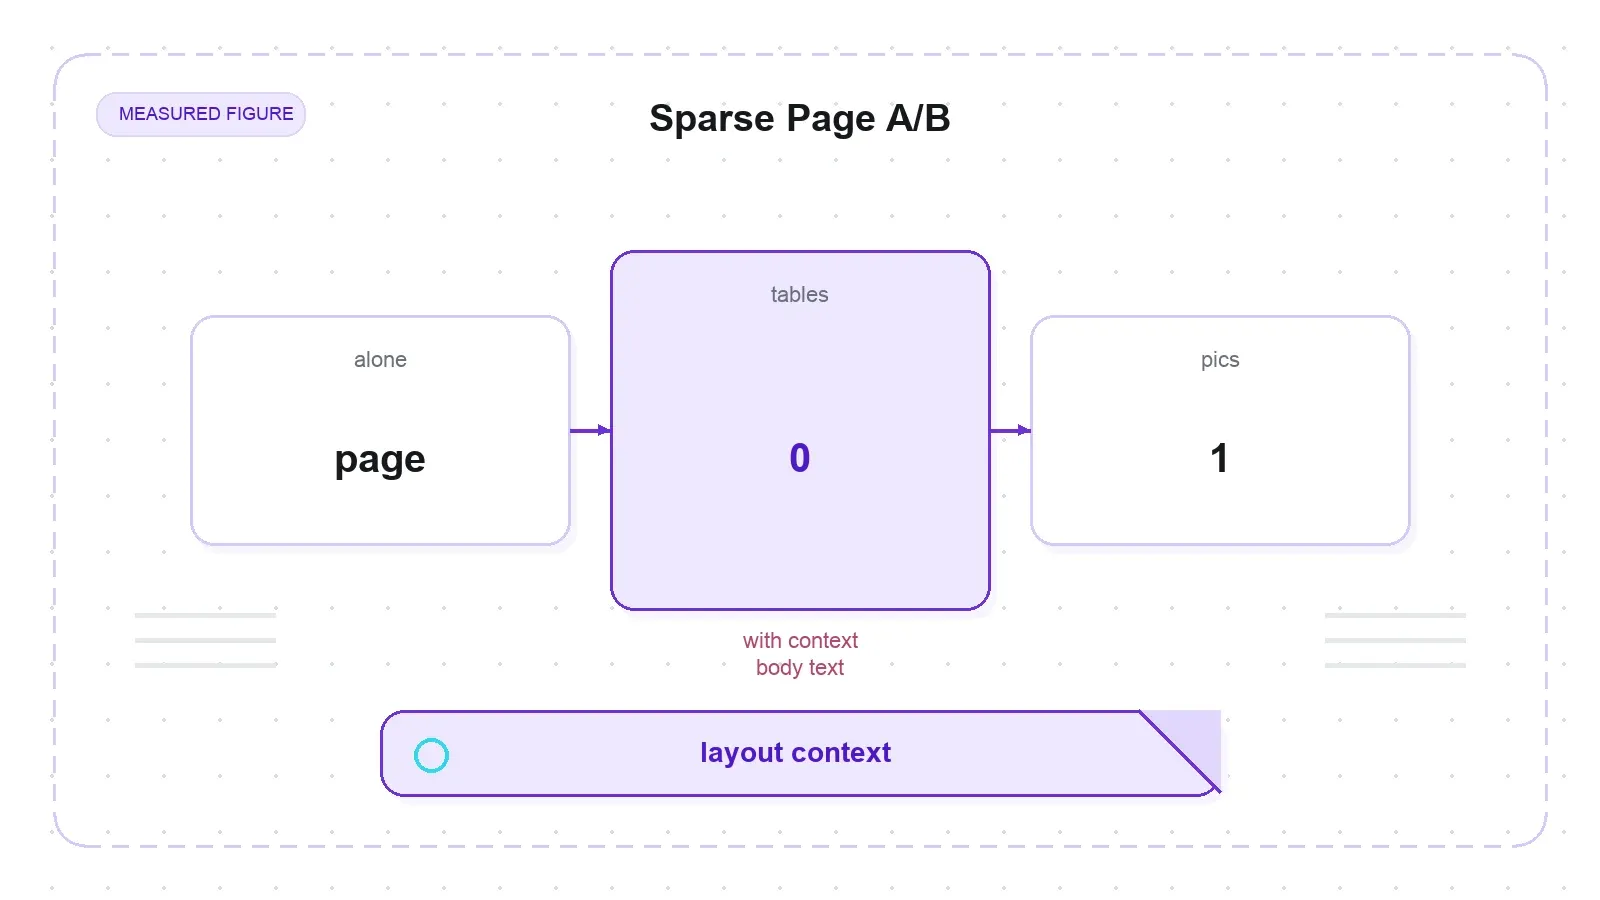
أولًا، استبعدت التفسيرات البديهية. طبقة النص سليمة — pypdfium2 يقرأ 327 حرفًا من T1 و221 من T4، لذا فهما ملفا PDF رقميان حقيقيان، لا صور ممسوحة ضوئيًا. إيقاف OCR (do_ocr=False) لا يساعد؛ فالجدولان يختفيان على أي حال. وعند فحص DoclingDocument مباشرة، كانت len(doc.tables) == 0 بينما len(doc.pictures) == 1 — أي أن نموذج التخطيط صنّف منطقة الجدول كلها على أنها صورة.
ثم جاء الاختبار الحاسم. أعدت عرض الجدولين T1 وT4 نفسيهما، لكن هذه المرة محاطين ببضع فقرات نصية عادية، ثم حوّلتهما من جديد. ظهر الاثنان بشكل مثالي: len(doc.tables) == 1، وجداول GFM صُدّرت بشكل صحيح، كما أن تسمية rowspan "North" في T4b تكررت على صفوفها الثلاثة كما ينبغي. نفس الجدول. المتغير الوحيد الذي تبدّل هو ما إذا كان وحيدًا في صفحة شبه فارغة أم مضمّنًا داخل نص.
إذًا التحذير الحقيقي ليس أن TableFormer هشّ، بل أن نموذج التخطيط RT-DETR في Docling يعتمد على سياق الصفحة، والجدول الصغير المنفرد في صفحة شبه خالية قد يُقرأ على أنه Picture ثم يُسقط بصمت. هذا يحدث بسهولة في الواقع، لأن هذا بالضبط شكل الفواتير، وأوراق المواصفات، وعمليات التصدير المقتطعة: جدول واحد في الصفحة، بلا نص محيط. الحل بسيط وفعّال — امنح نموذج التخطيط سياق صفحة، أو افحص doc.tables بعد التحويل وعلّم الصفحات التي يكون عددها فيها صفرًا. هذا قريب من المشكلة #3495 (جدول اكتُشف كـ Table وPicture معًا)، لكن محفز ضآلة الصفحة تحديدًا — نفس الجدول يختفي عند عزله ويعمل عند تضمينه — لم أجد له توثيقًا منشورًا. تم قياسه، ولم يكن موثقًا من قبل؛ لكنه ليس خطأ لا يعرفه أحد.
OCR على المسوح الحقيقية: RapidOCR وليس EasyOCR
ملفات PDF الممسوحة ضوئيًا هي المكان الذي تتعثر فيه كثير من أدوات التحويل بصمت، لذا قدّمت لـ Docling ملفي scan حقيقيين مع طبقة نصية مقاسة تساوي 0 حرف — وpypdfium2 أبلغ عن صفر حرف قابل للاسترجاع، ما يؤكد أن أي مخرجات هنا هي OCR، لا طبقة نص مخفية مرافقة.
ملف الصفحة الواحدة ocr_test.pdf عاد نظيفًا خلال 14.3 ثانية على المعالج: "Docling bundles PDF document conversion to JSON and Markdown in an easy self contained package," واستُعيد النص حرفيًا. أما ملف الصفحات الأربع nemotron_multipage.pdf فأطلق OCR على الصفحات الأربع جميعًا في 70.1 ثانية إجمالًا (17.5 ثانية/صفحة)، وأنتج الجملة التجريبية المتكررة في كل صفحة. OCR الافتراضي انطلق تلقائيًا — من دون أي راية أو إعداد.
وهنا التفصيل الذي تخطئ فيه كثير من المقالات: محرك OCR الافتراضي هو RapidOCR، وليس EasyOCR. تأكدت من ذلك عبر مراقبة تنزيل أوزان PP-OCRv4 بصيغة .pth في أول تشغيل. كثير من المقالات والمدونات القديمة، وكذلك نص FAQ القديم لـ Docling، ما زالت تقول إن EasyOCR هو الافتراضي؛ وهذا لم يعد دقيقًا. EasyOCR أصبح الآن إضافة اختيارية. والملاحظة التي تبقى صحيحة: OCR هو المسار البطيء عند التوسع، وكل ما هنا سقف مبني على CPU فقط — GPU كان سيخفض هذه الأوقات بشكل ملحوظ.
ملفات PDF الحقيقية، ترتيب القراءة، ووقت الصفحة الواحدة
الملفات الاصطناعية تثبت سلوكيات محددة؛ أما ملفات PDF الحقيقية فتثبت أن الأداة تعمل فعلًا. شغلت بحثين أكاديميين مولودين رقميًا — التقرير التقني لـ Docling المؤلف من 9 صفحات، ومقال "Attention Is All You Need" المؤلف من 15 صفحة، وكلاهما بتخطيط عمودين مع جداول وصيغ.
في ورقة Attention ذات الـ15 صفحة، ظهرت كل العلامات الخمس للفصول — Abstract، وIntroduction، وBackground، وConclusion، وReferences — بترتيبها داخل المستند في Markdown الخطي، رغم تخطيط العمودين. كل مؤشرات المحتوى (Transformer، وencoder، وBLEU، وmulti-head) موجودة، وجداول النتائج متعددة الأعمدة ظهرت كأربعة جداول مكتشفة. هذا استرجاع حقيقي لترتيب القراءة ودمج الأعمدة، وهو القيمة الأساسية لتقطيع المستندات في RAG — لا يمكنك تقسيم مستند بشكل سليم إذا كان المحول الخطي يخلط صفحة عمودين إلى فوضى متداخلة.
أما التوقيت فيحمل درسًا غير بديهي. وقت الصفحة الواحدة لا تحدده الصفحات فقط، بل كمية البنية داخل كل صفحة. التقرير الأكثر كثافة ذو 9 صفحات عمل بمعدل 14.95 ثانية لكل صفحة — أبطأ لكل صفحة من الورقة ذات 15 صفحة التي سجلت 5.99 ثانية لكل صفحة — لأنه يحتوي على جداول ورسوم أكثر في كل صفحة — 3 جداول عبر 9 صفحات مقابل 4 عبر 15 صفحة — وكل عنصر منها يطلق مزيدًا من استدلالات التخطيط وTableFormer. وهذه فجوة دقيقة، وبالمطلق فالمستند الأكثر كثافة يحتوي جداول أقل، لا أكثر. إذًا "ثوانٍ لكل صفحة" على CPU هي دالة في كثافة البنية، لا في الطول. هذا تشغيل واحد فقط على CPU؛ إنه سقف، لا رقم إنتاجي.
تعدد الصيغ وادعاء JSON غير الفاقد
Docling يعلن عن تحليل موحد متعدد الصيغ، لذا أنشأت ملف DOCX وXLSX وPPTX بمحتوى معروف ونقاط تحقق معروفة، ثم فحصت أمرين: هل تظهر هذه النقاط في Markdown؟ وهل تنجو من جولة JSON عبر export_to_dict()؟
| الملف | زمن التحويل بالثواني | تم العثور على مؤشرات MD | الجداول في MD | المؤشرات تنجو في JSON |
|---|---|---|---|---|
report.docx (عناوين + جدول "Total" مدمج + نقاط تعداد) | 0.137 | 7/7 | 1 | نعم |
workbook.xlsx (ورقتان، عمود فارغ) | 0.016 | 6/6 | 2 | نعم |
deck.pptx (3 شرائح، تعداد + جدول) | 0.038 | 6/6 | 1 | نعم |
كل مؤشرات المحتوى ظهرت في Markdown، واستُعيدت الجداول (بما في ذلك صف "Total" المدمج في DOCX وكلتا ورقتي XLSX)، كما نجا كل مؤشر أيضًا عبر JSON الخاص بـ export_to_dict() — وهذا هو الدليل المهم على ادعاء DoclingDocument غير الفاقد للمعلومات، على الأقل مع الملفات النظيفة. هذه الصيغ تمر عبر محركات أصلية للصيغة بدلًا من نماذج ML، ولهذا تعمل في عشرات الملي ثانية وتعمل بالكامل دون اتصال. والنطاق هنا صادق: ملف نظيف واحد من كل صيغة يثبت الاتساع، لا اختبار ضغط لملفات Office المشوشة.
HTML: وفيّ، لكنه ليس نظيفًا
هذا هو التحذير الذي يحدد ما إذا كان Docling مناسبًا في خط أنابيب RAG الخاص بك، لذا اقرأه بعناية. Docling يحوّل المستند HTML كاملًا. لا يقوم باستخراج المحتوى الرئيسي على طريقة readability. وقد قستُ مقدار واجهات الموقع التي تبقى عبر عدّ أسطر التنقل، وفهرس المحتوى، وملفات الكوكيز، والتذييل في مخرجات Docling نفسها.
| الصفحة | أسطر MD غير الفارغة | أسطر النص الجانبي/القوالب | % القوالب | يبدأ المقال في السطر |
|---|---|---|---|---|
| ويكيبيديا "Web scraping" | 255 | 34 | 13.3% | 28 |
| scrapethissite/forms | 63 | 1 | 1.6% | — |
| books.toscrape | 65 | 0 | 0.0% | — |
| quotes.toscrape | 35 | 0 | 0.0% | — |
في صفحة غنية بالواجهات مثل ويكيبيديا، نحو 13% من أسطر Markdown هي تنقل/فهرس/تذييل، ولا يبدأ المقال الحقيقي حتى السطر 28 — يفتتح الناتج بـ "move to sidebar / Contents / Toggle the table of contents" ويختتم بـ "CS1 maint… / Search Wikipedia." أما في صفحات المحتوى النظيفة (books, quotes) فالنسبة تقارب 0%، لذا فهذه مشكلة قوالب وواجهات، لا ضريبة عامة على كل صفحة. Docling يعطيك Markdown وفيًّا للمستند كاملًا، لا استخراجًا نظيفًا للمقال الرئيسي. وتتبع المنبع مشكلة الواجهات في HTML ضمن المشكلة #1865 (مغلقة) و#1930 (مفتوحة).
وهناك شيئان يحافظان على الإنصاف هنا. أولًا، في HTML تحديدًا لا يشغّل Docling أي نماذج ML إطلاقًا — بل يعتمد على BeautifulSoup ضمن مسار بسيط. حكاية "نماذج رؤية تقرأ صفحتك" تنطبق على PDF والصور فقط؛ إذا أعطيت Docling HTML فلن يعمل تخطيط ولا TableFormer. ثانيًا، مسار PDF يحاول فعلًا تصنيف رؤوس الصفحات وتذييلاتها، لذلك القول بأنه "لا يوجد أي إزالة للقوالب" سيكون مبالغة؛ المشكلة تخص HTML backend تحديدًا، فهو الذي يعيد تلك الواجهات.
كيف يقارن، وأين يأتي Thunderbit
جرّب Thunderbit لاستخراج بيانات الويب
الأداة المرجعية التي يقارن الناس Docling بها هي Firecrawl، لذا إليك جدول تموضع. وهناك ملاحظة مهمة من البداية: هذه مقارنة على مستوى التوثيق، وليست معيار أداء على الجهاز نفسه. لم أشغّل Firecrawl على هذه العينات. عمود Docling فقط مقاس هنا؛ أما عمود Firecrawl فمأخوذ من وثائقها العامة.
| المحور | Firecrawl (بحسب وثائقها) | Docling (مقاس هنا) |
|---|---|---|
| المهمة الأساسية | الزحف إلى الويب الحي واستخراج محتواه → Markdown | تحويل مستند تملكه مسبقًا → Markdown/JSON |
| الجلب / عرض JS / تجاوز الحماية | نعم (متصفح مستضاف) | لا — أنت توفّر الملف |
| استخراج المحتوى الرئيسي | نعم | لا — مستند كامل بأمانة (~13% قوالب في ويكيبيديا) |
| بنية جداول PDF (ML) | محدود | نعم — TableFormer (TEDS الرسمية 93.6؛ استرجاع خلايا 1.00، وفي الصف 0.97–1.00 على العينات المكتشفة) |
| PDF ممسوح ضوئيًا / OCR | محدود | نعم — RapidOCR افتراضيًا (استعاد مسحًا بلا طبقة نص) |
| اتساع الصيغ | صفحات ويب | PDF/DOCX/PPTX/XLSX/HTML/EPUB/صور |
| النشر | API مستضاف (+ استضافة ذاتية) | مكتبة pip محلية، تعمل دون اتصال، بلا مفتاح API |
| عبء الإعداد | مفتاح API / عميل خفيف | تثبيت افتراضي 1.3 GB + نحو 506 MiB من النماذج (أو docling-slim) |
| الترخيص | تجاري / المصدر متاح | MIT |
الخلاصة في سطر واحد: Firecrawl هي الأداة عندما تكون بياناتك على الويب الحي وتحتاج إلى الزحف، وعرض JavaScript، وتنظيف المحتوى الرئيسي. أما Docling فهو الأداة عندما تكون المستندات لديك أصلًا — خصوصًا PDF، والمسوح الضوئية، وملفات Office الثقيلة بالجداول — وتريد تحويلًا دقيقًا يعمل دون اتصال ويحافظ على البنية مع فهم حقيقي للجداول وOCR. هما مكملان لبعضهما. الخط الأنسب في الواقع هو أن تزحف بأداة، وتحول المستندات بأخرى.
وهنا سأكون صريحًا أيضًا بشأن Thunderbit لأنني أعمل هنا، ومن حقك أن تشك لو حاولت التظاهر بعكس ذلك. Thunderbit وDocling لا يقومان بالمهمة نفسها، ولن أفرض بينهما مساواة مصطنعة. بالنسبة للمطورين، Thunderbit هو API لاستخراج البيانات بالذكاء الاصطناعي + خادم MCP + CLI، ووحدة عمله هي صفحة الويب الحية: POST /distill يحول عنوان URL إلى Markdown نظيف جاهز للنماذج اللغوية الكبيرة (مع التعامل مع عرض JS، وتجاوز الحماية، وCAPTCHA التي لا يقترب منها Docling أصلًا)، وPOST /extract يعيد JSON منظمًا مطابقًا للمخطط عبر JSON Schema الذي تحدده. هذا هو طرف الجلب والتنظيف في خط RAG. أما Docling فهو طرف المستند المحلي — PDF، أو المسح الضوئي، أو جدول البيانات الموجود بالفعل على قرصك. إذا كانت مجموعتك صفحات ويب، فاستعمل Thunderbit API أو أدوات MCP (thunderbit_suggest_fields، وthunderbit_distill، وthunderbit_extract) أو CLI (npx @thunderbit/thunderbit-cli). وإذا كانت PDF ومسوحًا ضوئية، فاستعمل Docling. وإذا كان الاثنان معًا — وهو الأكثر شيوعًا في خطوط الإنتاج الحقيقية — فادمجهما، ولن يحاول أي منهما أن يكون الآخر.
الحكم: مؤقت، ومعه واجبات لم تُنجز بعد
لن أعطيك درجة واحدة من 0 إلى 100، لأن أي مجموع مرجّح هنا سيخلط عقوبات على أشياء لم يدّعها Docling أصلًا (مثل الزحف) ثم يتظاهر بأنها قابلة للمقارنة. على كل بُعد، وفي العينات التي اختبرتها:
- الإعداد / أول تشغيل: ثقيل — بيئة 1.3 GB، ونماذج بحجم ~506 MiB، وأول PDF يستغرق ~224 ثانية، والتشغيل الدافئ ~0.55 ثانية — لكن
docling-slimيتيح لك تخفيف العبء. - دقة الجداول: قوية عندما يُكتشف الجدول (استرجاع 1.00 في 5/5، وفي الصف 0.97–1.00)، بما ينسجم مع قصة TEDS الرسمية على هذه العينات.
- متانة اكتشاف الجداول: فخ الصفحة شبه الفارغة — قد يختفي جدول منفرد على أنه Picture. افحص
doc.tablesبعد التحويل. - المسوح الضوئية / OCR: تعمل، وRapidOCR افتراضيًا؛ لكنها بطيئة عند التوسع.
- تعدد الصيغ: جيد، مع احتفاظ JSON بجولته بلا فقد.
- HTML: وفيّ، لكنه ليس نظيفًا — لا يوجد استخراج للمحتوى الرئيسي.
- تجربة المطوّر: API نظيف من 3 أسطر و
DoclingDocumentمرتب، مع ملاحظة غياب__version__.
لمن هو مناسب: الفرق التي تبني RAG أو خطوط بيانات فوق PDF، والمسوح الضوئية، وملفات Office، وتريد تحويلًا محليًا يحافظ على البنية مع فهم حقيقي للجداول وOCR. ولمن ليس مناسبًا: أي شخص يحتاج إلى زحف ويب حي أو استخراج نظيف للمقال الرئيسي من HTML — فهذه مهمة أداة أخرى.
ولأن هذا تقييم وليس بيانًا صحفيًا، تبقى الحدود واضحة. هذا فحص موجّه — 7 جداول اصطناعية بالإضافة إلى ملفي PDF حقيقيين على جهاز واحد يعمل بالمعالج فقط — وليس اختبار دقة على نطاق TEDS. هناك أمور لم أختبرها، ويجب عليك أنت أيضًا أن تختبرها قبل أن تبني خط إنتاج على Docling: مسار VLM الاختياري (GraniteDocling)، والحجم الفعلي لـ docling-slim، وأي تشغيل على GPU، والخلايا المدمجة المعقدة وغير المنتظمة مع الجداول متعددة الصفحات، ودقة تحويل الصيغ إلى LaTeX، و— وهو الأرجح أن يفاجئك في الإنتاج — ثلاثية التحمل المتعلقة بنمو ذاكرة الدُفعات، وتوسّع الخيوط/GIL، ودورة حياة الكائنات عبر آلاف التحويلات. Docling قوي في ما يدّعيه، مقاسًا لا تسويقًا، وله حواف حقيقية سترغب في رسمها قبل أن تثق به مع مجموعة بيانات. اعرف تحذير الصفحة الضيقة، وخطّط لتنزيل التشغيل الأول، وتحقق بنفسك من السلوك على نطاق واسع.
جرّب Thunderbit لاستخراج بيانات الويب Get Started Free
الأسئلة الشائعة
هل Docling أداة لاستخراج أو زحف الويب؟ لا. Docling يحول المستندات التي لديك مسبقًا — PDF، وDOCX، وPPTX، وXLSX، وHTML، والصور — إلى Markdown أو JSON. لا يجلب روابط، ولا يعرض JavaScript، ولا يتعامل مع الحماية ضد الروبوتات. الزحف إلى الويب الحي مهمة منفصلة تقوم بها أدوات مثل Firecrawl أو واجهة Thunderbit للويب؛ أما Docling فيبدأ من الملف الذي تقدمه له.
ما حجم تثبيت Docling وتنزيل التشغيل الأول؟
الحزمة الافتراضية docling تنتج بيئة افتراضية بحجم يقارب 1.3 جيجابايت لأنها تسحب حزمة ML كاملة كاعتمادات أساسية (torch وحده 536 MiB). أول تحويل PDF ينزل نحو 506 MiB من نماذج التخطيط وTableFormer إلى القرص، إضافة إلى نحو 40 MB من أوزان RapidOCR، ويستغرق حوالي 224 ثانية — معظمها وقت تنزيل. أما التحويل الثاني فيستغرق نحو 0.55 ثانية. إذا كنت تحتاج فقط إلى الصيغ الخفيفة، فإن docling-slim (نواة بحجم ~50 MB) يتجاوز المسار الثقيل.
هل يقوم Docling بـ OCR، وبأي محرك؟ نعم. في ملف PDF ممسوح ضوئيًا بلا طبقة نص، ينطلق OCR تلقائيًا واستعاد النص بوضوح في اختباري. المحرك الافتراضي هو RapidOCR، وليس EasyOCR — وهو خطأ شائع في الكتابات القديمة. EasyOCR الآن إضافة اختيارية. OCR هو المسار البطيء عند التوسع، خصوصًا على CPU.
لماذا حوّل Docling جدولي إلى صورة أو أسقطه؟
غالبًا بسبب تأثير الصفحة شبه الفارغة. نموذج التخطيط RT-DETR في Docling يستخدم سياق الصفحة، والجدول الصغير المنفرد في صفحة شبه خالية قد يُصنَّف على أنه Picture ثم يُسقط من دون أي خطأ. نفس الجدول عندما يوضع وسط نص عادي يتحول بشكل سليم. الحل هو إعطاء نموذج التخطيط سياقًا للصفحة، أو فحص doc.tables بعد التحويل والتنبيه إذا كان عددها صفرًا في أي صفحة.
Docling مقابل Firecrawl — أيهما أستخدم؟ المهمتان مختلفتان، لذا غالبًا ليس الأمر اختيارًا بين واحد وآخر. Firecrawl يزحف إلى الويب الحي، ويعرض JavaScript، ويستخرج المحتوى الرئيسي. Docling يحول المستندات التي لديك مسبقًا، مع بنية جداول PDF حقيقية وOCR، ويعمل دون اتصال. إذا كان المصدر صفحات ويب، فاستخدم أداة ويب (Firecrawl، أو Thunderbit API/MCP/CLI). وإذا كان PDF أو مسوحًا ضوئية أو ملفات Office، فاستخدم Docling. في معظم خطوط الإنتاج الحقيقية ستستخدم الاثنين معًا.




