
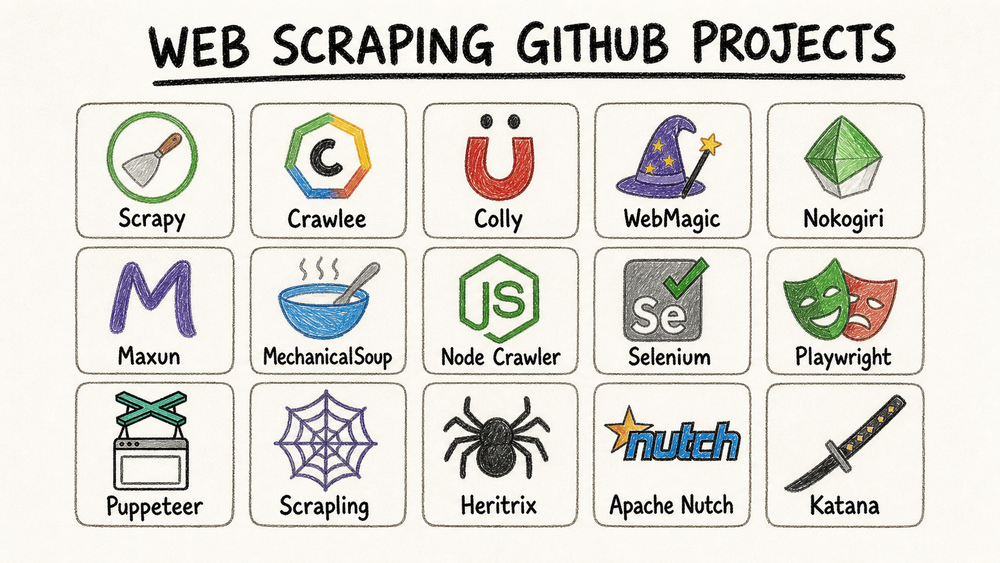
لا يزال الويب في 2026 مليئًا بالبيانات القيّمة، لكن أغلب الفرق لا تحتاج إلى “أداة استخراج” عامة بشكل أعمى. ما تحتاجه فعلًا هو جواب عملي على واحد من ثلاثة أسئلة: أي مشروع مفتوح المصدر يستحق أن تبني عليه، وأي بنية تقنية تقدر تتعامل مع المواقع الحديثة الثقيلة بـ JavaScript، وهل الأفضل لغير المطورين يتجاوزوا GitHub بالكامل ويستخدموا سير عمل بدون كود بدلًا من ذلك.
هذه النسخة المحدّثة مبنية على هذا المسار في اتخاذ القرار. راجعت صفحات المستودعات العامة على GitHub، وأعداد النجوم، ونشاط موجزات الالتزام (commit feed) بتاريخ 6 أغسطس 2026، ثم قارنت المشاريع أدناه بحسب تعقيد الإعداد، ودعم JavaScript، وإشارات الصيانة، وسهولة التصدير، وملاءمة كل مشروع للفئة المستهدفة.
الإجابة السريعة
- اختر Scrapy إذا كنت تريد أكثر إطار عمل Python نضجًا للزحف المنظم واسع النطاق.
- اختر Crawlee إذا كان فريقك يعمل بـ JavaScript أو TypeScript ويريد بنية واحدة لكلٍّ من الزحف عبر HTTP والزحف عبر المتصفح.
- اختر Playwright أو Puppeteer إذا كان الموقع يعتمد بشكل كبير على JavaScript وكانت أتمتة المتصفح الحقيقية هي المطلوب.
- اختر Maxun إذا كنت تريد طبقة مفتوحة المصدر ومرئية وممكن استضافتها ذاتيًا، بدلًا من كتابة كود الاستخراج من الصفر.
- اختر Heritrix أو Apache Nutch أو Katana فقط إذا كانت مهمتك متخصصة: أرشفة المواقع، أو الزحف الموزّع، أو الاستطلاع الأمني.
- اختر Thunderbit إذا كنت لا تريد البناء عبر GitHub أصلًا، وكل ما تريده هو الحصول على البيانات بسرعة إلى Sheets أو Airtable أو Notion أو CSV أو JSON.
جرّب أداة استخراج بدون كود قبل أن تلتزم ببنية برمجية
مقارنة سريعة
تم التحقق من نجوم GitHub وإشارات آخر التزام أدناه عبر الصفحات العامة للمستودعات وموجزات الالتزام بتاريخ 6 أغسطس 2026.
| المشروع | اللغة / النموذج | الإعداد | دعم JS | أفضل استخدام | نجوم GitHub | إشارة آخر التزام |
|---|---|---|---|---|---|---|
| Scrapy | إطار عمل Python | متوسط | لا يوجد دعم JS أصلي | الزواحف واسعة النطاق، التجارة الإلكترونية، الأخبار | 63.7k | 6 أغسطس 2026 |
| Crawlee | إطار عمل Node.js / TypeScript | متوسط | نعم | الجمع بين الاستخراج الثابت والديناميكي في بنية واحدة | 25.2k | 6 أغسطس 2026 |
| Maxun | منصة مفتوحة المصدر بدون كود | متوسط في النشر، سهل للمستخدمين | نعم | مستخدمو الأعمال الذين يريدون تحكمًا مفتوح المصدر | 17.1k | 5 أغسطس 2026 |
| MechanicalSoup | مكتبة Python | سهل | لا | النماذج، الجلسات، والمواقع الثابتة البسيطة | 4.9k | 4 أغسطس 2026 |
| Node Crawler | زاحف Node.js | متوسط | لا | الزحف السريع للمحتوى الثابت وتجميع الخلاصات | 6.8k | 18 يونيو 2026 |
| Heritrix | زاحف Java للأرشفة | متقدم | لا | أرشفة الويب والالتقاط على نطاق النطاقات | 3.3k | 5 أغسطس 2026 |
| Apache Nutch | زاحف Java موزّع | متقدم | لا | الزحف بأسلوب محركات البحث والبيانات الضخمة | 3.3k | 5 أغسطس 2026 |
| Selenium | أتمتة متصفح متعددة اللغات | متوسط | نعم | التدفقات المعتمدة على التفاعل ودقة السلوك في المتصفح | 34.3k | 6 أغسطس 2026 |
| Playwright | أتمتة متصفح متعددة اللغات | متوسط | نعم | المواقع الحديثة الديناميكية والبرمجة المتينة | 94.1k | 6 أغسطس 2026 |
| Puppeteer | أتمتة متصفح Node.js | متوسط | نعم | الأتمتة والاستخراج المرتكزان على Chrome | 95.4k | 6 أغسطس 2026 |
| Scrapling | مجموعة أدوات Python للاستخراج الخفي | متوسط | نعم | استخراج المتصفح الحسّاس لمكافحة الحظر | 72.8k | 30 يوليو 2026 |
| Katana | زاحف / واجهة سطر أوامر Go | متوسط | وضع headless اختياري | الزحف الأمني واكتشاف الروابط | 17.3k | 5 أغسطس 2026 |
| Colly | إطار عمل Go | متوسط | لا | الاستخراج الثابت عالي الأداء | 25.4k | 18 يونيو 2026 |
| WebMagic | إطار عمل Java | متوسط | لا يوجد دعم JS أصلي | خطوط استخراج Java العامة | 11.7k | 20 ديسمبر 2025 |
| Nokogiri | محلّل Ruby | سهل | لا | تطبيقات Ruby وتدفقات التحليل المخصصة | 6.3k | 3 أغسطس 2026 |
| Thunderbit | إضافة Chrome بدون كود مدعومة بالذكاء الاصطناعي | جاهز للاستخدام فورًا | نعم | الفرق غير التقنية التي تريد بيانات قابلة للاستخدام بسرعة | غير متاح | منتج مُدار، ويتم تحديثه باستمرار |
قبل أن تختار مشروع GitHub، اسأل نفسك: هل تريد فعلًا سير عمل برمجي؟
Thunderbit ليس مشروعًا على GitHub، وهذا بالضبط سبب وجوده في هذا الدليل. فجزء كبير من الأشخاص الذين يبحثون عن “أفضل مشاريع GitHub لاستخراج البيانات من الويب” لا يريدون في الحقيقة إدارة بنية زاحف كاملة. هم يريدون بيانات منظمة من موقع حي الآن.
Thunderbit هو أقصر طريق من البحث في الاستخراج المعتمد على الكود إلى التنفيذ الجاهز للأعمال:
- الأفضل لـ: التنقيب عن العملاء المحتملين، مراقبة التجارة الإلكترونية، جمع بيانات العقارات، أبحاث التوظيف، وعمليات العمل التي تعتمد على المتصفح أولًا.
- ما الذي يميّزه: اقتراح الحقول بالذكاء الاصطناعي، إثراء الصفحات الفرعية، التعامل مع الصفحات الديناميكية، والتصدير إلى Sheets وAirtable وNotion وCSV وJSON دون كتابة منطق استخراج.
- ملاحظة مهمة: إذا كانت مهمتك منصة زحف داخلية طويلة العمر وبنية تحتية مخصصة، فإن إطار العمل مفتوح المصدر يمنحك تحكمًا أكبر.
إذا أردت رؤية المسار بدون كود قبل أن تقرر أن تعيش داخل GitHub، فهذه الجولة الحالية في Thunderbit هي أسرع اختبار واقعي:
جرّب Thunderbit AI Web Scraper مجانًا
كيف قيّمتُ مشاريع GitHub هذه لاستخراج البيانات
ليست كل مشاريع GitHub الخاصة بالاستخراج قابلة للمقارنة المباشرة. فبعضها أطر عمل كاملة، وبعضها مكتبات لأتمتة المتصفح، وبعضها محلّلات، وبعضها زواحف متخصصة بُنيت للأرشيف أو لفرق الأمن.
ولكي تكون القائمة مفيدة، أوليت الأولوية للمشاريع التي ما زالت تستوفي أربعة معايير عملية:
- ما زال وراءها واقع سوقي.
كثرة النجوم وحدها لا تكفي، لكن انخفاض الاستخدام مع صيانة متقادمة غالبًا علامة سيئة. - ما زالت تظهر عليها حركة فعلية.
في هذه النسخة المحدّثة، راجعت نشاط موجزات الالتزام العامة بتاريخ 6 أغسطس 2026 بدلًا من الاعتماد على أرقام قديمة. - تحلّ مهمة استخراج حقيقية.
استبعدت المستودعات الأنيقة لكن الغامضة التي لا تتطابق جيدًا مع سير العمل الفعلي للأعمال أو البحث. - مختلفة بما يكفي لتُدرج في القائمة المختصرة.
الهدف ليس إغراقك بـ 50 مستودعًا، بل مساعدتك على الاختيار بين الأطر، وحِزم المتصفح، والأدوات المفتوحة بدون كود، والزواحف المتخصصة.
وأبعاد المقارنة هي نفسها التي تحسم النجاح أو الفشل في الواقع غالبًا:
- تعقيد الإعداد: مدى سرعة وصول المستخدم الجديد إلى أول عملية استخراج ناجحة.
- دعم JavaScript: هل يستطيع المشروع التعامل مع المواقع الحديثة المعتمدة على العرض من جهة العميل.
- صحة المشروع: هل يبدو المستودع حيًا بما يكفي للثقة به.
- إدارة البيانات: هل يخرج المشروع بيانات منظمة أم يترك لك مزيدًا من العمل.
- ملاءمة الجمهور: هل هو مخصص للمبتدئين، أم لمهندسي البيانات، أم لفرق الأمن، أم للمشغلين غير التقنيين.
تعقيد الإعداد: كم بسرعة يمكنك البدء؟
لا يزال هذا التصنيف صالحًا، لكن الإطار المفيد في 2026 أصبح أبسط:
- جاهز للاستخدام فورًا: Thunderbit لمستخدمي الأعمال؛ وMechanicalSoup أو Nokogiri للبرامج الخفيفة المكتوبة من الكود مباشرة.
- متوسط: Scrapy وCrawlee وMaxun وSelenium وPlaywright وPuppeteer وColly وKatana وScrapling وWebMagic وNode Crawler تتطلب بعض البرمجة أو العمل عبر CLI أو النشر.
- متقدم: Heritrix وApache Nutch منطقيان فقط إذا كنت تحتاج بالفعل إلى أرشفة أو زحف موزّع قائم على Java.
ويستحق Maxun ذكرًا خاصًا هنا لأنه يقف في المنتصف. فالمنصة نفسها تحتاج إلى نشر، لكن تجربة المستخدم النهائي أخف بكثير من العمل مباشرة مع Scrapy أو Playwright.
دعم المحتوى الديناميكي: أي المشاريع تستطيع التعامل مع الويب الحديث؟
المواقع الحديثة مليئة بـ React وVue والتمرير اللانهائي واستدعاءات API الخلفية وتدفّقات تسجيل الدخول الثقيلة. هنا يفترق “حصلت على HTML” عن “حصلت على البيانات التي أحتاجها فعلًا”.
تنقسم المشاريع في هذه القائمة إلى ثلاث فئات:
- أتمتة كاملة للمتصفح: Selenium وPlaywright وPuppeteer تنفّذ JavaScript بالكامل، ولا تزال الخيارات الأكثر موثوقية للمواقع المعتمدة على التفاعل.
- دعم هجين أو عبر غلاف: يمكن لـ Crawlee التبديل بين الزحف الخفيف عبر HTTP والاستخراج المدعوم بالمتصفح. يضيف Scrapling أدوات تركّز على التخفي للأهداف الأصعب. ويستخدم Maxun نهجًا مدعومًا بالمتصفح خلف واجهة مرئية.
- HTML ثابت فقط افتراضيًا: Scrapy وMechanicalSoup وNode Crawler وColly وWebMagic وNokogiri وHeritrix وApache Nutch لا تحلّ مشاكل العرض الحديثة أصلًا بشكل أصلي.
إذا كان أكبر سؤال لديك هو: “هل يستطيع هذا المكدس التعامل مع صفحات ثقيلة بـ JavaScript دون أن أكتب كل خطوة متصفح يدويًا؟”، فشرح Playwright الحالي لاستخراج البيانات هو أفضل اختبار واقعي في منتصف الطريق:
صحة المشاريع: أي المستودعات تبدو جديرة بالثقة في 2026؟
اعتمدت نسخة 2025 من هذا المقال على عدد النجوم وبعض ملاحظات التحديث القديمة. وهذا لم يعد كافيًا. لذلك تحققت من أعداد النجوم الحالية وإشارات الالتزام الأخيرة بتاريخ 6 أغسطس 2026.
والتقسيم الصحي يبدو كالتالي:
- نشط بوضوح الآن: Scrapy وCrawlee وMaxun وMechanicalSoup وHeritrix وApache Nutch وSelenium وPlaywright وPuppeteer وScrapling وKatana وNokogiri كلها دفعت التزامات عامة خلال الأسبوعين السابقين لهذا الفحص.
- حي لكنه أبطأ في الحركة: Colly وNode Crawler دفعا آخر تحديث لهما في 18 يونيو 2026. ما زالا قابلين للاستخدام، لكنهما يتحدثان على شكل دفعات متقطعة بدلًا من الوتيرة الأسبوعية لـ Playwright أو Crawlee.
- يتطلب مزيدًا من الحذر: WebMagic هو الفجوة الحقيقية الوحيدة في هذه القائمة. آخر إشارة التزام عامة وجدتها كانت 20 ديسمبر 2025، لذا أتعامل معه كخيار مستقر أكثر من كونه مشروعًا يتطور بنشاط.
وهذا مهم لأن أسلوب الصيانة يجب أن يؤثر في قائمتك المختصرة:
- إذا أردت خيارًا آمنًا افتراضيًا لبناء هندسي جديد، فامنح الأولوية للمستودعات الأكثر نشاطًا بوضوح.
- إذا كانت الأداة بسيطة وحالتك الاستخدامية ضيقة، فالتحديثات الأبطأ مقبولة.
- إذا كان المشروع متخصصًا، فاحكم عليه أولًا بمدى ملاءمته، لا بعدد الإصدارات الأسبوعية.
أفضل 15 مشروع GitHub لاستخراج البيانات من الويب في 2026
أطر عمل للاستخراج واسع النطاق أو للاستخدام العام
1. Scrapy
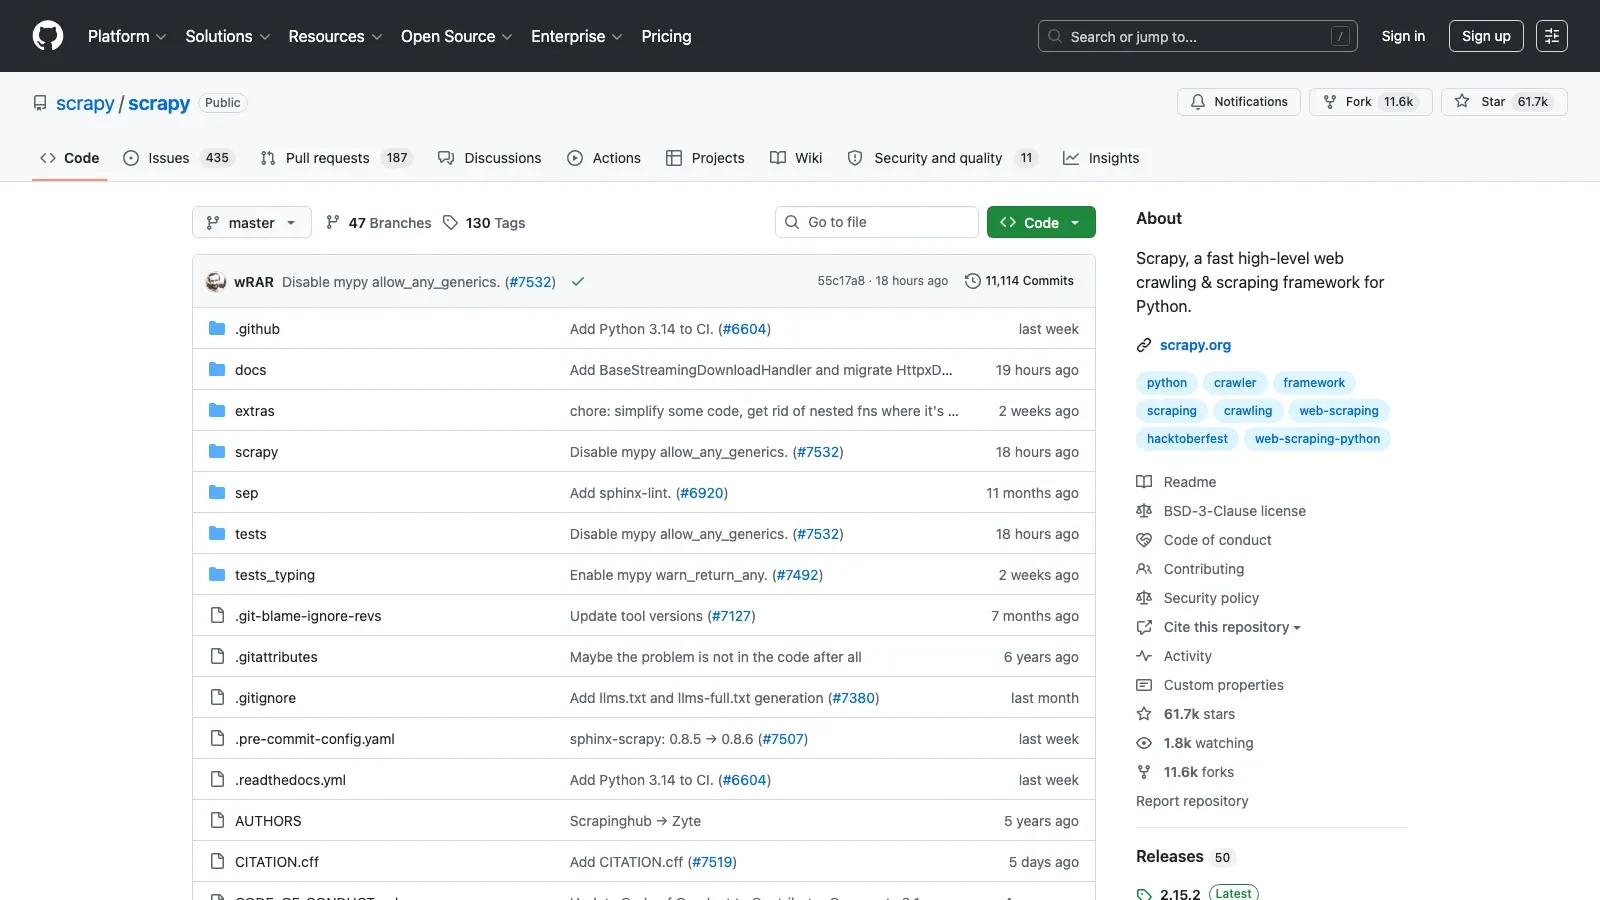
ما يزال Scrapy هو الخيار الافتراضي في Python عندما تكون المهمة أكبر من مجرد سكربت سريع. إذا كنت تريد spiders وpipelines وmiddleware وتحديدًا للسرعة ومعدلات المحاولة وإيكولوجيا ناضجة، فهو يظل الرهان الأكثر أمانًا من المصادر المفتوحة في هذه القائمة.
- الإعداد: متوسط
- الأفضل لـ: كتالوجات التجارة الإلكترونية، استخراج الأدلة، زحف الأخبار، وأنظمة الاستخراج الداخلية طويلة العمر
- دعم JS: لا يدعم العرض الأصلي؛ يمكن دمجه مع Playwright أو Selenium عند الحاجة
- لماذا تختاره: بنية ناضجة، توثيق قوي، وإحدى أفضل نسب القوة إلى المجتمع في عالم الاستخراج مفتوح المصدر
- ملاحظة مهمة: منحنى التعلم حقيقي إذا لم تعمل من قبل داخل إطار زاحف
إذا أردت معرفة ما إذا كان مسار Scrapy مناسبًا لك قبل الالتزام به، فهذه الجولة الحالية للمبتدئين مفيدة جدًا:
2. Crawlee
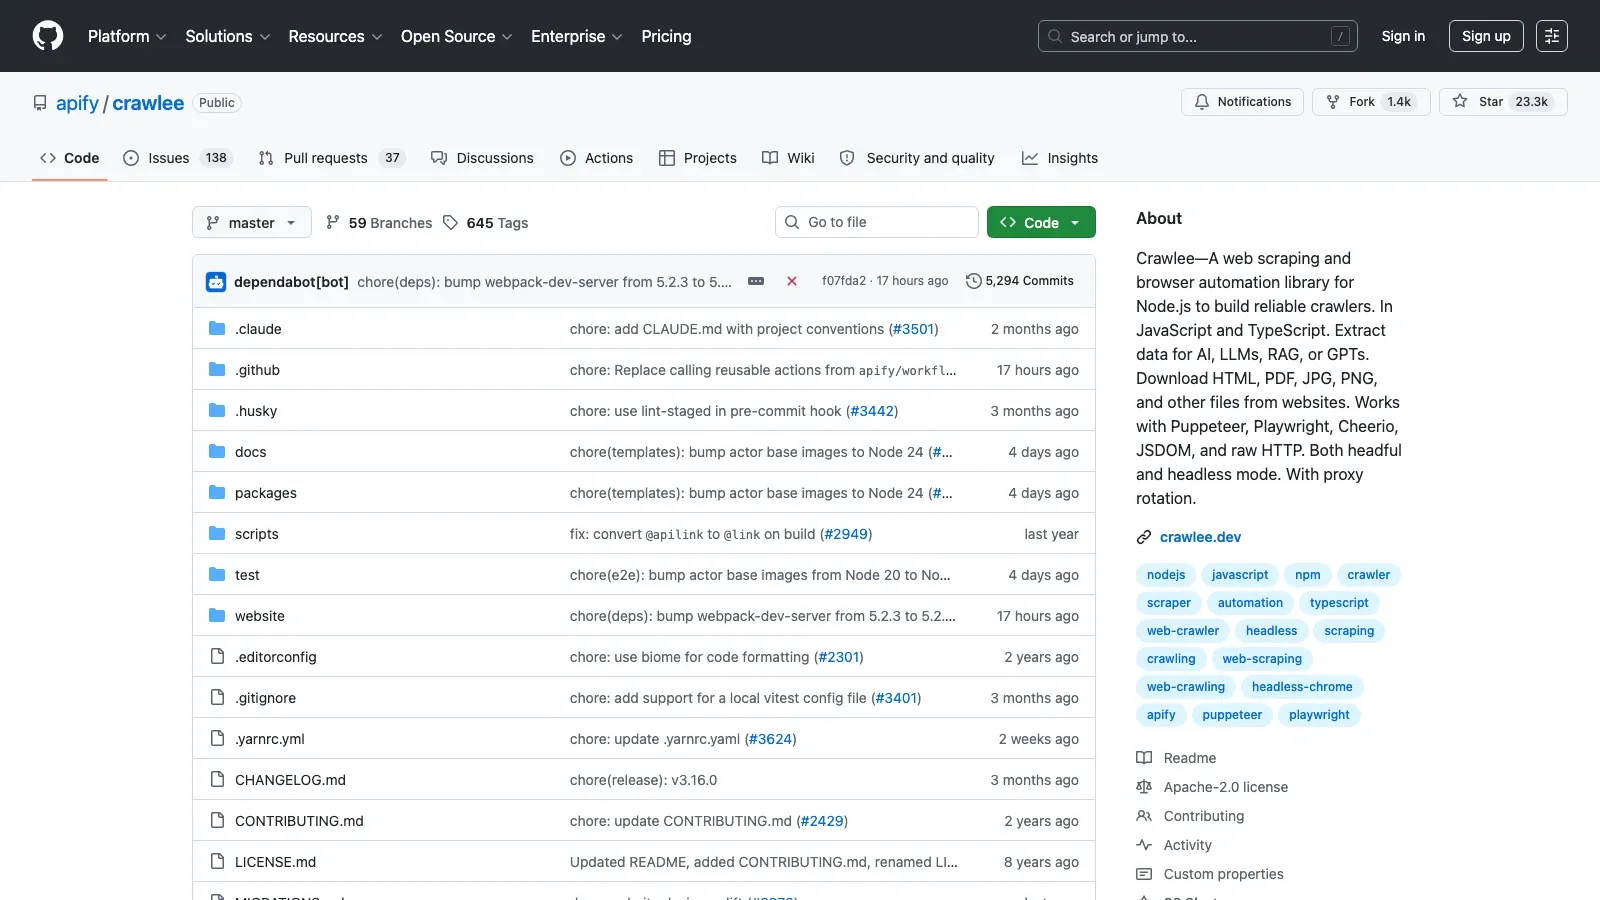
أصبح Crawlee الخيار الأكثر جاذبية لفرق JavaScript أو TypeScript عندما تريد مشروعًا واحدًا يغطي الزحف الخفيف والاستخراج المدعوم بالمتصفح. والميزة الحقيقية هي القدرة على التبديل بين سير عمل يعتمد على HTTP أولًا وبين سير يعتمد على Playwright أو Puppeteer.
- الإعداد: متوسط
- الأفضل لـ: فرق JS وTS، والأهداف الهجينة الثابتة والديناميكية، والأدوات الداخلية الثقيلة بالأتمتة
- دعم JS: نعم
- لماذا تختاره: نموذج تشغيل مرن، أدوات مساعدة لتفادي الحظر، وتجربة أفضل مع المتصفح مقارنة بالحِزم القديمة المخصّصة للزحف فقط
- ملاحظة مهمة: يكون منطقيًا أكثر إذا كان فريقك مرتاحًا أصلًا مع Node.js
3. Colly
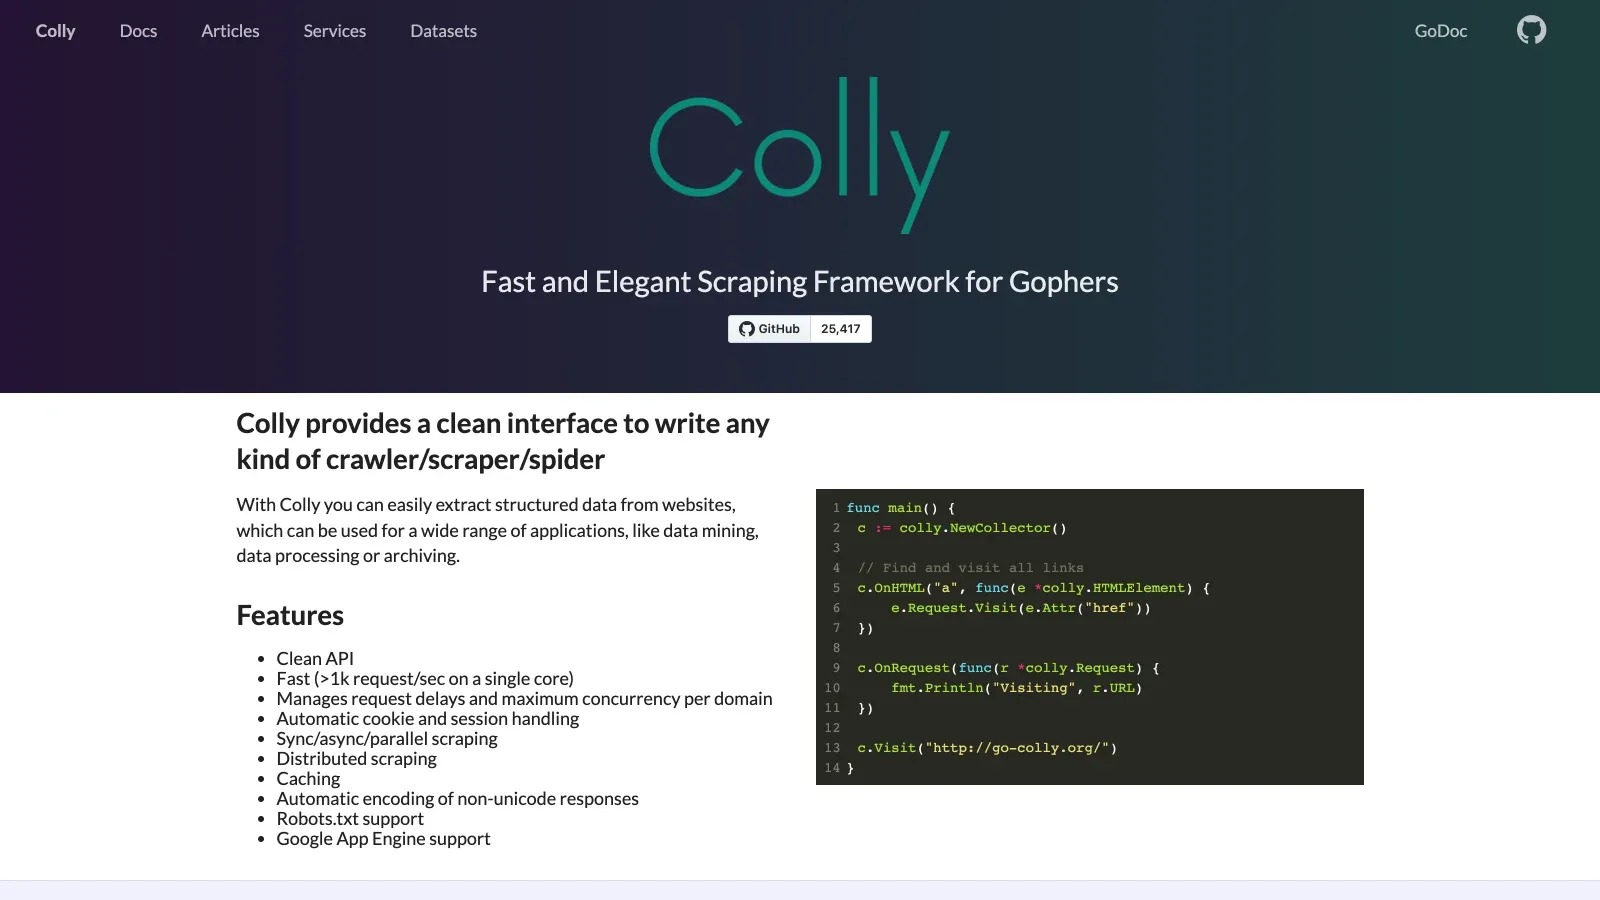
لا يزال Colly واحدًا من أنظف الخيارات عالية الأداء لفرق Go التي لا تحتاج إلى عرض المتصفح افتراضيًا. إنه سريع وأنيق وعملي عندما تكون عنق الزجاجة هي الحجم وليس تعقيد الواجهة.
- الإعداد: متوسط
- الأفضل لـ: مطوري Go الذين يبنون زواحف ثابتة سريعة
- دعم JS: لا يوجد عرض أصلي
- لماذا تختاره: التوازي، وتحديد المعدلات، وواجهة ممتعة للمهام عالية الإنتاجية
- ملاحظة مهمة: ليس الخيار الصحيح عندما تكون أتمتة المتصفح هي المتطلب الحقيقي
4. WebMagic
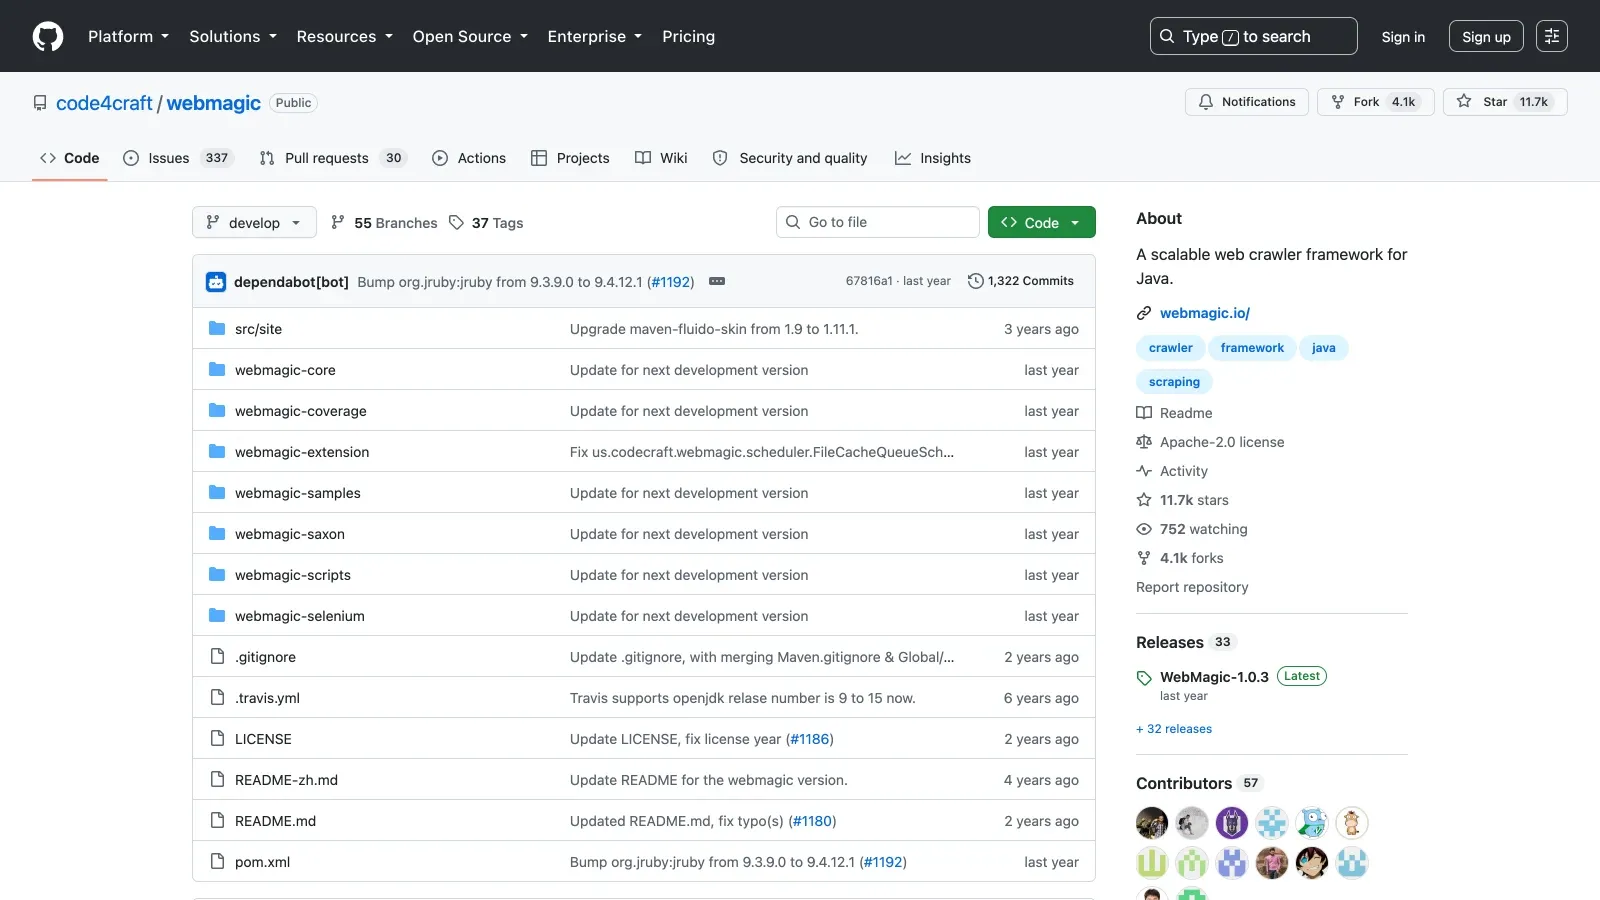
يبقى WebMagic النظير في Java للفرق التي تحب نموذج Scrapy لكنها تريد البقاء ضمن منظومة JVM. وما يزال منطقيًا لبيئات Java، حتى لو كانت شعبيته المحيطة أقل من خيارات Python أو Node.
- الإعداد: متوسط
- الأفضل لـ: خطوط استخراج مبنية على Java
- دعم JS: لا يوجد عرض أصلي
- لماذا تختاره: المجدولات، وpipelines، وبنية إطار عمل واضحة
- ملاحظة مهمة: الإيكولوجيا أهدأ من خيارات Python وNode الأكبر، وآخر إشارة التزام عامة وجدتها كانت 20 ديسمبر 2025، لذا أتعامل معه كخيار مستقر أكثر من كونه يتطور بنشاط
5. Nokogiri
Nokogiri ليس إطار زحف. إنه المحلل الذي لا يزال مطورو Ruby يعودون إليه عندما يحتاجون إلى معالجة HTML أو XML بشكل نظيف داخل سكربت أو تدفق تطبيق مخصص.
- الإعداد: سهل
- الأفضل لـ: تطبيقات Ruby وRails التي تحتاج إلى التحليل بدل إطار زحف كامل
- دعم JS: لا
- لماذا تختاره: سريع، ثابت، وآمن افتراضيًا في التحليل
- ملاحظة مهمة: ما زلت بحاجة إلى إضافة طبقة HTTP أو الجلسات أو المتصفح بنفسك
مشاريع خفيفة وثابتة ومناسبة للمبتدئين
6. Maxun
Maxun هو الإجابة مفتوحة المصدر لمن يحب فكرة الاستخراج بدون كود، لكنه يريد أيضًا الاستضافة الذاتية والتحكم بمستوى GitHub. إنه أكثر سهولة بكثير لغير المطورين من إطار عمل خالص، لكنه يظل مشروعًا مفتوح المصدر فعليًا وليس خدمة SaaS مغلقة.
- الإعداد: متوسط عند النشر، وأسهل للمستخدم النهائي بعد الإعداد
- الأفضل لـ: الفرق التي تريد واجهة مرئية مع تحكم مفتوح المصدر
- دعم JS: نعم
- لماذا تختاره: استخراج بالنقر، تدفقات متعددة الخطوات، وإتاحة أفضل من كتابة الكود من الصفر
- ملاحظة مهمة: خطوة النشر ما تزال أثقل من إضافة متصفح مُدارة بالكامل
7. MechanicalSoup
يستحق MechanicalSoup مكانه لأن ليس كل استخراج يحتاج إلى متصفح بلا واجهة. إذا كانت المشكلة الحقيقية هي إدارة الجلسات أو إرسال النماذج أو التنقل في مسار ثابت خلف تسجيل الدخول، فهو يبقى صغيرًا ومفهومًا بشكل مريح.
- الإعداد: سهل
- الأفضل لـ: النماذج البسيطة، الصفحات الثابتة المحمية بتسجيل دخول، وسكربتات أتمتة Python السريعة
- دعم JS: لا
- لماذا تختاره: قليل التعقيد، كود مقروء، ومدخل لطيف لمستخدمي Python
- ملاحظة مهمة: فائدته تتراجع بسرعة في المواقع الثقيلة بـ JS
8. Node Crawler
لا يزال Node Crawler له مكان إذا كان هدفك HTML ثابتًا وكنت تهتم أساسًا بالتوازي، والطوابير، والتحليل بأسلوب Cheerio. لن أختاره لمشروع جديد يعتمد على المتصفح بشكل كبير، لكنه قد يظل مناسبًا جدًا لجمع الخلاصات والمواقع الثابتة.
- الإعداد: متوسط
- الأفضل لـ: الزحف السريع للمحتوى الثابت والتجميع
- دعم JS: لا
- لماذا تختاره: أدوات تحكم في التوازي وسير عمل تحليل مألوف يشبه jQuery
- ملاحظة مهمة: آخر إشارة التزام عامة وجدتها كانت 18 يونيو 2026، والفجوات بين التحديثات طويلة، لذا ليس المكان الذي سأبدأ منه في بنية طويلة العمر لموقع ديناميكي جديد
مشاريع المواقع الديناميكية وأتمتة المتصفح
9. Selenium
Selenium أقدم من Playwright، لكنه لا يزال مهمًا عندما يتفوق السلوك الدقيق للمتصفح وصدق التفاعل على الأناقة. وهو يظل مهمًا خصوصًا عندما يتقاطع الاستخراج مع QA أو أتمتة الانحدار أو المواقع التي تتطلب سلوك متصفح حرفيًا جدًا.
- الإعداد: متوسط
- الأفضل لـ: التدفقات المعتمدة على التفاعل، وأتمتة المتصفح القديمة، والفرق التي تستخدم Selenium بالفعل للاختبار
- دعم JS: نعم
- لماذا تختاره: تغطية واسعة للمتصفحات، نظام بيئي ضخم، ونضج طويل الأمد
- ملاحظة مهمة: غالبًا ما تبدو الحِزم الأحدث أنظف وأسرع لأعمال الاستخراج الجديدة
10. Playwright
Playwright هو ترشيحي الافتراضي الحديث لفرق المطورين التي تحتاج إلى استخراج من صفحات ديناميكية. فدمج دعم عدة متصفحات مع سلوك انتظار قوي وواجهات برمجية نظيفة يجعله أسهل مشروع أتمتة متصفح في هذه القائمة يمكن التوصية به على نطاق واسع.
- الإعداد: متوسط
- الأفضل لـ: تطبيقات الويب الحديثة، تدفقات تسجيل الدخول، والأهداف الثقيلة بـ JavaScript
- دعم JS: نعم
- لماذا تختاره: تحكم عبر المتصفحات، بدائيات أتمتة قوية، وصيانة نشطة
- ملاحظة مهمة: ما زلت مسؤولًا عن المحددات، وبنية المتصفح، وإعادة المحاولة، وجودة المخرجات
11. Puppeteer
لا يزال Puppeteer كلاسيكي Chrome-first. إذا كان فريقك يعمل أصلًا بـ Node.js ويستهدف أساسًا تدفقات متوافقة مع Chromium، فإنه يظل خيارًا عمليًا ومفهومًا جيدًا.
- الإعداد: متوسط
- الأفضل لـ: الأتمتة المرتكزة على Chrome، لقطات الشاشة، ملفات PDF، واستخراج المحتوى الديناميكي
- دعم JS: نعم
- لماذا تختاره: تحكم غني بالمتصفح وكثرة ضخمة من أمثلة المجتمع
- ملاحظة مهمة: أصبح Playwright الخيار الأقوى افتراضيًا إذا كنت تريد تغطية أوسع للمتصفحات أو قصة أحدث متعددة المتصفحات
12. Scrapling
Scrapling هو أكثر إضافة متخصصة وحداثة في هذه المجموعة. وهو مخصص لمن يعرف مسبقًا أن عرض المتصفح ليس المشكلة الوحيدة، بل يحتاج أيضًا إلى التخفي، وإدراك البروكسي، وموقف أقوى ضد أدوات الحظر.
- الإعداد: متوسط
- الأفضل لـ: الاستخراج الخفي، الأهداف الحساسة لمكافحة الحظر، والعمل الديناميكي القائم على Python
- دعم JS: نعم
- لماذا تختاره: تطوير نشط وتركيز أشد على احتكاكات الاستخراج التي تتجاهلها الأطر الأبسط
- ملاحظة مهمة: مبالغ فيه للمواقع الثابتة البسيطة وأقل ملاءمة للمبتدئين من MechanicalSoup أو Scrapy
زواحف متخصصة للبحث والأمن ومهام البنية التحتية
13. Heritrix
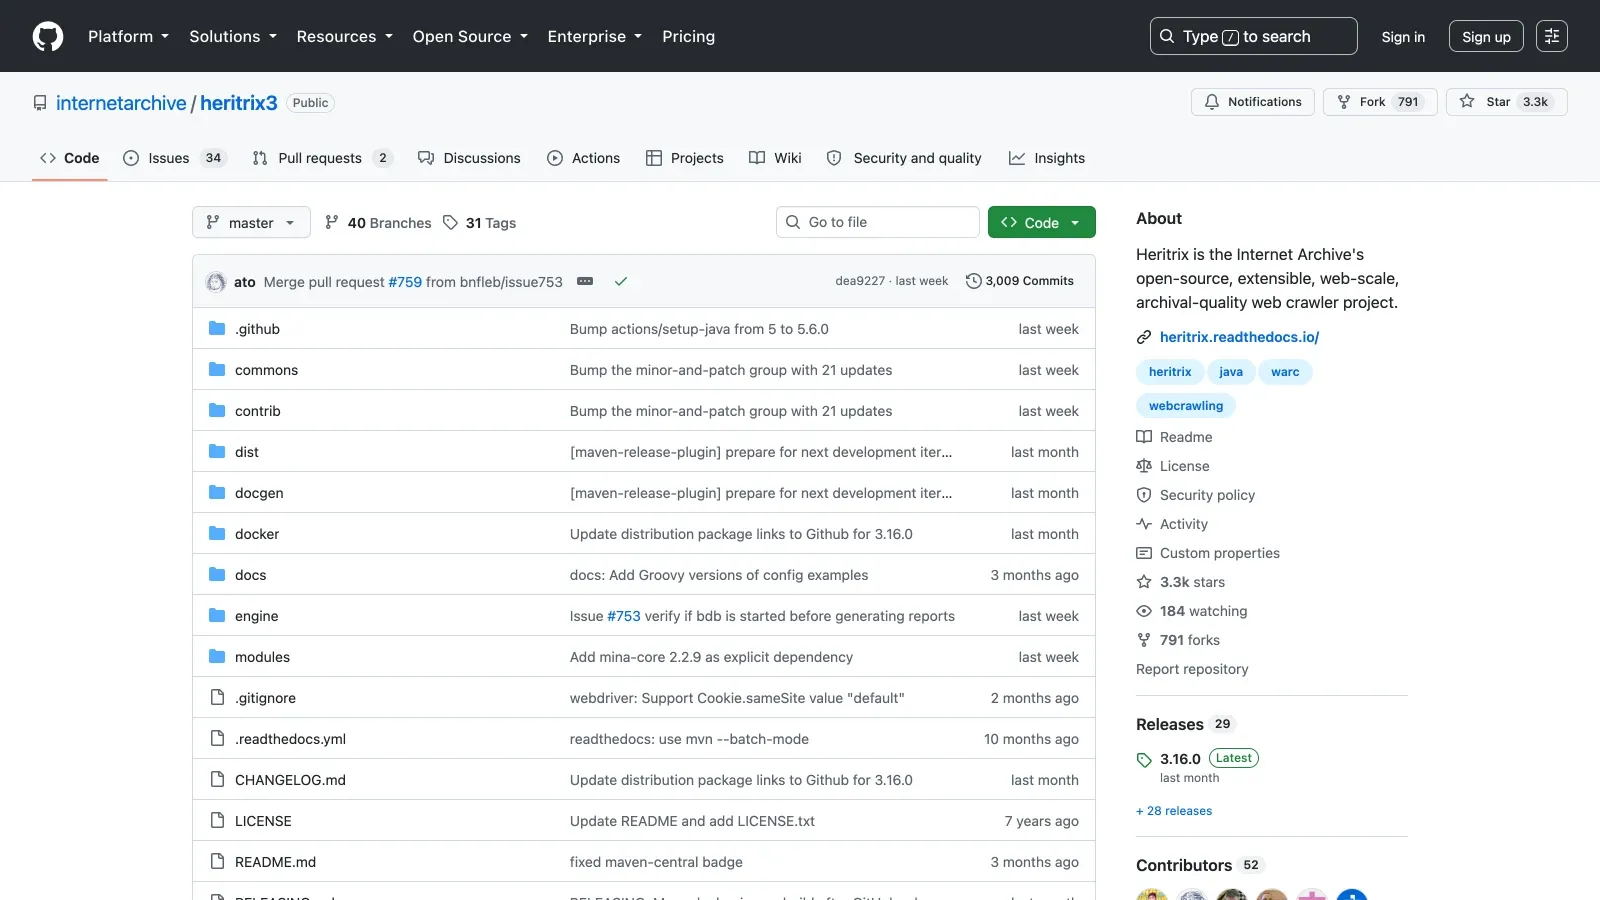
Heritrix ليس أداة لاستخراج بيانات المقارنة بين المنتجات. إنه زاحف أرشفة بُني للمؤسسات التي تهتم بالحفظ الكامل للمواقع والالتقاط المتوافق مع المعايير.
- الإعداد: متقدم
- الأفضل لـ: الأرشيفات والمكتبات وسير عمل الحفظ واسع النطاق
- دعم JS: لا
- لماذا تختاره: إرث Internet Archive وسير عمل أرشفة متمحور حول WARC
- ملاحظة مهمة: أداة غير مناسبة لاستخراج القوائم أو الأسعار المستهدفة
14. Apache Nutch
لا يزال Apache Nutch منطقيًا للفرق التي تفكر من منظور الزحف الموزع أو الفهرسة أو جمع البيانات على نمط محركات البحث، بدلًا من الاستخراج التجاري لمهمة واحدة.
- الإعداد: متقدم
- الأفضل لـ: الزحف الموزع، مجموعات البيانات البحثية، وجمع البيانات بأسلوب محركات البحث
- دعم JS: لا
- لماذا تختاره: نموذج الإضافات والألفة المؤسسية على طريقة Apache
- ملاحظة مهمة: ثقيل جدًا على معظم المهام التي تبدأ من جدول بيانات أو من المتصفح مباشرة
15. Katana
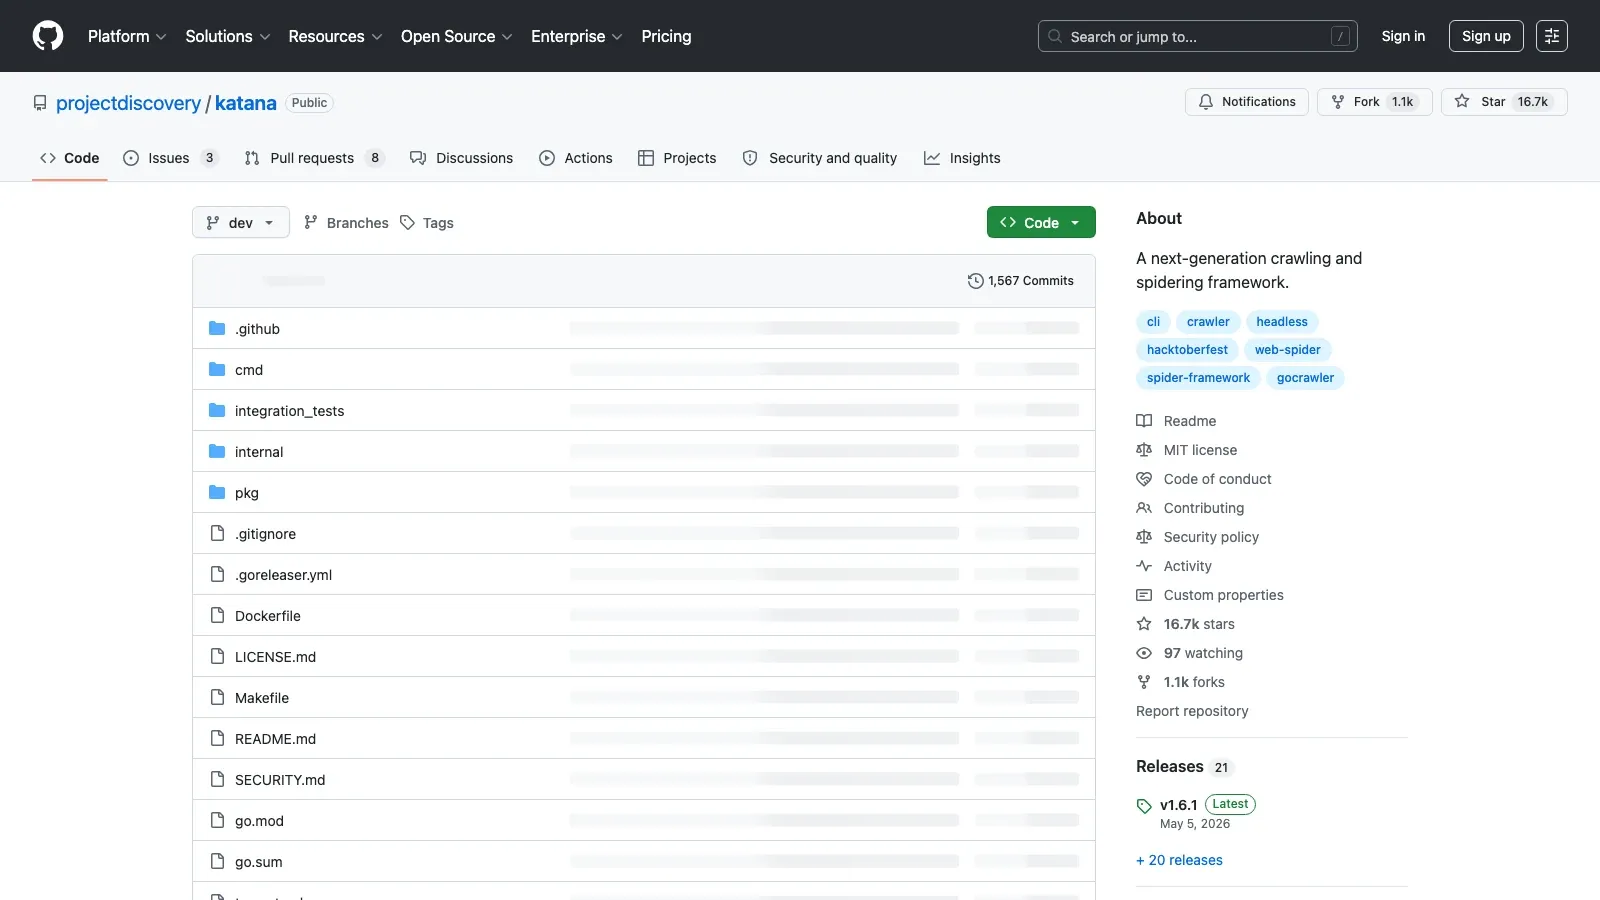
ينتمي Katana إلى هذه القائمة لأن الزحف الأمني حالة استخدام قائمة بذاتها. فإذا كانت المهمة استطلاعًا أو اكتشاف نقاط النهاية أو كشف بنية الهدف بسرعة، فـ Katana أنسب بكثير من إطار استخراج عام.
- الإعداد: متوسط
- الأفضل لـ: الاستطلاع الأمني، اكتشاف الروابط، وإنشاء جرد لعناوين URL
- دعم JS: وضع headless اختياري
- لماذا تختاره: السرعة، التوازي، ونموذج زحف متمحور حول الأمن
- ملاحظة مهمة: ليس مصممًا ليكون مكدس استخراج بيانات أعمال مصقولًا
قائمتي المختصرة بحسب نوع الفريق
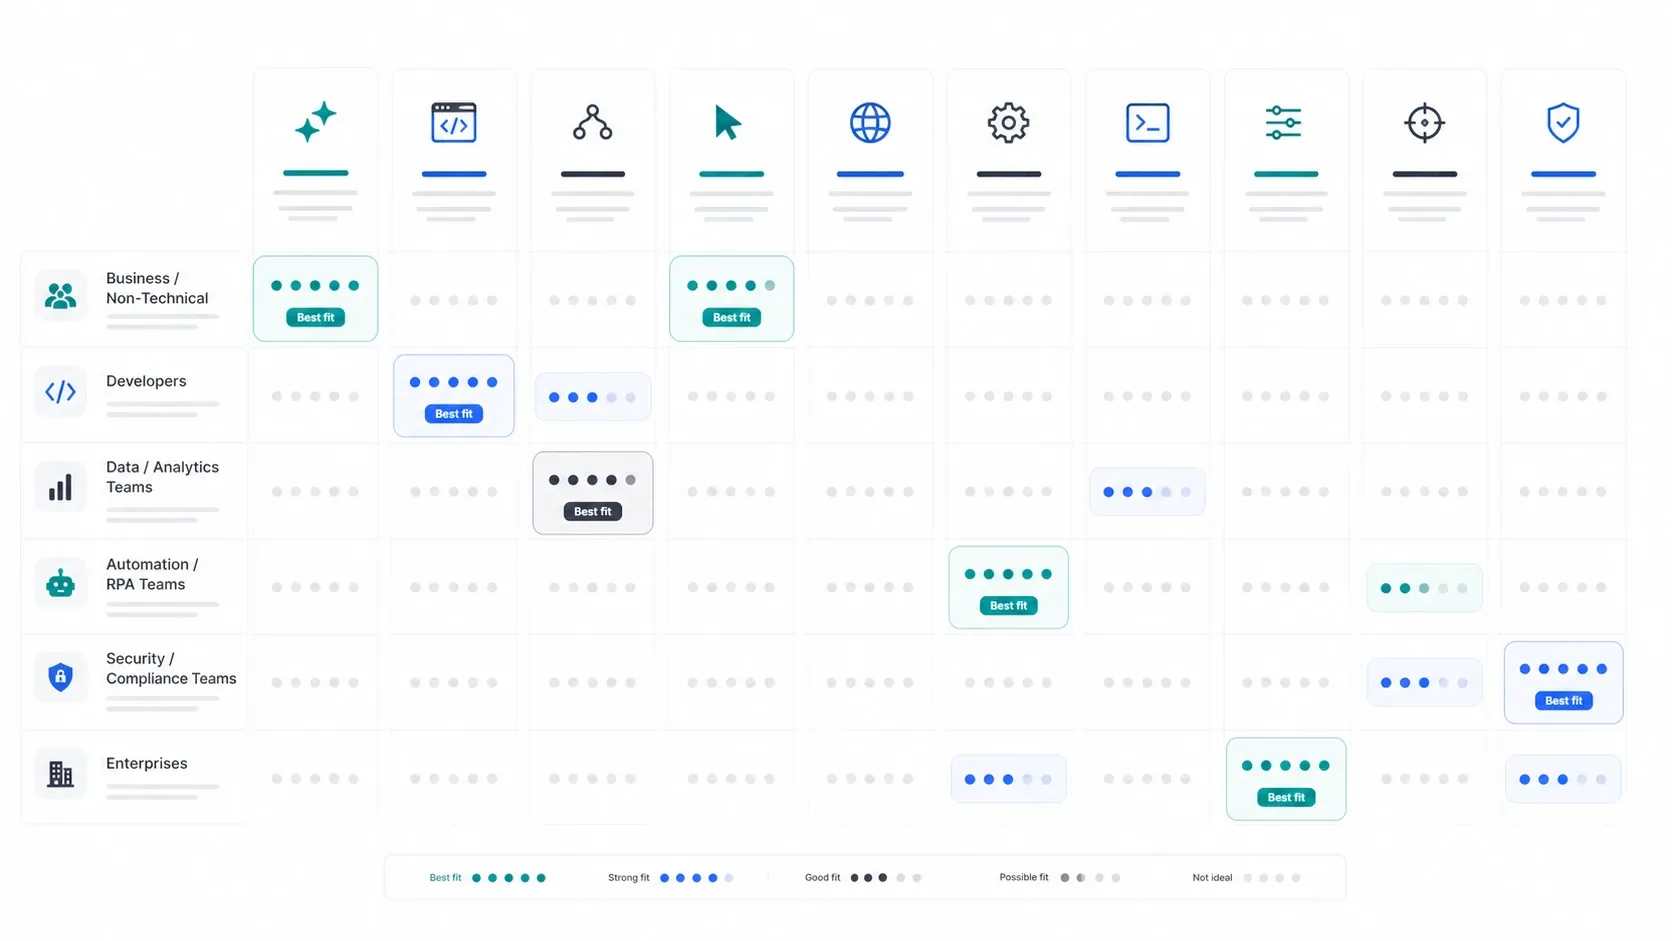
- مطورو Python: ابدأ بـ Scrapy للأطر، وMechanicalSoup للتدفقات الثابتة الأصغر، وScrapling إذا كان التخفي أو مقاومة الحظر جزءًا من المشكلة أصلًا.
- فرق JavaScript أو TypeScript: ابدأ بـ Crawlee كإطار، وPlaywright لأتمتة المتصفح، وPuppeteer إذا كانت سير العمل المرتكزة على Chrome كافية.
- فرق Go: Colly للاستخراج، وKatana للزحف الأمني الذي يركز على الاكتشاف.
- فرق Java: WebMagic للزحف العام، وHeritrix للالتقاط الأرشيفي، وApache Nutch للزحف الموزع بأسلوب البحث.
- المشغلون غير التقنيين: Maxun إذا كنت تريد استضافة ذاتية مفتوحة المصدر، أو Thunderbit إذا كنت تريد سير عمل مُدارًا بدون كود يصل إلى مخرجات قابلة للاستخدام بسرعة أكبر.
بأي مشروع يجب أن يبدأ معظم الناس فعليًا؟
إليك الإجابة العملية:
- إذا كنت تريد بناء أداة استخراج تملكها بنفسك، فابدأ بـ Scrapy أو Crawlee.
- إذا كنت تحتاج إلى التحكم في متصفح حقيقي، فابدأ بـ Playwright.
- إذا كنت تحتاج إلى طبقة مرئية مفتوحة المصدر، فابدأ بـ Maxun.
- إذا كنت تحتاج إلى أرشفة متخصصة أو زحف أمني متخصص، فاختر Heritrix أو Nutch أو Katana فقط لأن حالة الاستخدام لديك تتطلبها بوضوح.
- إذا كنت تريد تجاوز الكود والحصول على البيانات الآن، فلا تُجبر نفسك على البدء من GitHub. استخدم Thunderbit.
الخلاصة
أفضل مشروع GitHub لاستخراج البيانات من الويب في 2026 لا يعتمد على عدد النجوم الخام بقدر ما يعتمد على العبء الذي أنت مستعد لتحمّله. ما يزال Scrapy الخيار الافتراضي الأكثر أمانًا في Python. وCrawlee هو أفضل خيار حديث لإطار JavaScript. وPlaywright هو أقوى خيار افتراضي لأتمتة المتصفح. وMaxun هو أكثر مسار بدون كود مفتوح المصدر إثارة للاهتمام. أما Heritrix وApache Nutch وKatana فهي أدوات متخصصة ممتازة فقط عندما تكون المهمة متخصصة بالفعل.
المهم ألا تخلط بين “الأقوى” و“الأكثر ملاءمة”. فإذا كان فريقك يحتاج فقط إلى بيانات نظيفة في جدول بيانات، فقد لا يكون GitHub أصلًا هو نقطة البداية الصحيحة.
تخلّص من عبء الصيانة وابدأ الاستخراج أسرع Get Started Free



