
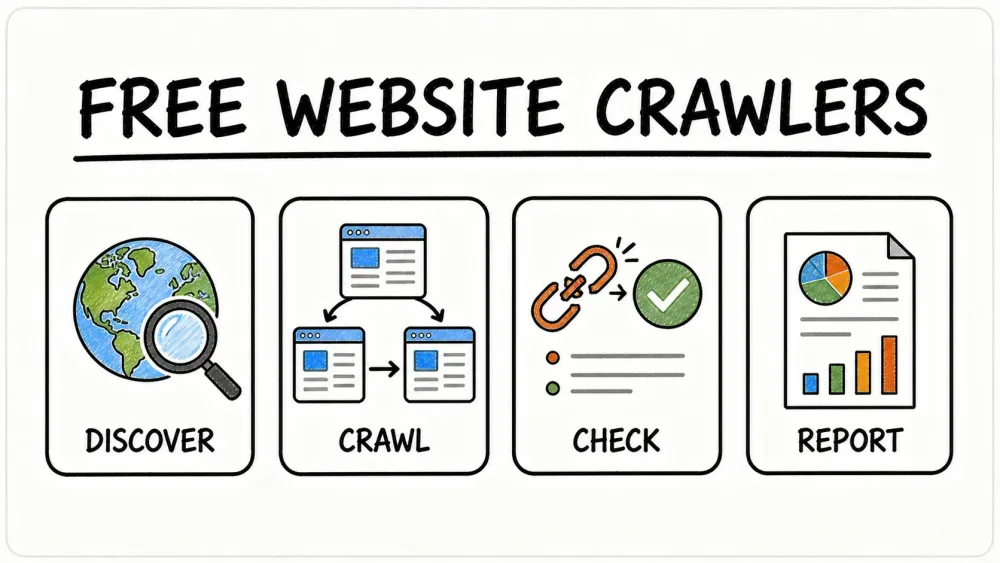
روابط معطّلة. صفحات يتيمة. صفحة “تجريبية” من عام 2019 ويبدو أن Google فهرسها بطريقة ما. إذا كنت تدير موقعًا إلكترونيًا، فأنت تعرف هذا الإزعاج تمامًا.
أداة زحف جيدة تلتقط كل هذا — وتبني خريطة كاملة لموقعك حتى تتمكن فعلًا من معالجة المشكلات. لكن كثيرين يخلطون بين “web crawler” و“web scraper”. وهما ليسا الشيء نفسه.
اختبرت 10 أدوات زحف مجانية على مواقع حقيقية. بعضها ممتاز لتدقيق SEO، وبعضها أفضل لاستخراج البيانات. إليك ما نجح — وما لم ينجح.
ما هي أداة زحف المواقع؟ فهم الأساسيات
خلّينا نوضّح الأمر من البداية: website crawler ليست هي نفسها web scraper. أعرف أن المصطلحين يُستخدمان أحيانًا بشكل عشوائي، لكنهما مختلفان جذريًا. تخيّل أداة الزحف كأنها رسّام خرائط لموقعك—تتجوّل في كل زاوية وركن، وتتبع كل رابط، وتبني خريطة لجميع صفحاتك. وظيفتها هي الاكتشاف: العثور على الروابط، ورسم بنية الموقع، وفهرسة المحتوى. هذا بالضبط ما تفعله محركات البحث مثل Google عبر روبوتاتها، وما تستخدمه أدوات SEO لفحص صحة الموقع (Thunderbit Blog: What Is a Web Crawler?).
أما web scraper فهو أداة لاستخراج البيانات. لا يهمه شكل الخريطة كاملة—كل ما يريده هو الوصول إلى “الكنز”: أسعار المنتجات، أسماء الشركات، المراجعات، البريد الإلكتروني، وغير ذلك. أدوات الاستخراج تنتزع الحقول المحددة من الصفحات التي تعثر عليها أدوات الزحف (Thunderbit Blog: How to Web Crawl a Site?).
تشبيه سريع:
- Crawler: الشخص الذي يمر في كل ممر داخل متجر البقالة ويحصي جميع المنتجات.
- Scraper: الشخص الذي يروح مباشرة إلى رف القهوة ويكتب سعر كل نوع عضوي.
ليش يهمك هذا الفرق؟ لأنك إذا كنت تريد فقط العثور على جميع صفحات موقعك (مثلًا في تدقيق SEO)، فأنت بحاجة إلى crawler. وإذا كنت تريد سحب أسعار المنتجات من موقع منافس، فأنت بحاجة إلى scraper — أو، والأفضل، أداة تجمع بين الاثنين.
لماذا تستخدم أداة زحف ويب عبر الإنترنت؟ أهم الفوائد للأعمال
طيب، لماذا أصلًا نستخدم web crawler؟ لأن الويب لا يصغر، بل يكبر باستمرار. في الواقع، أكثر من 54% من العلامات التجارية المؤسسية تستخدم منصات زحف مخصصة لتحسين مواقعها، وبعض أدوات SEO تزحف إلى 7 مليارات صفحة يوميًا.
إليك ما يمكن أن تفعله أدوات الزحف لك:
- تدقيق SEO: اكتشاف الروابط المعطلة، والعناوين المفقودة، والمحتوى المكرر، والصفحات اليتيمة، وغير ذلك (SEO.ai).
- فحص الروابط وضمان الجودة: التقاط أخطاء 404 وحلقات التحويل قبل أن يواجهها المستخدمون (Screaming Frog).
- إنشاء Sitemap: توليد خرائط XML تلقائيًا لمحركات البحث وللتخطيط (PowerMapper).
- جرد المحتوى: إعداد قائمة بجميع صفحاتك، وترتيبها الهرمي، وبياناتها الوصفية.
- الامتثال وإمكانية الوصول: التحقق من توافق كل صفحة مع WCAG وSEO والمتطلبات القانونية (SiteOne Crawler).
- الأداء والأمان: رصد الصفحات البطيئة، والصور الكبيرة جدًا، أو مشكلات الأمان (SiteOne Crawler).
- بيانات للذكاء الاصطناعي والتحليل: تغذية البيانات المجمعة إلى أدوات التحليلات أو الذكاء الاصطناعي (Thunderbit Blog: Crawl4AI Review).
إليك جدولًا سريعًا يربط حالات الاستخدام بالأدوار التجارية:
| حالة الاستخدام | الأفضل لـ | الفائدة / النتيجة |
|---|---|---|
| تدقيق SEO والموقع | التسويق، SEO، أصحاب الأعمال الصغيرة | اكتشاف المشكلات التقنية، تحسين البنية، رفع الترتيب |
| جرد المحتوى وضمان الجودة | مدراء المحتوى، مسؤولو المواقع | تدقيق المحتوى أو ترحيله، واكتشاف الروابط/الصور المعطلة |
| توليد العملاء المحتملين (Scraping) | المبيعات، تطوير الأعمال | أتمتة البحث عن العملاء، وتعبئة CRM بعملاء جدد |
| متابعة المنافسين | التجارة الإلكترونية، مدراء المنتجات | مراقبة الأسعار، والمنتجات الجديدة، وتغيرات المخزون |
| استنساخ بنية Sitemap | المطورون، DevOps، المستشارون | نسخ بنية الموقع لإعادة التصميم أو النسخ الاحتياطي |
| تجميع المحتوى | الباحثون، الإعلام، المحللون | جمع البيانات من عدة مواقع للتحليل أو متابعة الاتجاهات |
| أبحاث السوق | المحللون، فرق تدريب الذكاء الاصطناعي | جمع مجموعات بيانات كبيرة للتحليل أو تدريب النماذج |
(Thunderbit Blog: How to Web Crawl a Site?)
كيف اخترنا أفضل أدوات زحف المواقع المجانية
قضيت ليالٍ كثيرة (ومقادير من القهوة أكثر مما أحب الاعتراف به) في استكشاف أدوات الزحف، وقراءة التوثيق، وتشغيل اختبارات فعلية. هذه هي المعايير التي ركزت عليها:
- القدرة التقنية: هل تتعامل مع المواقع الحديثة (JavaScript، تسجيل الدخول، المحتوى الديناميكي)؟
- سهولة الاستخدام: هل تناسب غير التقنيين، أم تحتاج إلى مهارات سطر الأوامر؟
- حدود الخطة المجانية: هل هي مجانية فعلًا، أم مجرد نسخة تجريبية؟
- إمكانية الوصول عبر الإنترنت: هل هي أداة سحابية، تطبيق سطح مكتب، أم مكتبة برمجية؟
- الميزات الفريدة: هل تقدم شيئًا مميزًا—مثل استخراج بالذكاء الاصطناعي، خرائط مرئية للموقع، أو زحفًا يعتمد على الأحداث؟
اختبرت كل أداة، وراجعت آراء المستخدمين، وقارنت الميزات جنبًا إلى جنب. وإذا كانت الأداة تجعلني أرغب في رمي اللابتوب من النافذة، فهي لا تدخل القائمة.
جدول مقارنة سريع: أفضل 10 أدوات زحف مواقع مجانية في لمحة
| الأداة والنوع | الميزات الأساسية | أفضل استخدام | المتطلبات التقنية | تفاصيل الخطة المجانية |
|---|---|---|---|---|
| Bright Data (سحابي/API) | زحف مؤسسي، بروكسيات، عرض JavaScript، حل CAPTCHA | جمع البيانات على نطاق واسع | بعض المهارة التقنية مفيدة | طبقة مجانية: 5,000 سجل/شهر في Web Scraper API، بدون بطاقة |
| Crawlbase (سحابي/API) | زحف عبر API، حماية من البوتات، بروكسيات، عرض JavaScript | المطورون الذين يحتاجون بنية زحف خلفية | دمج API | مجانًا: حتى 20,000 طلب للبدء، بدون بطاقة؛ ثم الدفع لكل طلب |
| ScraperAPI (سحابي/API) | تدوير البروكسيات، عرض JavaScript، زحف غير متزامن، نقاط نهاية جاهزة | المطورون، مراقبة الأسعار، بيانات SEO | إعداد بسيط | مجانًا: 5,000 استدعاء API لمدة 7 أيام، ثم 1,000 شهريًا |
| Diffbot Crawlbot (سحابي) | زحف + استخراج بالذكاء الاصطناعي، Knowledge Graph، عرض JavaScript | بيانات منظمة على نطاق واسع، الذكاء الاصطناعي/التعلم الآلي | دمج API | مجانًا: 10,000 رصيد/شهر لواجهات الاستخراج، أما Crawl فيتطلب خطة Plus |
| Screaming Frog (سطح مكتب) | تدقيق SEO، تحليل الروابط والميتاداتا، Sitemap، استخراج مخصص | تدقيقات SEO، مدراء المواقع | تطبيق سطح مكتب، واجهة رسومية | مجانًا: 500 عنوان URL لكل عملية زحف، مع الميزات الأساسية فقط |
| SiteOne Crawler (سطح مكتب) | SEO، الأداء، إمكانية الوصول، الأمان، تصدير دون اتصال، Markdown | المطورون، QA، الترحيل، التوثيق | سطح مكتب/CLI، واجهة رسومية | مجاني ومفتوح المصدر، 1,000 عنوان URL في تقرير الواجهة (قابل للتكوين) |
| Crawljax (Java، مفتوح المصدر) | زحف يعتمد على الأحداث للمواقع الثقيلة بـ JavaScript، تصدير ثابت | المطورون، QA لتطبيقات الويب الديناميكية | Java، CLI/إعداد | مجاني ومفتوح المصدر، بلا حدود |
| Apache Nutch (Java، مفتوح المصدر) | موزع، قائم على الإضافات، تكامل مع Hadoop، بحث مخصص | محركات البحث المخصصة، الزحف واسع النطاق | Java، سطر الأوامر | مجاني ومفتوح المصدر، والتكلفة فقط للبنية التحتية |
| YaCy (Java، مفتوح المصدر) | زحف وبحث بنظام peer-to-peer، خصوصية، فهرسة ويب/شبكات داخلية | البحث الخاص، اللامركزية | Java، واجهة متصفح | مجاني ومفتوح المصدر، بلا حدود |
| PowerMapper (سطح مكتب/SaaS) | خرائط Sitemap مرئية، إمكانية الوصول، QA، توافق المتصفحات | الوكالات، QA، التخطيط المرئي | واجهة رسومية، سهل الاستخدام | نسخة تجريبية مجانية: 30 يومًا، 100 صفحة (سطح مكتب) أو 10 صفحات (عبر الإنترنت) لكل فحص |
ملاحظة قبل أن تكمل: كلمة “free” في العمود الأخير لا تعني نفس الشيء دائمًا. SiteOne وCrawljax وNutch وYaCy مفتوحة المصدر—مجانية بلا سقف إلا ما يفرضه جهازك. Screaming Frog مجانية دائمًا، لكنها محدودة بـ 500 عنوان URL لكل زحف. أما Bright Data وScraperAPI وDiffbot فتمتلك طبقات مجانية حقيقية لكنها صغيرة، وفي حالة Diffbot فإن أداة الزحف نفسها ليست ضمن الخطة المجانية. Crawlbase تمنحك دفعة أولى مجانية من الطلبات ثم تحاسبك على كل طلب. وPowerMapper هي التجربة المجانية الصافية الوحيدة في القائمة—عند انتهاء 30 يومًا، تحتاج إلى الدفع.
Bright Data: أداة زحف ويب سحابية بمستوى المؤسسات
Bright Data هي “العتاد الثقيل” في عالم زحف الويب. إنها منصة سحابية تضم شبكة بروكسي ضخمة، وعرض JavaScript، وحل CAPTCHA، وIDE لعمليات الزحف المخصصة. إذا كنت تنفذ جمع بيانات على نطاق كبير—مثل مراقبة مئات مواقع التجارة الإلكترونية من أجل الأسعار—فمن الصعب منافسة بنيتها التحتية (aimultiple.com).
نقاط القوة:
- تتعامل مع المواقع الصعبة التي تستخدم حماية ضد البوتات
- قابلة للتوسع لتناسب احتياجات المؤسسات
- قوالب جاهزة لمواقع شائعة
القيود:
- الطبقة المجانية موجودة فعلًا لكنها صغيرة: 5,000 سجل شهريًا في Web Scraper API
- قد تكون مبالغًا فيها للتدقيقات البسيطة
- تحتاج إلى منحنى تعلّم لبعض المستخدمين غير التقنيين
إذا كنت تحتاج إلى زحف الويب على نطاق واسع، فـ Bright Data تشبه استئجار سيارة Formula 1. أما 5,000 سجل شهريًا المجانية فستسمح لك باللفة الأولى فقط؛ وبعدها يبدأ الحساب حسب الاستخدام (Bright Data Pricing).
Crawlbase: أداة زحف ويب مجانية تعتمد على API للمطورين
Crawlbase (المعروفة سابقًا باسم ProxyCrawl) تركّز على الزحف البرمجي. ترسل طلبًا إلى API مع عنوان URL، ثم تعيد HTML مع إدارة البروكسيات، والاستهداف الجغرافي، وCAPTCHA في الخلفية (Capterra).
نقاط القوة:
- معدلات نجاح عالية جدًا (أكثر من 99%)
- تتعامل مع المواقع الثقيلة بـ JavaScript
- ممتازة للدمج داخل تطبيقاتك أو workflows الخاصة بك
القيود:
- تحتاج إلى بعض الدمج عبر API أو SDK
- الخطة المجانية: حتى 20,000 طلب للبدء، بدون بطاقة؛ ثم الدفع لكل طلب
إذا كنت مطورًا تريد الزحف (وربما الاستخراج) على نطاق واسع دون إدارة البروكسيات بنفسك، فـ Crawlbase خيار قوي (Crawlbase Pricing).
ScraperAPI: تبسيط زحف الويب الديناميكي
ScraperAPI هي واجهة “اجلبها لي فقط”. تعطيها عنوان URL، فتتولى البروكسيات، والمتصفحات غير المرئية، وإجراءات مكافحة البوتات، وتعيد لك HTML (أو بيانات منظمة لبعض المواقع). وهي مفيدة جدًا للصفحات الديناميكية، لكن الجزء “المجاني” محدود نسبيًا: 5,000 رصيد API خلال أول 7 أيام بدون بطاقة، ثم 1,000 رصيد شهريًا في الخطة المجانية المستمرة (ScraperAPI Pricing).
نقاط القوة:
- سهلة جدًا للمطورين (مجرد استدعاء API)
- تتعامل مع CAPTCHA، وحظر IP، وJavaScript
- مجانًا: 5,000 استدعاء API لمدة 7 أيام، ثم 1,000 شهريًا
القيود:
- لا توجد تقارير زحف مرئية
- ستحتاج إلى كتابة منطق الزحف بنفسك إذا أردت تتبّع الروابط
إذا كنت تريد دمج زحف الويب في قاعدة الشيفرة الخاصة بك خلال دقائق، فـ ScraperAPI خيار واضح ومباشر.
Diffbot Crawlbot: اكتشاف تلقائي لبنية الموقع
Diffbot Crawlbot هو المكان الذي تصبح فيه الأمور أذكى. فهو لا يزحف فقط—بل يستخدم الذكاء الاصطناعي لتصنيف الصفحات واستخراج البيانات المنظمة (مقالات، منتجات، فعاليات، إلخ) بصيغة JSON. إنه أشبه بمساعد روبوتي يفهم فعلًا ما يقرأه (Diffbot Free Plan).
نقاط القوة:
- استخراج مدعوم بالذكاء الاصطناعي، وليس مجرد زحف
- يتعامل مع JavaScript والمحتوى الديناميكي
- مجانًا: 10,000 رصيد/شهر، بدون بطاقة، وتشمل Extract وNatural Language وKnowledge Graph وSearch
القيود:
- موجه للمطورين (تكامل عبر API)
- ليس أداة SEO مرئية—بل أكثر ملاءمة لمشاريع البيانات
- أما Crawlbot نفسه—الذي يزحف في الموقع بالكامل—فهو ضمن خطة Plus وما فوق؛ بينما تغطي الأرصدة المجانية واجهات الاستخراج فقط (Diffbot Pricing)
إذا كنت تحتاج إلى بيانات منظمة على نطاق واسع، خصوصًا للذكاء الاصطناعي أو التحليلات، فـ Diffbot أداة قوية جدًا.
Screaming Frog: أداة SEO مجانية على سطح المكتب
Screaming Frog هي أداة سطح المكتب الكلاسيكية لتدقيق SEO. تزحف حتى 500 عنوان URL في كل فحص في النسخة المجانية، وتمنحك كل شيء: الروابط المعطلة، وعلامات meta، والمحتوى المكرر، وخرائط الموقع، وغير ذلك (Screaming Frog User Guide).
نقاط القوة:
- سريعة، شاملة، وموثوقة في عالم SEO
- لا تحتاج إلى برمجة—فقط أدخل الرابط وابدأ
- مجانية حتى 500 عنوان URL لكل زحف
القيود:
- على سطح المكتب فقط (لا توجد نسخة سحابية)
- الميزات المتقدمة (عرض JavaScript، والجدولة) تحتاج إلى ترخيص مدفوع
إذا كنت جادًا بشأن SEO، فـ Screaming Frog أداة لا غنى عنها—فقط لا تتوقع أن تزحف مجانًا إلى موقعك المكوّن من 10,000 صفحة.
SiteOne Crawler: تصدير المواقع الثابتة والتوثيق
SiteOne Crawler هو السكين السويسري للتدقيقات التقنية. إنه مفتوح المصدر، ومتعدد المنصات، ويمكنه الزحف والتدقيق وحتى تصدير موقعك إلى Markdown للتوثيق أو للاستخدام دون اتصال (SiteOne Crawler).
نقاط القوة:
- يغطي SEO، والأداء، وإمكانية الوصول، والأمان
- يصدّر المواقع للأرشفة أو الترحيل
- مجاني ومفتوح المصدر، بلا حدود استخدام
القيود:
- أكثر تقنية من بعض الأدوات ذات الواجهة الرسومية
- تقرير التدقيق في الواجهة الرسومية محدود افتراضيًا بـ 1,000 عنوان URL (قابل للتعديل)
إذا كنت مطورًا أو مختص QA أو مستشارًا تريد رؤى عميقة—وتحب المصادر المفتوحة—فـ SiteOne جوهرة غير معروفة كثيرًا.
Crawljax: أداة زحف ويب مفتوحة المصدر بلغة Java للصفحات الديناميكية
Crawljax أداة متخصصة: صُممت للزحف إلى تطبيقات الويب الحديثة الثقيلة بـ JavaScript عبر محاكاة تفاعل المستخدم (النقرات، تعبئة النماذج، إلخ). وهي تعتمد على الأحداث، ويمكنها حتى إخراج نسخة ثابتة من موقع ديناميكي (Wikipedia: Crawljax).
نقاط القوة:
- ممتازة بشكل لا يُضاهى مع تطبيقات SPA والمواقع المعتمدة بكثافة على AJAX
- مفتوحة المصدر وقابلة للتوسعة
- بلا حدود استخدام
القيود:
- تتطلب Java وبعض البرمجة/الإعداد
- غير مناسبة لغير التقنيين
إذا كنت بحاجة إلى الزحف إلى تطبيق React أو Angular كما لو كنت مستخدمًا حقيقيًا، فـ Crawljax صديقك.
Apache Nutch: أداة زحف ويب موزعة وقابلة للتوسع
Apache Nutch هو العجوز المخضرم بين أدوات الزحف مفتوحة المصدر. صُمم لعمليات الزحف الضخمة والموزعة—مثل بناء محرك بحث خاص بك أو فهرسة ملايين الصفحات (Martechvibe).
نقاط القوة:
- يتوسع إلى مليارات الصفحات مع Hadoop
- قابل للتخصيص والتوسعة بدرجة كبيرة
- مجاني ومفتوح المصدر
القيود:
- منحنى تعلّم حاد (Java، سطر أوامر، إعدادات)
- ليس للمواقع الصغيرة أو المستخدمين العاديين
إذا كنت تريد الزحف على نطاق واسع ولا تخشى التعامل مع سطر الأوامر، فـ Nutch هو أداتك.
YaCy: أداة زحف وبحث ويب بنظام الند للند
YaCy هو زاحف ومحرك بحث فريدان من نوعهما، يعتمدان على اللامركزية. كل نسخة تقوم بزحف المواقع وفهرستها، ويمكنك الانضمام إلى شبكة peer-to-peer لمشاركة الفهارس مع الآخرين (TechRadar: YaCy).
نقاط القوة:
- يركز على الخصوصية، بلا خادم مركزي
- ممتاز لبناء بحث خاص أو داخل الشبكات الداخلية
- مجاني ومفتوح المصدر
القيود:
- النتائج تعتمد على تغطية الشبكة
- يحتاج إلى بعض الإعداد (Java، واجهة متصفح)
إذا كنت مهتمًا باللامركزية أو تريد محرك بحث خاصًا بك، فـ YaCy خيار مثير للاهتمام.
PowerMapper: مولد Sitemap مرئي لتجربة المستخدم وضمان الجودة
PowerMapper يركز على تصوير بنية موقعك بشكل مرئي. فهو يزحف إلى موقعك ويولّد خرائط Sitemap تفاعلية، بالإضافة إلى التحقق من إمكانية الوصول، وتوافق المتصفحات، وأساسيات SEO (Slickplan Review).
نقاط القوة:
- خرائط الموقع المرئية رائعة للوكالات والمصممين
- يفحص إمكانية الوصول والامتثال
- واجهة رسومية سهلة، ولا تحتاج إلى مهارات تقنية
القيود:
- مجرد نسخة تجريبية مجانية (30 يومًا، 100 صفحة لسطح المكتب/10 صفحات عبر الإنترنت لكل فحص)
- النسخة الكاملة مدفوعة
إذا كنت بحاجة إلى تقديم خريطة موقع للعميل أو فحص الامتثال، فـ PowerMapper أداة مفيدة جدًا.
اختيار أداة الزحف المجانية المناسبة لاحتياجاتك
مع هذا العدد من الخيارات، كيف تختار؟ إليك دليلي السريع:
- لتدقيق SEO: Screaming Frog (للمواقع الصغيرة)، PowerMapper (للتمثيل المرئي)، SiteOne (للتدقيقات العميقة)
- لتطبيقات الويب الديناميكية: Crawljax
- للبحث المخصص أو واسع النطاق: Apache Nutch، YaCy
- للمطورين الذين يحتاجون إلى API: Crawlbase، ScraperAPI، Diffbot
- للتوثيق أو الأرشفة: SiteOne Crawler
- للاستخدام المؤسسي مع طبقة مجانية صغيرة: Bright Data، Diffbot
العوامل الأساسية التي يجب التفكير فيها:
- القابلية للتوسع: ما حجم موقعك أو مهمة الزحف؟
- سهولة الاستخدام: هل ترتاح للبرمجة أم تريد النقر فقط؟
- تصدير البيانات: هل تحتاج CSV أو JSON أو تكاملًا مع أدوات أخرى؟
- الدعم: هل توجد مجتمع أو مستندات مساعدة إذا واجهتك مشكلة؟
عندما يلتقي زحف الويب باستخراج البيانات: لماذا Thunderbit هو الخيار الأذكى
استخرج البيانات من أي موقع باستخدام الذكاء الاصطناعي قارئ الويب الوكالي من Thunderbit يقرأ أي موقع تحتاج إلى زحفه ويستخرج بيانات منظمة بنقرة واحدة — مجاني لـ 6 صفحات شهريًا. Get Started Free
هذه هي الحقيقة: معظم الناس لا يزحفون إلى المواقع فقط لصنع خرائط جميلة. الهدف الحقيقي غالبًا هو الحصول على بيانات منظمة—سواء كانت قوائم منتجات أو معلومات اتصال أو جرد محتوى. وهنا يأتي دور Thunderbit.
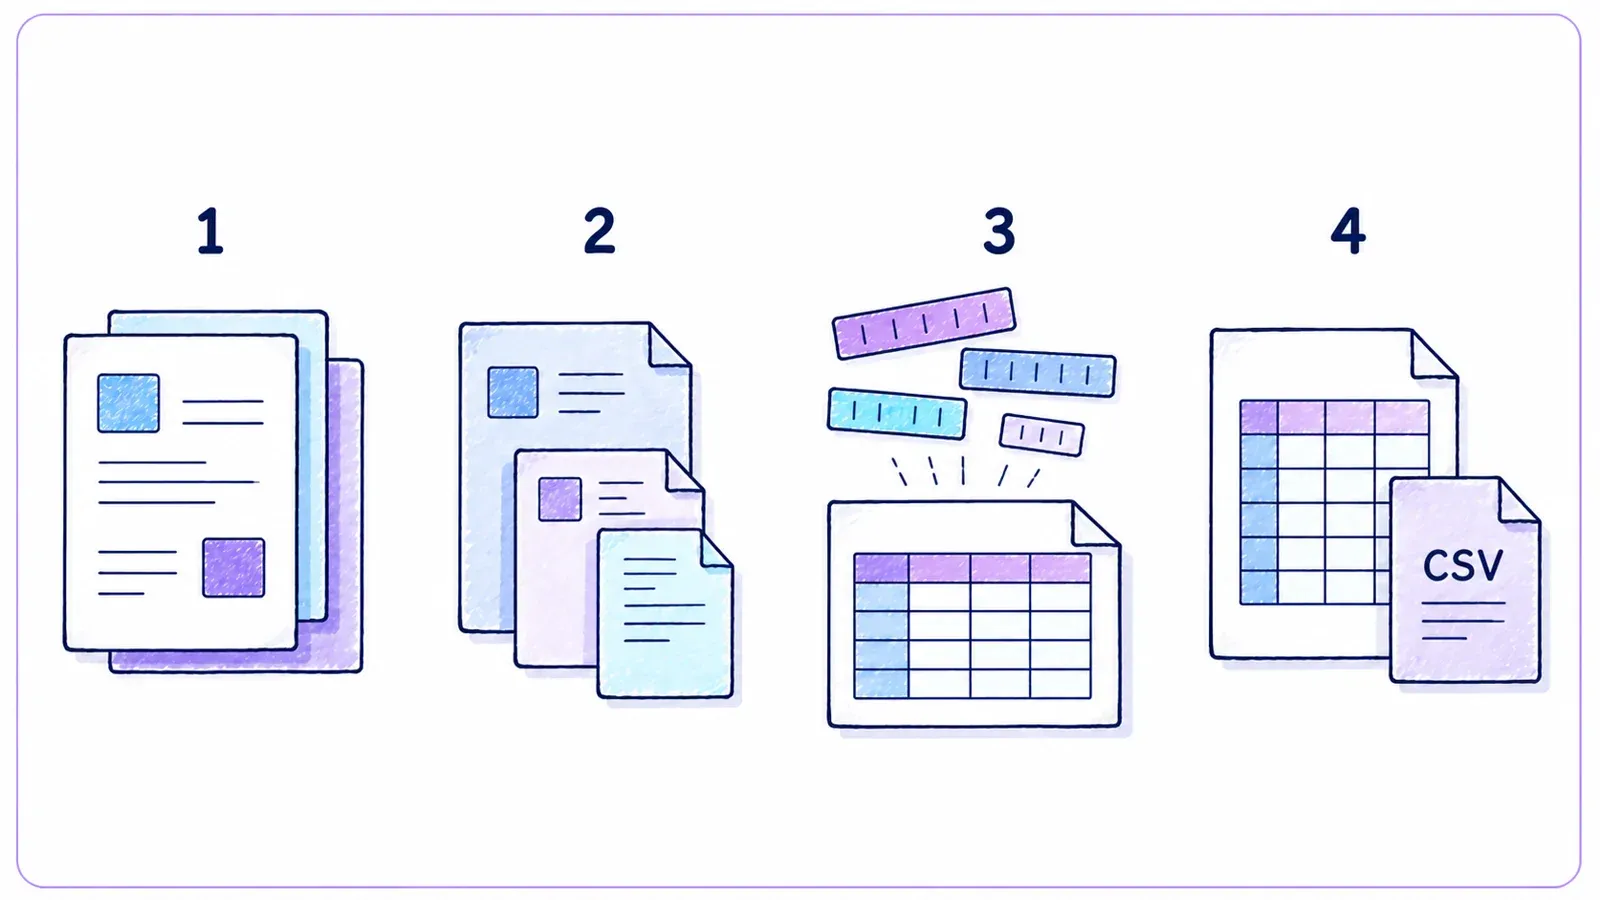
Thunderbit ليس مجرد crawler أو scraper—بل هو إضافة Chrome مدعومة بالذكاء الاصطناعي تجمع بين الاثنين. إليك كيف يعمل:
- AI Crawler: يستكشف Thunderbit الموقع مثل أي crawler.
- Waterfall Crawling: إذا لم يتمكن محرك Thunderbit من جلب الصفحة (ربما بسبب حاجز قوي ضد البوتات)، فإنه ينتقل تلقائيًا إلى خدمات زحف خارجية—من دون أي إعداد يدوي.
- AI Data Structuring: بعد الحصول على HTML، يقترح الذكاء الاصطناعي في Thunderbit الأعمدة المناسبة ويستخرج البيانات المنظمة (الأسماء، الأسعار، الإيميلات، إلخ) دون أن تكتب Selector واحدًا.
- Subpage Scraping: هل تحتاج إلى تفاصيل من كل صفحة منتج؟ يمكن لـ Thunderbit زيارة كل صفحة فرعية تلقائيًا وإغناء الجدول.
- تنظيف البيانات وتصديرها: يمكنه التلخيص، والتصنيف، والترجمة، وتصدير البيانات إلى Excel أو Google Sheets أو Airtable أو Notion بنقرة واحدة.
- سهولة بلا كود: إذا كنت تستطيع استخدام المتصفح، يمكنك استخدام Thunderbit. لا برمجة، لا بروكسيات، لا صداع.
متى تختار Thunderbit بدلًا من crawler تقليدي؟
- عندما يكون هدفك النهائي ملفًا منظمًا ومفيدًا — لا مجرد قائمة روابط.
- عندما تريد أتمتة العملية كاملةً (الزحف، الاستخراج، التنظيف، التصدير) في مكان واحد.
- عندما تقدّر وقتك وراحة بالك.
يمكنك تنزيل إضافة Chrome الخاصة بـ Thunderbit هنا وتجربة السبب الذي يجعل الكثير من المستخدمين في الأعمال ينتقلون إليها.
جرّب Thunderbit مجانًا – قارئ ويب وكالي ثبّت إضافة Chrome المجانية وابدأ في زحف أي موقع بنقرة واحدة، دون الحاجة إلى برمجة. Get Started Free
الخلاصة: الاستفادة القصوى من أدوات زحف المواقع المجانية
شاهد كيف يعمل زحف الويب الوكالي يقرأ Thunderbit الصفحة كما يفعل الإنسان ويقرر ما الذي يجب استخراجه، بدلًا من الإعداد اليدوي لقواعد الزحف. Get Started Free
لقد تطورت أدوات زحف المواقع كثيرًا. سواء كنت مسوقًا، أو مطورًا، أو مجرد شخص يريد الحفاظ على صحة موقعه، فهناك أداة مجانية (أو على الأقل قابلة للتجربة مجانًا) تناسبك. من المنصات المؤسسية مثل Bright Data وDiffbot، إلى الكنوز مفتوحة المصدر مثل SiteOne وCrawljax، وصولًا إلى أدوات الخرائط المرئية مثل PowerMapper، أصبحت الخيارات أكثر تنوعًا من أي وقت مضى.
لكن إذا كنت تبحث عن طريقة أذكى وأكثر تكاملًا للانتقال من “أحتاج هذه البيانات” إلى “إليك جدولي”، فجرب Thunderbit. فهو مصمم لمستخدمي الأعمال الذين يريدون نتائج، لا مجرد تقارير.
هل أنت مستعد للبدء؟ نزّل أداة، شغّل عملية فحص، واكتشف ما كنت تفوّته. وإذا أردت الانتقال من الزحف إلى بيانات قابلة للاستخدام بنقرة واحدة، اطلع على Thunderbit.
لمزيد من التحليلات العميقة والأدلة العملية، زر Thunderbit Blog.
استخرج بيانات المواقع بالذكاء الاصطناعي بنقرة واحدة اضبط Thunderbit ليتابع الصفحات الفرعية ويعمل وفق جدول زمني حتى تبقى عملية الزحف محدثة دون إعادة تشغيل يدوية. Get Started Free
جرّب Agentic Web Scraper Get Started Free
الأسئلة الشائعة
ما الفرق بين website crawler وweb scraper؟
الـ crawler يكتشف جميع صفحات الموقع ويرسمها كخريطة (تخيّل: إنشاء جدول محتويات). أما الـ scraper فيستخرج حقول بيانات محددة (مثل الأسعار أو الإيميلات أو المراجعات) من تلك الصفحات. الـ crawler يبحث، والـ scraper يستخرج (Thunderbit Blog: What Is a Web Crawler?).
ما أفضل أداة زحف ويب مجانية لغير التقنيين؟
للمواقع الصغيرة وتدقيق SEO، Screaming Frog سهلة الاستخدام. وللتمثيل المرئي، PowerMapper ممتازة خلال الفترة التجريبية. أما Thunderbit فهو الأسهل إذا كان هدفك بيانات منظمة وتجربة بلا كود عبر المتصفح.
هل توجد مواقع تحظر أدوات الزحف؟
نعم—بعض المواقع تستخدم ملف robots.txt أو إجراءات مكافحة البوتات مثل CAPTCHA أو حظر IP لمنع الزحف. أدوات مثل ScraperAPI وCrawlbase وThunderbit (مع waterfall crawling) غالبًا تستطيع تجاوز ذلك، لكن احرص دائمًا على الزحف بمسؤولية واحترام قواعد الموقع (Bright Data Pricing).
هل توجد حدود للصفحات أو الميزات في أدوات الزحف المجانية؟
معظمها نعم. مثلًا، النسخة المجانية من Screaming Frog محدودة بـ 500 عنوان URL لكل زحف؛ ونسخة PowerMapper التجريبية بـ 100 صفحة. الأدوات المعتمدة على API غالبًا لها حدود رصيد شهرية. أما الأدوات مفتوحة المصدر مثل SiteOne أو Crawljax فعادةً لا تفرض حدودًا صارمة، لكنك تبقى مقيدًا بقدرات جهازك.
هل استخدام web crawler قانوني ومتوافق مع الخصوصية؟
بشكل عام، زحف الصفحات العامة قانوني، لكن تحقق دائمًا من شروط الخدمة وملف robots.txt الخاص بالموقع. لا تزحف أبدًا إلى بيانات خاصة أو محمية بكلمة مرور دون إذن، وانتبه لقوانين الخصوصية إذا كنت تستخرج بيانات شخصية (Crawlbase Guide).



