
TikTok má dnes zhruba 1,9 miliardy měsíčně aktivních uživatelů a tvůrci nahrávají odhadem 23 milionů videí denně. Pokud jste se někdy pokusili vytáhnout data třeba jen z malé části tohohle proudu, víte, jaká je to makačka.
Většinou to vypadá asi takhle: do Googlu zadáte „Scrape Tiktok python“, zkopírujete ukázku z nějakého tutoriálu (nebo si necháte kód napsat ChatGPT), spustíte ho a dostanete… nic. Prázdné HTML. Chybu 403. Nebo obávané „Process finished with exit code 0“ bez jediného výstupu. Tuhle smyčku jsem viděl v desítkách GitHub issues i diskuzí na Redditu, a právě proto vznikl tenhle návod. Projdeme si tři pythonové metody, které v roce 2025 opravdu fungují, kompletní postup pro stahování samotných souborů .mp4 (ne jen metadat — u toho většina ostatních návodů končí) a taky srovnávací tabulku, abyste si vybrali správný přístup pro svůj případ. Pokud Python vůbec nepotřebujete, ukážu i no-code alternativy, jako je Thunderbit, se kterými získáte stejná data zhruba na dvě kliknutí.
Co vlastně znamená „stahovat videa z TikToku“?
Než se pustíme do kódu, je dobré si ujasnit, co lidé myslí výrazem „scrape TikTok videos“ — protože tenhle pojem zahrnuje dvě dost odlišné věci:
- Extrahování metadat videa: popisky, hashtagy, počet lajků, komentářů, sdílení, zhlédnutí, datum publikace, informace o autorovi. Na to se zaměřuje většina tutoriálů.
- Stahování samotných videí (.mp4): získání video souboru a uložení do počítače. To je to, co většina lidí opravdu chce, když zadá „scrape TikTok videos“ — a právě to bývá skoro vždy opomenuto.
Tenhle průvodce pokrývá obojí. Každá metoda níže umí vytáhnout metadata a zároveň vám dá i odkazy potřebné ke stažení .mp4 souborů.
Proč stahovat videa z TikToku pomocí Pythonu?
Při cca 280 videích zhlédnutých na uživatele denně a s tím, že TikTok Shop generuje více než 33 miliard dolarů globálních reklamních tržeb, jsou obchodní důvody pro práci s daty z TikToku úplně zásadní. Nejčastěji vídám tyhle scénáře:
| Případ použití | Co získáte | Pro koho je to vhodné |
|---|---|---|
| Výzkum influencerů a marketingu | Míra zapojení, počty sledujících, formáty obsahu, výkon hashtagů | Marketingové týmy, agentury |
| Obsahová strategie | Trendující hashtagy, virální formáty videí, frekvence publikování | Tvůrci obsahu, správci sociálních sítí |
| Monitoring značky | Zmínky, dosah kampaní, sentiment publika | Brand manažeři, PR týmy |
| Analýza konkurence | Výkon videí konkurence, reklamní kreativita, nabídky v TikTok Shopu | E-commerce, produktové týmy |
| Průzkum trhu | Nové trendy, chování publika, objevování produktů | Analytici, hedge fondy, výzkumné firmy |
| Archivace a compliance | Video soubory pro interní kontrolu nebo záznamy | Právní oddělení, compliance, agentury |
Obchodní dopad je reálný: příjmy z reklamy na TikToku v USA mají v roce 2026 dosáhnout 23,4 miliardy dolarů a affiliate tvůrci generují 82–84 % příjmů v top kategoriích TikTok Shopu. Pokud působíte v e-commerce nebo influencer marketingu, mají tahle data přímou finanční hodnotu.
Proč váš základní Python kód na TikToku selhává
Pokud jste už zkusili něco podobného a nikam to nevedlo, nejste sami:
import requests
from bs4 import BeautifulSoup

resp = requests.get("https://www.tiktok.com/@someuser")
soup = BeautifulSoup(resp.text, "html.parser")
# ...a pak v HTML není nic užitečného
Důvod je jednoduchý: TikTok patří mezi nejobtížněji scrapované platformy. Běžný requests.get() vrátí většinou prázdnou HTML kostru, protože skutečný obsah se vykresluje v prohlížeči přes JavaScript. Navíc TikTok nasazuje agresivní anti-bot ochranu, která zahrnuje behaviorální detekci, TLS fingerprinting, vlastní JavaScriptový virtuální stroj pro generování podpisů požadavků a dynamické CSS selektory, které se bez varování mění.
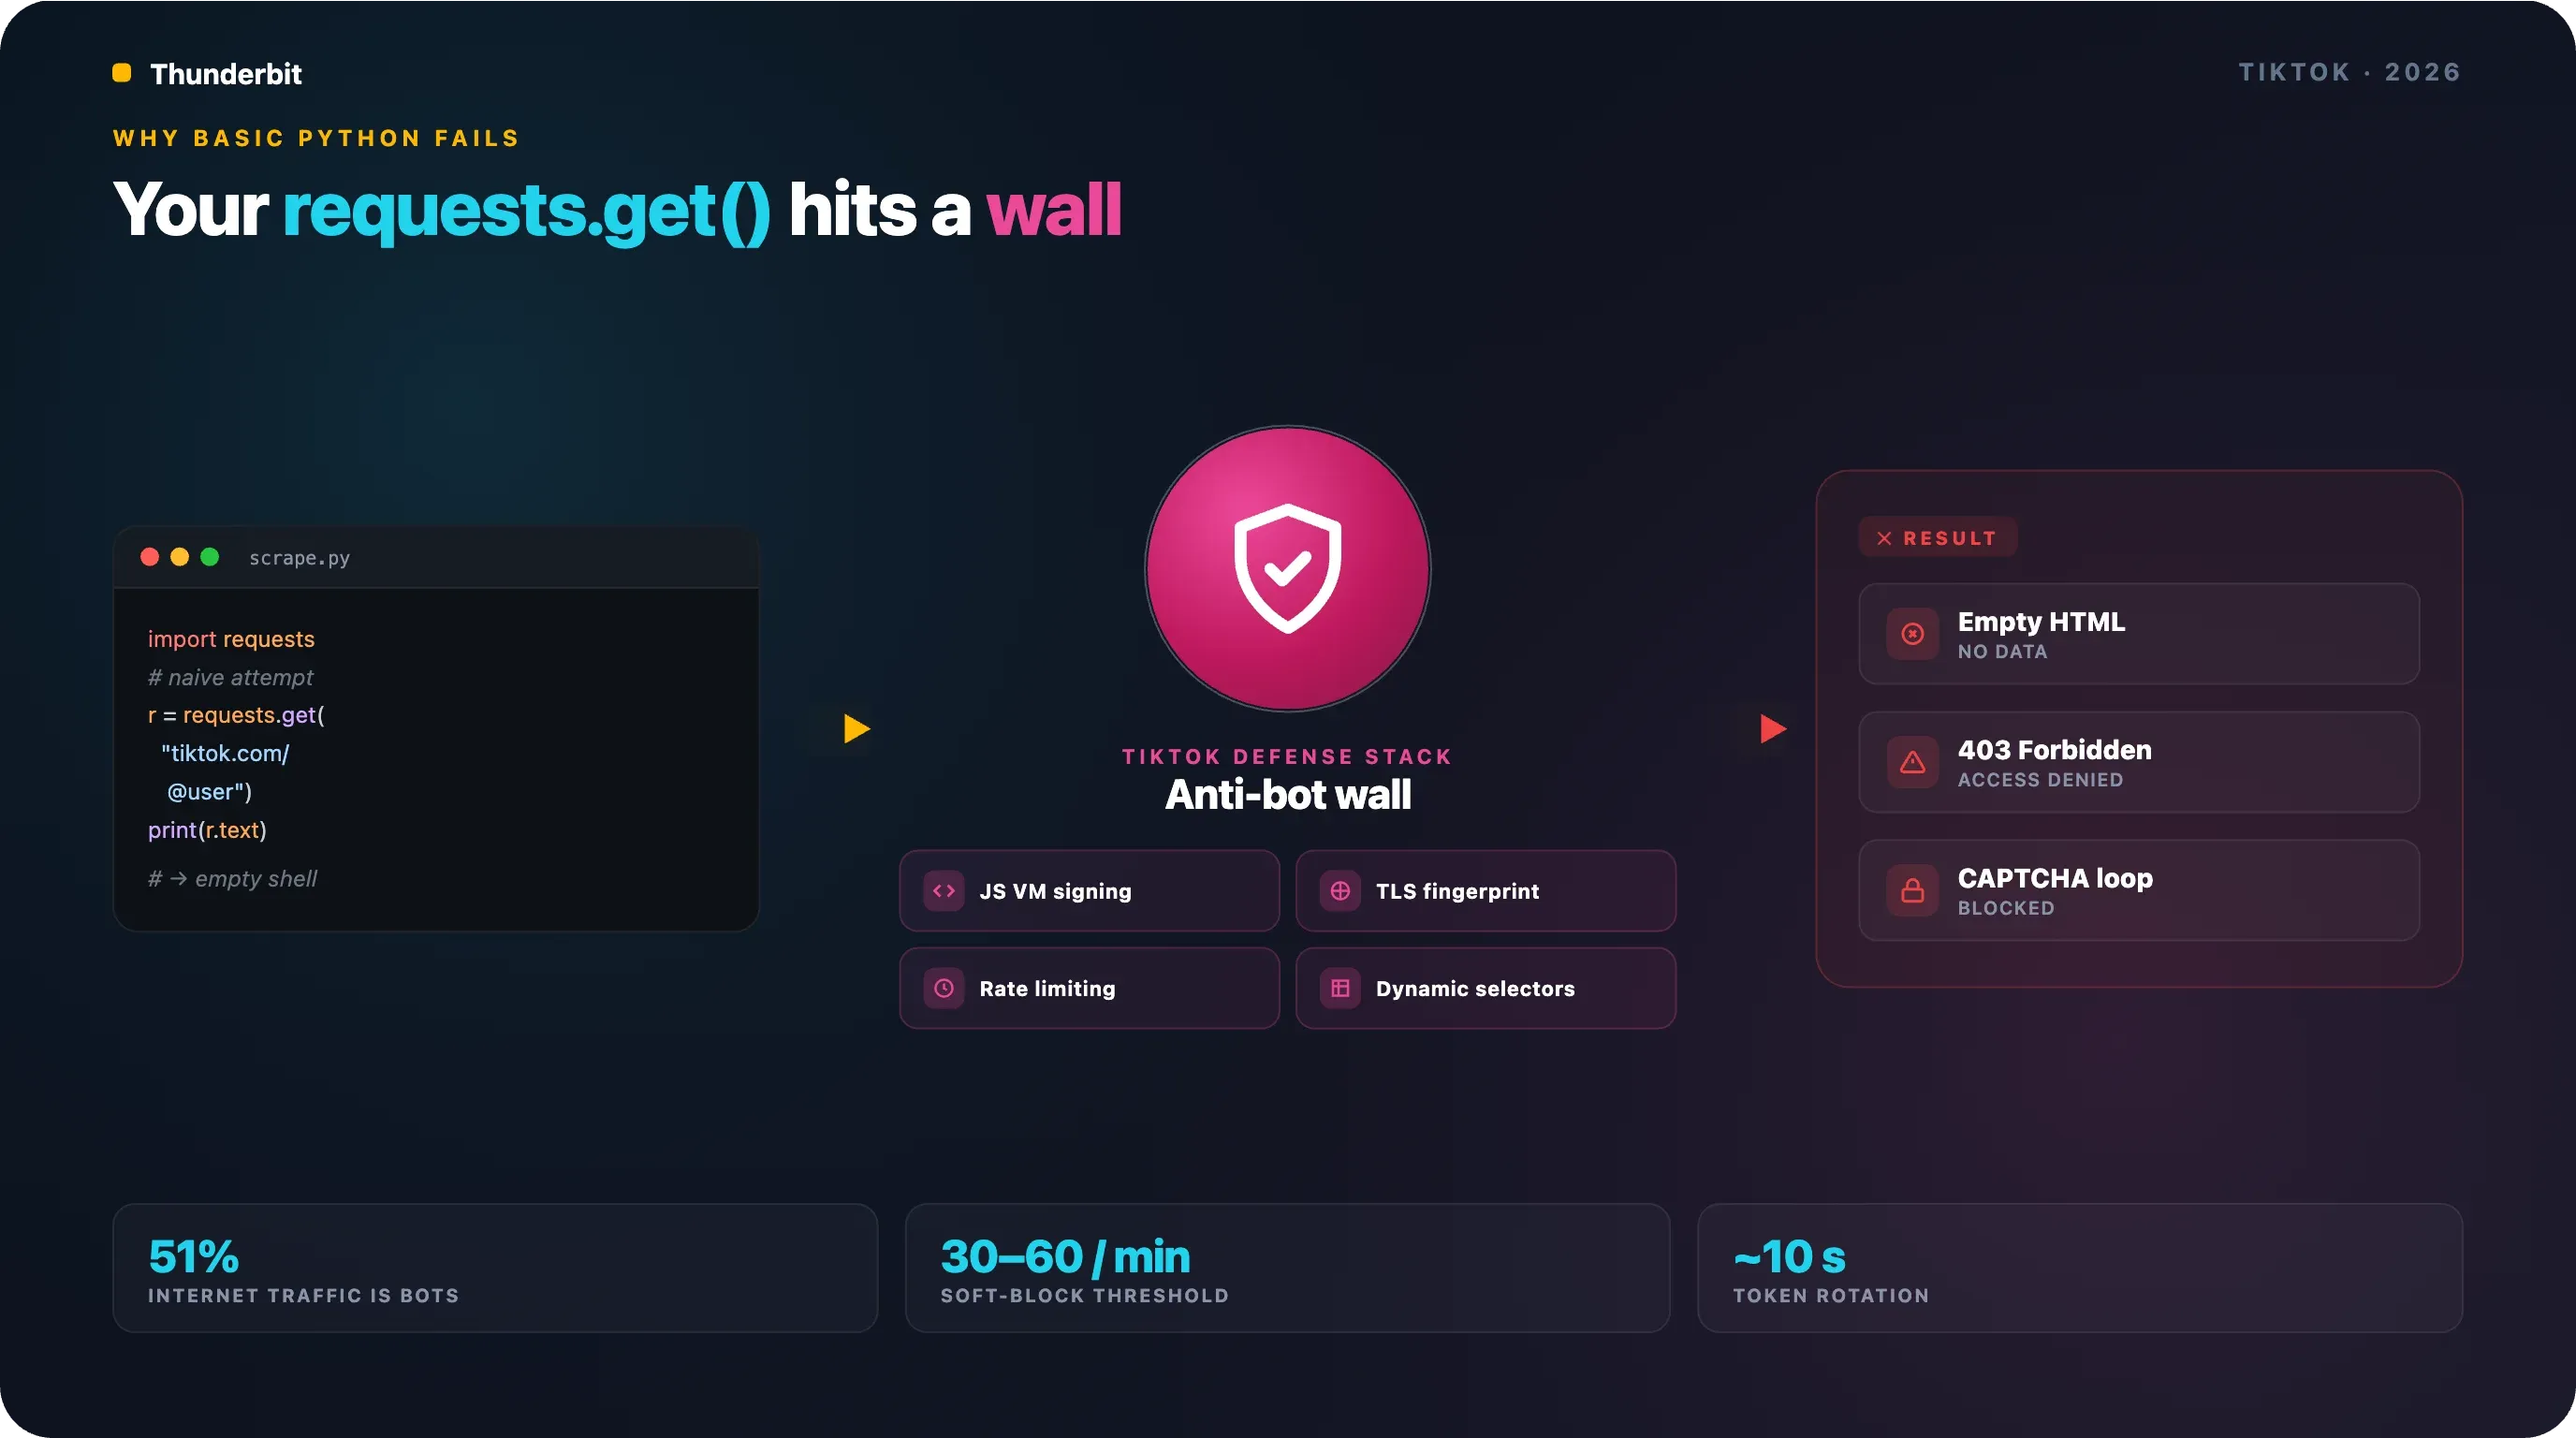
Podle Imperva 2025 Bad Bot Report v roce 2024 poprvé překonal automatizovaný provoz lidský — boti dnes tvoří 51 % veškerého internetového provozu. TikTok si toho je dobře vědomý a svoje obrany tomu přizpůsobil.
Tady je rychlá diagnostická tabulka, abyste zjistili, co se pokazilo, a hned přeskočili na správnou metodu:
| Příznak | Pravděpodobná příčina | Metoda, která to řeší |
|---|---|---|
| Prázdné HTML / žádná data | Obsah vykreslený přes JS; requests neumí spustit JavaScript | Metoda 1 (skryté JSON) nebo Metoda 3 (Playwright) |
| 403 / Access Denied | Chybějící nebo špatné hlavičky; anti-bot detekce | Metoda 1 s korektními hlavičkami |
| Data fungují jednou a pak přestanou | Rate limiting / blokace IP | Rotace proxy (všechny metody) |
| Objeví se login wall | Požadavek na session/cookies | Metoda 3 (prohlížeč s uloženou session) |
| Kód vygenerovaný ChatGPT nic nevrací | Struktura TikToku se od trénovacího data modelu změnila | Všechny 3 metody (aktuální postupy) |
Limit pro rate limiting je přibližně 30–60 požadavků za minutu na jednu IP, než začnete narážet na soft bloky nebo CAPTCHA. Datacentrové IP adresy bývají označeny během několika minut — pro jakýkoli větší objem jsou prakticky nutné rezidenční nebo mobilní proxy.
Přehled: 3 metody, jak pomocí Pythonu získat videa z TikToku
Tady je plán. Každá metoda má jiné plusy a mínusy a všechny tři projdeme s funkčním kódem:
- Extrahování skrytého JSON — zpracujete tag
scripts__UNIVERSAL_DATA_FOR_REHYDRATION__, který je vložený do stránek TikToku. Nejrychlejší, nejjednodušší, bez potřeby prohlížeče. - Interní API TikToku — přímo voláte nezdokumentovaný endpoint
/api/post/item_list/pro hromadná data s cursor-based stránkováním. - Automatizace prohlížeče pomocí Playwrightu — vykreslení stránky v headless prohlížeči pro práci s nekonečným scrollováním, dynamickým obsahem a login wall.
Všechny tři metody lze použít i ke stažení samotných .mp4 videí — tomu se věnuji v samostatné sekci po jednotlivých postupech. Na konci je kompletní srovnávací tabulka, abyste se mohli rozhodnout informovaně.
Metoda 1: Scrape TikTok videí pomocí skrytého JSON (vhodné pro začátečníky)
Tohle je přístup, se kterým doporučuji začít. TikTok vkládá do prakticky každé načítané stránky obrovský JSON blob do tagu <script> s ID __UNIVERSAL_DATA_FOR_REHYDRATION__. Ten obsahuje všechna profilová i video data, která by jinak vykresloval front-endový JavaScript — takže je můžete získat jediným HTTP požadavkem, bez browseru.
Co budete potřebovat
- Python 3.8+
requests(nebohttpx)beautifulsoup4(neboparsel)- Správné hlavičky:
User-Agent,Referer,Accept-Language
Nainstalujte závislosti:
pip install requests beautifulsoup4
Krok za krokem: získání video dat z TikToku ze script tagu
Krok 1: Odešlete GET požadavek s realistickými hlavičkami prohlížeče.
Tady většina začátečníků skončí. Pokud pošlete holý requests.get() bez hlaviček, TikTok vrátí 403 nebo stránku s CAPTCHA. Minimálně potřebujete aktuální browserový User-Agent a hlavičku Referer.
import requests
from bs4 import BeautifulSoup
import json

url = "https://www.tiktok.com/@charlidamelio"
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/124.0.0.0 Safari/537.36",
    "Referer": "https://www.tiktok.com/",
    "Accept-Language": "en-US,en;q=0.9",
}

resp = requests.get(url, headers=headers)
Krok 2: Načtěte HTML a najděte hydration script tag.
soup = BeautifulSoup(resp.text, "html.parser")
script_tag = soup.find("script", id="__UNIVERSAL_DATA_FOR_REHYDRATION__")
Pokud je script_tag None, TikTok vás pravděpodobně zablokoval (zkontrolujte stavový kód), nebo změnil ID tagu (vzácné, ale možné).
Krok 3: Načtěte obsah scriptu jako JSON.
data = json.loads(script_tag.string)
Krok 4: Projděte strukturu JSON a vytáhněte metadata videí.
Struktura je zanořená pod __DEFAULT_SCOPE__. U stránky profilu uživatele:
user_detail = data["__DEFAULT_SCOPE__"]["webapp.user-detail"]
user_info = user_detail["userInfo"]

# Statistiky profilu
stats = user_info["stats"]
print(f"Followers: {stats['followerCount']}, Likes: {stats['heartCount']}")

# Seznam videí (první stránka videí)
item_list = user_detail.get("itemList", [])
for video in item_list:
    print(video["desc"])  # Popisek
    print(video["stats"]["playCount"])  # Zhlédnutí
    print(video["video"]["playAddr"])  # Odkaz ke stažení videa (bez vodoznaku)
    print(video["video"]["downloadAddr"])  # Odkaz ke stažení videa (s vodoznakem)
Krok 5: Získejte odkazy pro stažení videa.
Pole playAddr obvykle poskytuje čistší verzi videa (často bez vodoznaku TikToku), zatímco downloadAddr obsahuje standardní watermark. Oba jsou přímé odkazy na .mp4 soubor — ke stažení ale potřebují správné hlavičky (to řeší sekce o stahování níže).
Teď byste měli mít seznam objektů s metadaty videí, z nichž každý obsahuje popisek, statistiky, čas vytvoření, hashtagy (v challenges[] a textExtra) a přímé URL videa.
Omezení metody skrytého JSON
- Získá data jen z prvního načtení stránky — obvykle prvních ~30 videí na profilu
- Neumí nekonečný scroll ani stránkování (není tu „další stránka“, kterou by šlo požádat)
- Pokud TikTok změní ID script tagu nebo strukturu JSON, parser se rozbije (to se občas stává — Pydantic validation pomůže chyby zachytit dřív)
- Nejlepší pro: rychlé scrape profilu, jednorázové stažení dat nebo situace, kdy potřebujete jen nejnovější videa
Metoda 2: Scrape TikTok videí přes interní API
Front-end TikToku nenačítá všechna videa najednou — při scrollování posílá XHR volání na interní API endpointy. Hlavní endpoint pro uživatelská videa je /api/post/item_list/. Můžete ho volat přímo z Pythonu, což vám dá cursor-based stránkování a přístup ke všem videím na profilu, ne jen na první stránce.
Jak najít interní API endpoint
Otevřete Chrome DevTools na profilu TikToku, přejděte na záložku Network, filtrujte XHR a scrollujte dolů. Uvidíte požadavky na URL typu:
https://www.tiktok.com/api/post/item_list/?WebIdLastTime=...&aid=1988&count=35&cursor=0&secUid=...
Klíčové parametry jsou:
secUid— unikátní ID profilu (získáte ho z JSON z metody 1, vuserInfo.user.secUid)cursor— offset stránkování (začíná na0, každá odpověď vrací další hodnotu cursoru)count— počet položek na stránku (typicky 30–35)
Krok za krokem: dotazování interního API TikToku v Pythonu
Krok 1: Získejte secUid cílového profilu.
Můžete ho vytáhnout ze skrytého JSON (metoda 1) nebo z HTML stránky profilu.
Krok 2: Sestavte a odešlete API požadavek.
import requests
import json

sec_uid = "MS4wLjABAAAA..."  # Z metody 1
api_url = "https://www.tiktok.com/api/post/item_list/"
params = {
    "aid": "1988",
    "secUid": sec_uid,
    "count": 35,
    "cursor": 0,
}
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64; Gecko) Chrome/124.0.0.0 Safari/537.36",
    "Referer": "https://www.tiktok.com/",
}

resp = requests.get(api_url, params=params, headers=headers)
data = resp.json()
Krok 3: Zpracujte odpověď.
Každá položka v data["itemList"] obsahuje stejnou strukturu videa jako metoda 1 — desc, stats, video.playAddr, video.downloadAddr atd.
Krok 4: Procházejte všechna videa stránkováním.
all_videos = []
cursor = 0
has_more = True

while has_more:
    params["cursor"] = cursor
    resp = requests.get(api_url, params=params, headers=headers)
    data = resp.json()

    items = data.get("itemList", [])
    all_videos.extend(items)

    has_more = data.get("hasMore", False)
    cursor = data.get("cursor", 0)

    print(f"Staženo {len(items)} videí, celkem: {len(all_videos)}, hasMore: {has_more}")

print(f"Celkem stažených videí: {len(all_videos)}")
Každá iterace vrátí další dávku a nový cursor. Smyčka pokračuje, dokud hasMore není False.
Omezení metody interního API
- TikTok tyto endpointy i potřebné parametry mění velmi často — jde o nejnáročnější metodu na údržbu. V posledních měsících některé požadavky začaly vyžadovat
msToken,X-Bogusnebo jiné signatury, které generuje TikTokův vlastní JavaScript VM (spoiler: napodobit to čistě v Pythonu není triviální). - U některých typů dat mohou být potřeba session cookies nebo další tokeny
- Stále platí IP-based rate limiting — doporučuje se rotace proxy
- Pokud začnou chodit prázdná pole
itemList, vášmsTokenje nejspíš starý (v prohlížeči se obměňuje přibližně každých 10 sekund) - Nejlepší pro: hromadné získávání dat, když potřebujete všechna videa z profilu a omezení první stránky z metody 1 vám nestačí
Metoda 3: Scrape TikTok videí s Playwrightem (automatizace prohlížeče)
Když první dvě metody narazí na limity — login požadavky, CAPTCHA nebo signature parametry, které neumíte napodobit — přichází na řadu Playwright. Spustí skutečný (headless) prohlížeč, otevře TikTok jako běžný uživatel a zvládne renderování JavaScriptem, nekonečný scroll i autentizovanou session.
Nastavení Playwrightu pro scraping TikToku
Nainstalujte Playwright i jeho browser binaries:
pip install playwright
playwright install firefox
Pro scraping TikToku doporučuji Firefox před Chromiumem. Testy komunity opakovaně ukazují lepší kompatibilitu fingerprintu u Firefoxu a detekce botů na TikToku je proti headless browserům založeným na Chromiu obzvlášť agresivní.
Pro vyšší úroveň stealth zvažte kombinaci Playwrightu s patchright (upravený fork Playwrightu) nebo Camoufox (Firefox upravený na úrovni C++ kvůli anti-detekci). V nezávislých benchmarcích dosahuje Camoufox téměř perfektních stealth výsledků proti hlavním službám pro detekci botů.
Krok za krokem: scraping profilových videí z TikToku pomocí Playwrightu
Krok 1: Spusťte headless Firefox a otevřete profil.
import asyncio
from playwright.async_api import async_playwright
import json

async def scrape_tiktok_profile(username):
    async with async_playwright() as p:
        browser = await p.firefox.launch(headless=True)
        context = await browser.new_context(
            user_agent="Mozilla/5.0 (Windows NT 10.0; Win64; x64; rv:124.0) Gecko/20100101 Firefox/124.0",
            viewport={"width": 1280, "height": 720},
        )
        page = await context.new_page()

        await page.goto(f"https://www.tiktok.com/@{username}", wait_until="networkidle")
Krok 2: Počkejte, až se načte mřížka videí.
        # Počkejte, až se objeví položky videí
        await page.wait_for_selector('[data-e2e="user-post-item"]', timeout=15000)
Pokud TikTok zobrazí overlay „Something went wrong“, možná budete muset kliknout na tlačítko retry:
        retry_btn = page.locator('button:has-text("Retry")')
        if await retry_btn.count() > 0:
            await retry_btn.click()
            await page.wait_for_selector('[data-e2e="user-post-item"]', timeout=15000)
Krok 3: Získejte data ze skrytého JSONu (i v Playwrightu).
Nejspolehlivější přístup je pořád vytáhnout hydration JSON, i když používáte prohlížeč:
        script_el = page.locator("#__UNIVERSAL_DATA_FOR_REHYDRATION__")
        raw_json = await script_el.inner_text()
        data = json.loads(raw_json)

        # Stejná navigace JSON jako u metody 1
        user_detail = data["__DEFAULT_SCOPE__"]["webapp.user-detail"]
        videos = user_detail.get("itemList", [])
Krok 4: Ošetřete nekonečný scroll pro další videa.
Pokud potřebujete víc než prvních ~30 videí, scrollujte dolů a zachyťte další XHR odpovědi:
        all_videos = list(videos)

        # Zachyťte API odpovědi při scrollování
        api_responses = []

        async def capture_response(response):
            if "/api/post/item_list" in response.url:
                try:
                    body = await response.json()
                    api_responses.append(body)
                except:
                    pass

        page.on("response", capture_response)

        # Scroll dolů a vyvolejte další načítání
        for _ in range(5):  # Upravte počet scrollů podle potřeby
            await page.evaluate("window.scrollTo(0, document.body.scrollHeight)")
            await asyncio.sleep(2)

        # Sbírejte videa ze zachycených odpovědí
        for api_resp in api_responses:
            items = api_resp.get("itemList", [])
            all_videos.extend(items)

        print(f"Celkem videí: {len(all_videos)}")
        await browser.close()
        return all_videos

# Spuštění
videos = asyncio.run(scrape_tiktok_profile("charlidamelio"))
Teď byste měli mít seznam video objektů z prvního načtení stránky i z dalších stránek načtených scrollováním.
Omezení metody Playwright
- Zdaleka nejpomalejší metoda (plné renderování stránky, síťové round-trip, prodlevy při scrollování)
- Vyšší nároky na zdroje — každá instance prohlížeče spotřebuje dost paměti i CPU
- I tak podléhá IP blokování ve větším měřítku — kombinujte s rotací proxy
- Nejlepší pro: složité interakce, obsah za login wall, zvládání CAPTCHA nebo situace, kdy Metody 1 a 2 nefungují
Jak pomocí Pythonu stáhnout TikTok videa (.mp4)
Tohle je sekce, která vyplňuje největší mezeru ve většině ostatních tutoriálů o TikToku. Získání metadat je užitečné, ale většina lidí, kteří hledají „scrape TikTok videos“, chce skutečné video soubory.
TikTok vkládá do dat videa odkazy ke stažení:
playAddr— obvykle verze bez vodoznaku nebo s minimálním vodoznakemdownloadAddr— verze určená pro stažení v aplikaci, která obsahuje TikTok watermark
Obě URL jsou časově omezené a po krátké době expirují (obvykle během několika hodin), takže videa je potřeba stáhnout hned po získání odkazu.
Krok za krokem: stažení video souboru z TikToku
Krok 1: Získejte URL videa jednou z výše uvedených metod.
video_url = video["video"]["playAddr"]  # Verze bez vodoznaku
# nebo
video_url = video["video"]["downloadAddr"]  # S vodoznakem
Krok 2: Odešlete GET požadavek se správnými hlavičkami.
To je krok, na kterém se lidé často zaseknou. Když uděláte jen requests.get(video_url), dostanete 403. TikTok kontroluje hlavičku Referer a očekává browserový User-Agent.
import requests

headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/124.0.0.0 Safari/537.36",
    "Referer": "https://www.tiktok.com/",
}

resp = requests.get(video_url, headers=headers, stream=True)
Krok 3: Uložte obsah odpovědi jako soubor .mp4.
Použijte stream=True a zapisujte po částech — TikTok videa mohou být velká a není dobré je načítat celá do paměti:
video_id = video["id"]
filename = f"tiktok_{video_id}.mp4"

with open(filename, "wb") as f:
    for chunk in resp.iter_content(chunk_size=1024 * 1024):  # 1MB bloky
        if chunk:
            f.write(chunk)

print(f"Staženo: {filename}")
Teď byste měli mít na lokálním disku přehratelný soubor .mp4.
Vodoznak vs. verze bez vodoznaku
TikTok ukládá u každého videa jak verzi s watermarkem, tak i bez něj. URL playAddr často poskytuje čistší verzi (tu, kterou používá přehrávač), zatímco downloadAddr obsahuje TikTok watermark s uživatelským jménem autora.
Krátká poznámka k etice: watermark slouží k uvedení autora. Pokud video stahujete pro výzkum, analýzu nebo interní kontrolu, použití playAddr je obvykle v pořádku. Pokud obsah dál šíříte nebo znovu zveřejňujete, odstranění uvedení autora otevírá etické i autorskoprávní otázky. Více k tomu v právní části níže.
Pro robustnější pipeline pro stahování zvažte yt-dlp — jeho TikTok extractor automaticky řeší výpočet signatur a rozlišení URL, takže nemusíte sami spravovat hlavičky a expiraci tokenů.
Srovnání vedle sebe: kterou pythonovou metodu zvolit?
Tady je srovnávací tabulka, kterou bych si sám přál mít, když jsem s TikTok scrapingem začínal:
| Kritérium | Metoda 1: Skryté JSON | Metoda 2: Interní API | Metoda 3: Playwright |
|---|---|---|---|
| Obtížnost | Začátečník | Středně pokročilý | Středně pokročilý |
| Rychlost | Rychlá (1 požadavek na stránku) | Rychlá (JSON API) | Pomalá (plné renderování stránky) |
| Odolnost proti botům | Střední | Nízká (endpointy se mění) | Vysoká (napodobuje reálný browser) |
| Umí stáhnout .mp4 videa? | Ano (vytáhne playAddr) | Ano (URL je v odpovědi) | Ano (zachycením sítě) |
| Zvládá nekonečný scroll | Ne (jen první stránka) | Ano (cursor pagination) | Ano (simulace scrollu) |
| Proxy potřeba ve větším měřítku | Ano | Ano | Ano |
| Nároky na údržbu | Střední (mění se struktura JSON) | Vysoké (endpointy/signatury se mění často) | Nízké až střední (prohlížeč se přizpůsobí) |
| Nejlepší pro | Rychlé jednorázové scrapování profilu | Hromadné získávání dat, všechna videa | Obsah za login wall nebo složitý obsah |
Moje doporučení:
- Potřebujete jen rychlý snímek jednoho profilu? Začněte metodou 1. Nastavení zabere asi 30 sekund a data vrátí za méně než sekundu na stránku.
- Potřebujete všechna videa z profilu včetně stránkování? Hodí se metoda 2, ale počítejte s údržbou, jakmile TikTok změní API parametry.
- Řešíte login wall, CAPTCHA nebo chcete co nejvyšší odolnost? Zvolte metodu 3 s Playwrightem. Je pomalejší a náročnější, ale TikToku se blokuje nejhůř.
V praxi často začínám metodou 1 a teprve pak přecházím na metodu 2 nebo 3, když narazím na limity. Infrastruktura zůstane jednodušší a náklady nižší.
Nepotřebujete Python? Stahujte TikTok videa pomocí no-code nástrojů
Spousta lidí, kteří hledají „scrape TikTok videos with Python“, ve skutečnosti Python vůbec nepotřebuje. Potřebují data. Pokud jste marketingový analytik a chcete metadata videí z pár konkurenčních profilů, nebo brand manažer, který sleduje zmínky, je nastavování Python prostředí s rotací proxy a řešením signatur zbytečně složité.
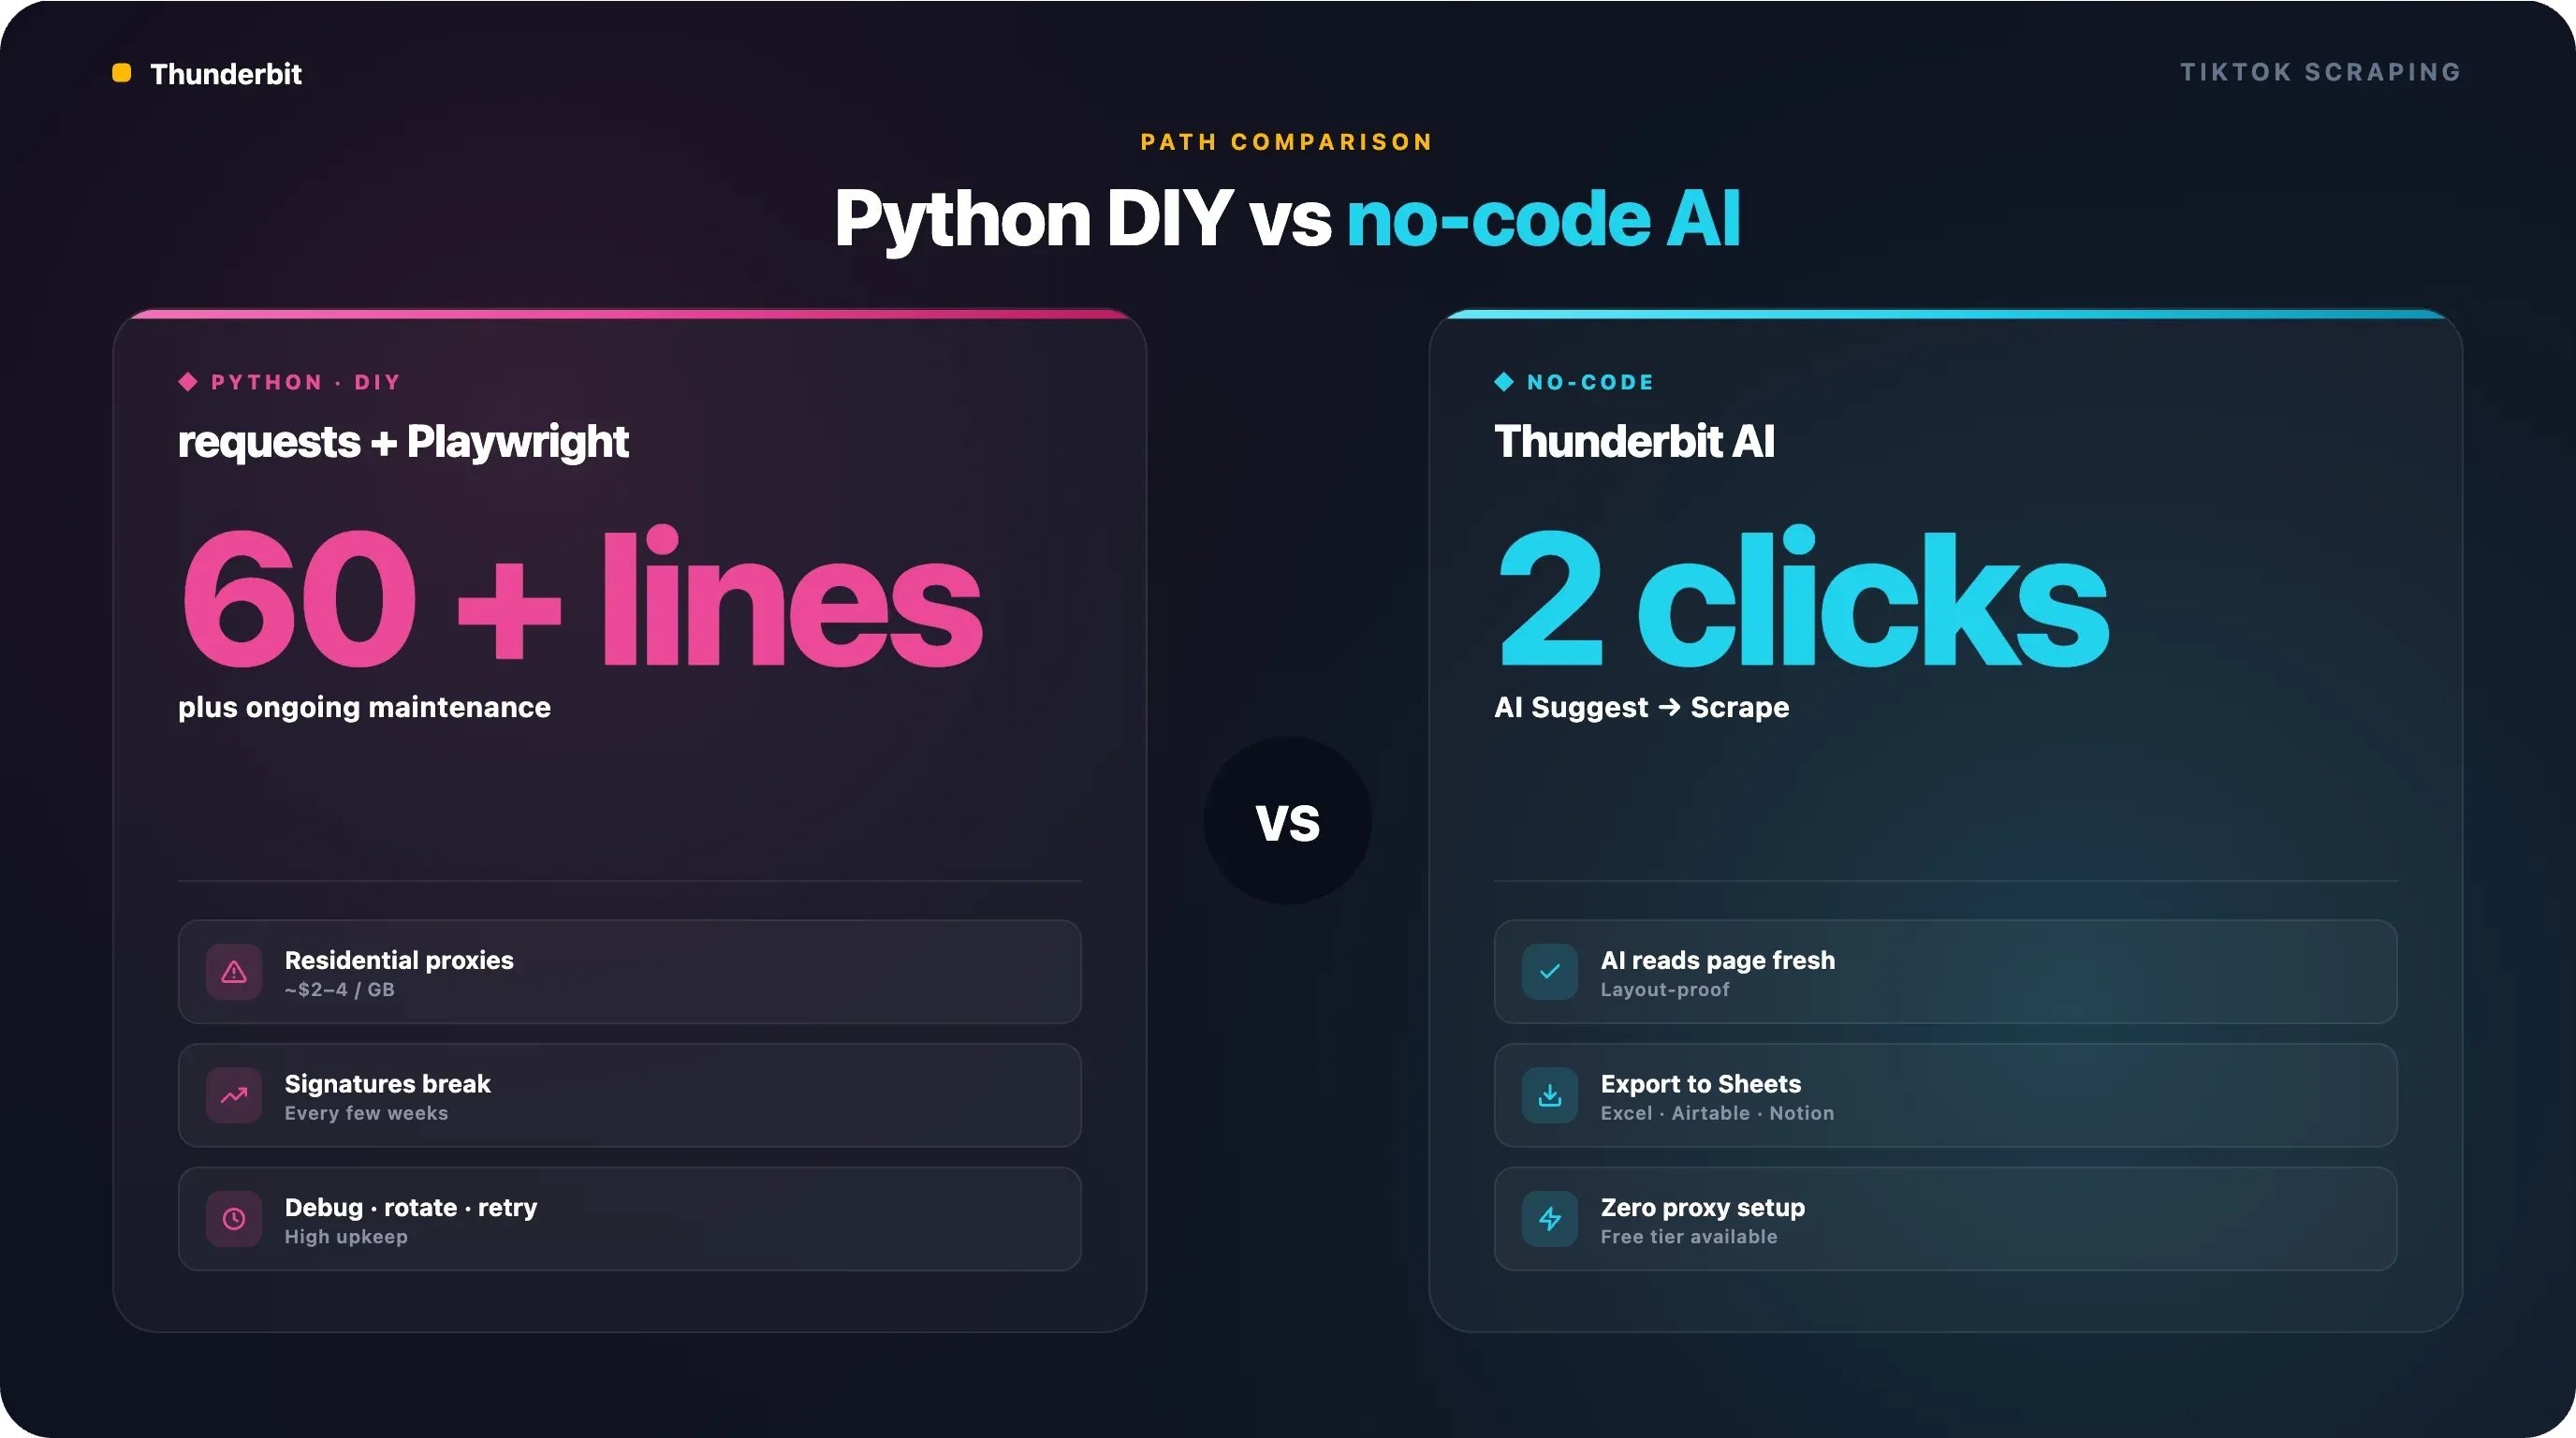
Tady je upřímné srovnání přístupů:
| Přístup | Úroveň znalostí | Cena | Údržba | Nejlepší pro |
|---|---|---|---|---|
| Python (DIY) | Středně pokročilý a výše | Zdarma (+ náklady na proxy) | Vysoká (skripty se rozbíjejí) | Plná kontrola, vlastní pipeline |
| Thunderbit (Chrome rozšíření) | Začátečník | K dispozici zdarma | Žádná (AI čte web pokaždé znovu) | Rychlé získání video dat, export do Sheets/Excelu |
| Apify TikTok Scraper | Začátečník | Placené (za běh) | Nízká (spravováno Apify) | Hromadné automatizované běhy podle plánu |
| TikAPI | Vývojář | Placené předplatné | Střední | Tvorba aplikací nad daty z TikToku |
Jak Thunderbit řeší scraping TikToku
Thunderbit je AI web scraper, který jsme vytvořili v Thunderbit, a funguje jinak než tradiční nástroje pro scraping. Místo spoléhání na předpřipravené CSS selektory nebo XPath pravidla, která se pokaždé rozbijí, když TikTok změní rozložení, Thunderbitova AI pokaždé znovu přečte strukturu stránky a navrhne relevantní sloupce — popisek, lajky, hashtagy, URL videa, autora atd.
Pracuje to opravdu jen ve dvou krocích:
- Otevřete profil TikToku v Chromu, kliknete na rozšíření Thunderbit a zvolíte „AI Suggest Fields“. Thunderbit projde stránku a navrhne tabulkovou strukturu.
- Zkontrolujete navržené sloupce, upravíte je podle potřeby a kliknete na „Scrape“.
Data se pak exportují přímo do Google Sheets, Excelu, Airtable nebo Notion. Žádné CSS selektory, které byste museli udržovat, žádný kód k ladění, žádná konfigurace proxy. Pro marketingového analytika, který potřebuje metadata videí z několika profilů, je to měřitelně rychlejší než nastavovat Python prostředí — a navíc se to nerozbije pokaždé, když TikTok upraví frontend (což se podle komunitních hlášení děje každých pár týdnů).
Thunderbit podporuje i scraping podstránek — může navštívit jednotlivé stránky videí a obohatit tabulku o další detaily, jako jsou kompletní počty komentářů, informace o hudbě nebo délka videa.
Můžete si ho vyzkoušet zdarma přes Thunderbit Chrome Extension. Více o tom, jak funguje, najdete na našem YouTube kanálu.
Právní a etické zásady při scrapování TikToku
Žádný z nejvýše hodnocených tutoriálů k tomuto tématu neřeší legálnost, což je s ohledem na to, že TikTok už aktivně podniká právní kroky proti scrapingovým službám, docela zásadní opomenutí. Tady je to, co byste měli vědět.
Podmínky služby TikToku (§ 4.1) výslovně zakazují automatizovaný přístup. Porušení ToS je porušením smluvních podmínek, ne trestným činem — může ale vést k blokaci účtu, blokaci IP nebo občanskoprávním krokům.
Právní prostředí je u veřejných dat shovívavější, než si mnozí myslí. Klíčovým precedensem je Meta Platforms v. Bright Data (N.D. Cal., leden 2024), kde soud rozhodl, že scrapování veřejně dostupných dat při odhlášeném stavu neporušuje podmínky služby Meta. Meta případ stáhla a vzdala se odvolání. Dřívější rozhodnutí hiQ v. LinkedIn u 9. okruhu (potvrzené po Van Buren) stanovilo, že scrapování veřejně dostupných dat není porušením CFAA — hiQ ale nakonec případ urovnala, zaplatila 500 tisíc dolarů a souhlasila s trvalým soudním zákazem, což ukazuje, že vymáhání ToS pořád může být tvrdé.
GDPR a CCPA se vztahují na sběr osobních údajů od uživatelů z EU nebo Kalifornie. Scrapování veřejných příspěvků je jedna věc; vytváření databází osobních údajů jednotlivých uživatelů je věc druhá.
Praktická doporučení:
- Omezujte rychlost požadavků (nezahlcujte servery TikToku)
- Nescrapujte soukromé účty ani obsah nezletilých
- Nepřeposílejte komerčně chráněný video obsah
- Respektujte
robots.txt(TikTok většinu automatického crawlování zakazuje) - Stahování videí pro osobní výzkum nebo analýzu je něco jiného než jejich znovupublikování — rozdíl je důležité chápat
Upozornění: Toto je vzdělávací obsah, ne právní rada. Pokud stavíte komerční produkt nad scrapovanými daty z TikToku, poraďte se s právníkem.
Shrnutí: hlavní poznatky
Scraping TikToku v roce 2025 je pohyblivý cíl. Anti-bot stack téhle platformy patří k nejsofistikovanějším na webu a naivní přístupy (obyčejný requests, úryvky vygenerované ChatGPT, zastaralé tutoriály) selžou. Se správnou metodou je to ale úplně proveditelné.
Co si odnést:
- Metoda 1 (skryté JSON) je nejrychlejší a nejjednodušší — začněte tady, pokud potřebujete rychle získat data z profilu.
- Metoda 2 (interní API) vám dá stránkování a hromadný přístup, ale vyžaduje nejvíc údržby, protože endpointy i požadavky na signatury se mění.
- Metoda 3 (Playwright) je nejodolnější proti anti-bot opatřením, ale za cenu nižší rychlosti a vyšší spotřeby zdrojů.
- Všechny tři metody umí vytáhnout URL pro stažení videí — a tenhle návod jako jediný ukazuje, jak skutečně stáhnout .mp4 soubory se správnými hlavičkami.
- Pro netechnické uživatele nabízí Thunderbit opravdu rychlejší cestu ke stejným datům bez psaní nebo údržby kódu. Díky AI přístupu se nerozbije pokaždé, když TikTok změní rozložení — což se podle komunitních zkušeností děje častěji, než by si kdokoli přál.
Pokud chcete začít bez nastavování Pythonu, vyzkoušejte Thunderbit Chrome Extension — bezplatná verze stačí na otestování na několika profilech a zjistíte, jestli sedí vašemu workflow. Pokud půjdete cestou Pythonu, začněte metodou 1, ověřte si data a pak škálujte dál.
Chcete jít hlouběji do technik web scrapingu? Podívejte se na naše průvodce jak získávat data z jakékoli webové stránky, best practices web scrapingu a scrapování do Google Sheets.
FAQ
Je legální stahovat videa z TikToku pomocí Pythonu?
Scrapování veřejně dostupných dat je právně šedá zóna, ne jednoznačné porušení. Rozhodnutí Meta v. Bright Data (2024) podporuje názor, že odhlášené scrapování veřejných dat neporušuje podmínky platformy. TikTok ale výslovně zakazuje automatizovaný přístup a na osobní data se vztahují i povinnosti podle GDPR/CCPA. Není to nelegální v tom smyslu, jak se mnozí obávají, ale zároveň to není bez rizika. Pro svůj konkrétní případ se poraďte s právníkem.
Jaká je nejlepší Python knihovna pro scraping TikToku?
Záleží na zvoleném přístupu. Pro extrakci skrytého JSONu (metoda 1) stačí requests + beautifulsoup4. Pro volání interního API (metoda 2) funguje requests nebo httpx. Pro automatizaci prohlížeče (metoda 3) je dnes standardem playwright — u nových scrapingových projektů už předběhl Selenium a má cca 59 milionů měsíčních stažení na PyPI, zatímco Selenium má zhruba 53 milionů. Za zvážení stojí i wrapper TikTok-Api (asi 6,3 tisíce hvězdiček na GitHubu), pokud chcete vyšší úroveň abstrakce, i když bývá křehký.
Můžu stahovat videa z TikToku bez vodoznaku pomocí Pythonu?
Ano. TikTok sám ve svých datech obsahuje URL playAddr, které obvykle poskytuje verzi videa bez standardního watermarku. Tenhle návod ukazuje, jak tuto URL získat kteroukoli ze tří metod a stáhnout .mp4 soubor se správnými hlavičkami. Pole downloadAddr naproti tomu obsahuje vodoznak.
Proč můj TikTok scraper vrací prázdná data?
Nejčastější příčina je, že TikTok ke vykreslení obsahu potřebuje JavaScript. Základní requests.get() stáhne jen HTML kostru — skutečná data jsou buď ve skrytém JSON script tagu (metoda 1), nebo se dynamicky načítají přes JavaScript (metoda 3). Pokud dostáváte prázdné HTML, zkuste nejdřív metodu 1. Pokud to nepomůže, zkontrolujte hlavičky (chybějící Referer je hlavní příčina 403 chyb) nebo přejděte na metodu 3 s Playwrightem.
Jak se vyhnout blokaci při scrapování TikToku?
Používejte realistické hlavičky prohlížeče (včetně User-Agent, Referer a Accept-Language), rotujte rezidenční nebo mobilní proxy (datacentrové IP bývají označeny během pár minut), přidávejte náhodné prodlevy mezi požadavky (minimálně 1–3 sekundy) a nescrapujte v extrémním objemu. Metoda 3 (Playwright) nabízí nejvyšší odolnost vůči blokaci, protože napodobuje skutečnou browserovou session. Při jakémkoli seriózním objemu počítejte s náklady na proxy — vstupní rezidenční proxy stojí od 2 do 4 dolarů za GB u hlavních poskytovatelů.
- Zjistit více



