
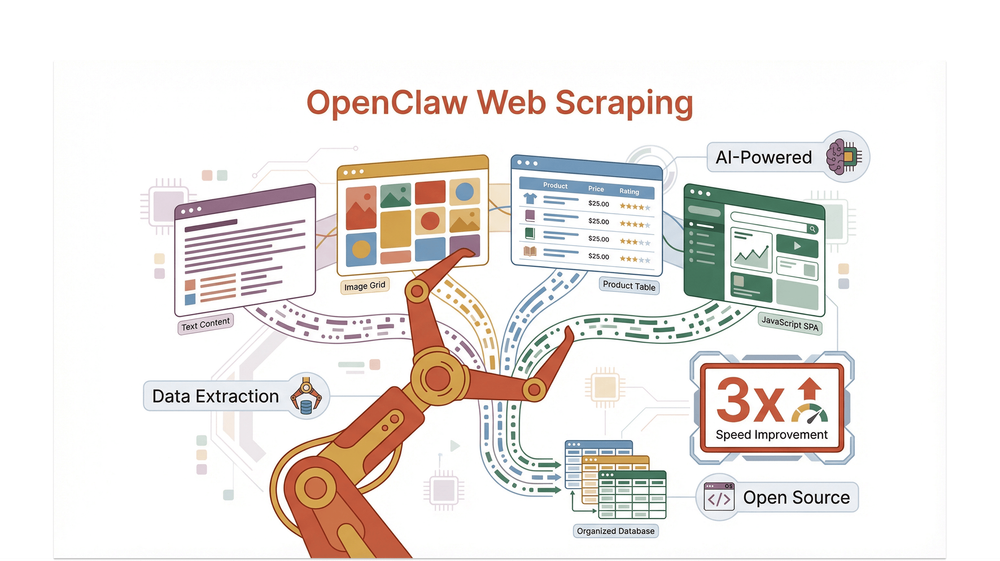
Je na tom něco zvláštně uspokojujícího: sledovat skript, jak sviští webem a sbírá data, zatímco si vychutnáváte kávu. Jestli jste na tom jako já, nejspíš jste si už někdy položili otázku: „Jak udělat web scraping rychlejší, chytřejší a méně otravný?“
Přesně to mě přivedlo do světa web scrapingu v OpenClaw. V digitálním prostředí, kde více než 90 % firem spoléhá na extrakci webových dat pro všechno od obchodních leadů až po market intelligence, není zvládnutí správných nástrojů jen technická frajeřinka — je to byznysová nutnost.
OpenClaw se rychle stal oblíbencem v komunitě kolem scrapingu, hlavně mezi těmi, kdo pracují s dynamickými, obrazově bohatými nebo složitými weby, se kterými si tradiční scrapery často nevědí rady.
V tomto průvodci vás provedu vším od nastavení OpenClaw až po tvorbu pokročilých automatizovaných workflow. A protože já si zakládám na šetření času, ukážu vám také, jak svůj scraping výrazně zrychlit pomocí AI funkcí Thunderbit, abyste získali workflow, které není jen výkonné, ale i opravdu zábavné.
Vyzkoušejte Thunderbit pro chytřejší web scraping
Co je web scraping v OpenClaw?
Začněme od základů. Web scraping v OpenClaw znamená využití platformy OpenClaw — samostatně hostované open-source brány pro agenty — k automatizaci extrakce dat z webových stránek. OpenClaw není jen další scraper; je to modulární systém, který propojuje vaše oblíbené chatovací kanály (například Discord nebo Telegram) se sadou nástrojů pro agenty, včetně webových fetcherů, vyhledávacích utilit a dokonce i spravovaného prohlížeče pro weby náročné na JavaScript, u nichž se jiné nástroje zapotí.
Co dělá OpenClaw tak silným nástrojem pro extrakci webových dat? Je navržený tak, aby byl flexibilní i robustní. Můžete použít vestavěné nástroje jako web_fetch pro jednoduchou HTTP extrakci, spustit prohlížeč Chromium řízený agentem pro dynamický obsah nebo zapojit komunitní skills (například openclaw-plugin-web-scraper) pro pokročilejší workflow. Je open-source (licence MIT), aktivně udržovaný a má prosperující ekosystém pluginů a skillů, což z něj dělá skvělou volbu pro každého, kdo to s rozsáhlým scrapingem myslí vážně.
OpenClaw si poradí s širokou škálou datových typů a formátů webů, včetně:
- textu a strukturovaného HTML
- obrázků a odkazů na média
- dynamického obsahu vykreslovaného JavaScriptem
- složitých vícevrstvých DOM struktur
A protože je založený na agentech, můžete orchestrálně řídit scrapingové úlohy, automatizovat reporting a dokonce pracovat s daty v reálném čase — to vše přímo z vaší oblíbené chatovací aplikace nebo terminálu.
Proč je OpenClaw výkonný nástroj pro extrakci webových dat
Tak proč tolik datových profesionálů a automatizačních nadšenců míří k OpenClaw? Pojďme si rozebrat technické přednosti, díky nimž je tohle řešení silákem pro web scraping:
Rychlost a kompatibilita
Architektura OpenClaw je stavěná na rychlost. Jeho hlavní nástroj web_fetch využívá HTTP GET požadavky s chytrou extrakcí obsahu, ukládáním do mezipaměti a zpracováním přesměrování. V interních i komunitních benchmarcích OpenClaw konzistentně překonává starší nástroje, jako jsou BeautifulSoup nebo Selenium, při extrakci velkých objemů dat ze statických a částečně dynamických webů (docs.openclaw.ai).
Ale tam, kde OpenClaw opravdu vyniká, je kompatibilita. Díky režimu spravovaného prohlížeče si poradí i s weby, které pro vykreslování spoléhají na JavaScript — a právě to bývá kámen úrazu pro mnoho tradičních scraperů. Ať už cílíte na e‑shopový katalog bohatý na obrázky, nebo na jednostránkovou aplikaci s nekonečným scrollováním, profil Chromium řízený agentem v OpenClaw to zvládne.
Odolnost vůči změnám webu
Jedním z největších problémů při web scrapingu je, když aktualizace webu rozbije vaše skripty. Systém pluginů a skillů v OpenClaw je navržený tak, aby byl odolný. Například obálky kolem knihovny Scrapling nabízejí adaptivní extrakci, což znamená, že váš scraper dokáže znovu najít prvky i tehdy, když se rozložení webu změní — obrovská výhoda pro dlouhodobé projekty.
Reálný výkon
V porovnávacích testech workflow postavené na OpenClaw ukázaly:
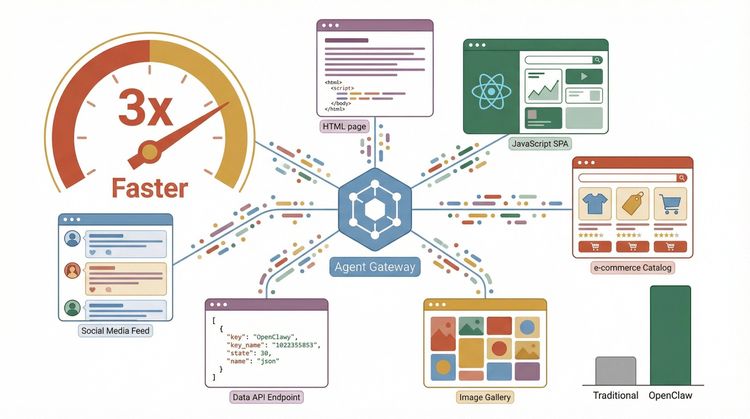
- až 3× rychlejší extrakci na složitých vícestránkových webech ve srovnání s tradičními Python scrapery (scrapling.readthedocs.io)
- vyšší úspěšnost na dynamických stránkách náročných na JavaScript díky spravovanému prohlížeči
- lepší práci s weby s kombinovaným obsahem (text, obrázky, HTML fragmenty)
Uživatelská doporučení často vyzdvihují schopnost OpenClaw „prostě fungovat“ tam, kde jiné nástroje selžou — zejména při scrapingu webů se zapeklitým rozložením nebo proti-bot ochranou.
Začínáme: Nastavení OpenClaw pro web scraping
Jste připraveni se do toho pustit? Tady je návod, jak OpenClaw rozběhnout na vašem systému.
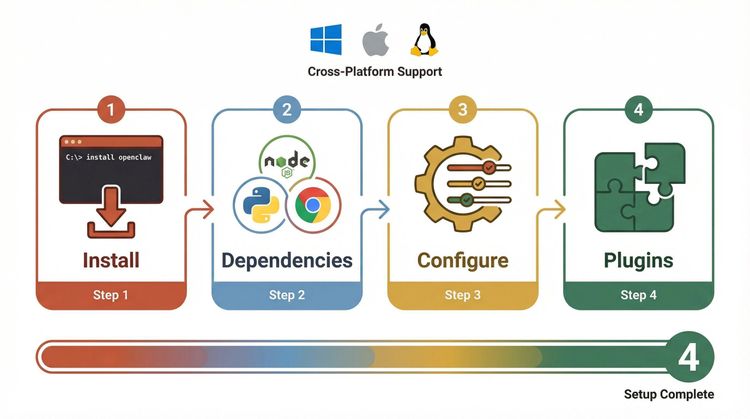
Krok 1: Nainstalujte OpenClaw
OpenClaw podporuje Windows, macOS i Linux. Oficiální dokumentace doporučuje začít řízeným onboardingem:
openclaw onboard
Tento příkaz vás provede úvodním nastavením, včetně kontroly prostředí a základní konfigurace.
Krok 2: Nainstalujte potřebné závislosti
Podle vašeho workflow můžete potřebovat:
- Node.js (pro hlavní bránu)
- Python 3.10+ (pro pluginy/skills, které používají Python, například obálky pro Scrapling)
- Chromium/Chrome (pro režim spravovaného prohlížeče)
Na Linuxu možná budete muset doinstalovat další balíčky pro podporu prohlížeče. Dokumentace má samostatnou sekci pro řešení problémů pro běžné potíže.
Krok 3: Nakonfigurujte webové nástroje
Nastavte si poskytovatele webového vyhledávání:
openclaw configure --section web
Díky tomu si můžete vybrat mezi poskytovateli jako Brave, DuckDuckGo nebo Firecrawl.
Krok 4: Nainstalujte pluginy nebo skills (volitelné)
Pokud chcete odemknout pokročilý scraping, nainstalujte komunitní pluginy nebo skills. Například pro přidání openclaw-plugin-web-scraper:
git clone https://github.com/hvkeyn/openclaw-plugin-web-scraper.git
cd openclaw-plugin-web-scraper
openclaw plugins install .
openclaw gateway restart
Tipy pro začátečníky
- Po instalaci nových pluginů spusťte
openclaw security audita zkontrolujte zranitelnosti (docs.openclaw.ai). - Pokud používáte Node přes nvm, zkontrolujte si CA certifikáty — nesoulad může rozbít HTTPS požadavky (docs.openclaw.ai).
- Pro extra bezpečnost vždy izolujte pluginy a komponenty prohlížeče ve VM nebo kontejneru.
Průvodce pro začátečníky: Váš první scrapingový projekt v OpenClaw
Pojďme si vytvořit jednoduchý scrapingový projekt — doktorát z informatiky k tomu fakt nepotřebujete.
Krok 1: Vyberte cílový web
Zvolte web se strukturovanými daty, třeba produktový katalog nebo adresář. V tomto příkladu budeme scrapovat názvy produktů z ukázkové e‑commerce stránky.
Krok 2: Pochopte strukturu DOM
Pomocí nástroje prohlížeče „Inspect Element“ najděte HTML tagy, které obsahují požadovaná data (např. <h2 class="product-title">).
Krok 3: Nastavte filtry extrakce
Se skills postavenými na Scraplingu v OpenClaw můžete používat CSS selektory k cílení na prvky. Tady je ukázkový skript využívající skill openclaw-ultra-scraping:
PYTHON=/opt/scrapling-venv/bin/python3
$PYTHON scripts/scrape.py fetch "https://example.com/products" --css "h2.product-title::text"
Tento příkaz načte stránku a vytáhne všechny názvy produktů.
Krok 4: Bezpečná práce s daty
Výsledky exportujte do CSV nebo JSON pro snadnou analýzu:
$PYTHON scripts/scrape.py fetch "https://example.com/products" --css "h2.product-title::text" -f csv -o products.csv
Vysvětlení klíčových pojmů
- Schémata nástrojů: Definují, co jednotlivé nástroje nebo skills umí (načítat, extrahovat, procházet).
- Registrace skillů: Přidávání nových scrapingových funkcí do OpenClaw přes ClawHub nebo ruční instalací.
- Bezpečná práce s daty: Před použitím v produkci vždy výstupy validujte a očistěte.
Automatizace složitých scrapingových workflow s OpenClaw
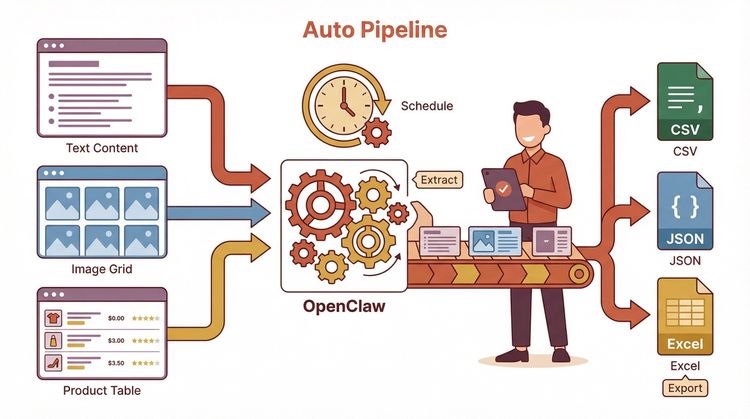
Jakmile zvládnete základy, je čas automatizovat. Tady je návod, jak vytvořit workflow, které poběží samo (zatímco se vy budete věnovat důležitějším věcem — třeba obědu).
Krok 1: Vytvořte a zaregistrujte vlastní skills
Napište nebo nainstalujte skills, které přesně odpovídají vašim potřebám extrakce. Můžete například chtít scrapovat informace o produktech a obrázky a pak denně posílat report.
Krok 2: Nastavte plánované úlohy
Na Linuxu nebo macOS použijte cron pro plánování scrapingových skriptů:
0 6 * * * /usr/bin/python3 /path/to/scrape.py fetch "https://example.com/products" --css "h2.product-title::text" -f csv -o /data/products_$(date +\%F).csv
Ve Windows použijte Plánovač úloh se stejnými parametry.
Krok 3: Propojte to s dalšími nástroji
Pro dynamickou navigaci (např. klikání na tlačítka nebo přihlašování) zkombinujte OpenClaw se Selenium nebo Playwrightem. Mnoho skillů v OpenClaw umí tyto nástroje volat nebo přijímat skripty pro automatizaci prohlížeče.
Porovnání ručního a automatizovaného workflow
| Krok | Ruční workflow | Automatizované workflow v OpenClaw |
|---|---|---|
| Extrakce dat | Spustit skript ručně | Plánováno přes cron / Plánovač úloh |
| Dynamická navigace | Klikat ručně | Automatizováno pomocí Selenium/skills |
| Export dat | Kopírování/vkládání nebo stažení | Automatický export do CSV/JSON |
| Reporting | Ruční shrnutí | Automatické generování a odesílání reportů |
| Zpracování chyb | Opravy za pochodu | Vestavěné opakování / logování |
Výsledek? Více dat, méně dřiny a workflow, které roste spolu s vašimi ambicemi.
Zvyšte efektivitu: Propojení AI funkcí Thunderbit s OpenClaw
A teď přichází ta opravdu zajímavá část. Jako spoluzakladatel Thunderbit pevně věřím v kombinaci toho nejlepšího z obou světů: flexibilního scrapingového enginu OpenClaw a AI funkcí Thunderbit pro detekci polí a export.
Jak Thunderbit posiluje OpenClaw
- AI Suggest Fields: Thunderbit dokáže automaticky analyzovat webovou stránku a doporučit nejlepší sloupce k extrakci — už žádné hádání CSS selektorů.
- Okamžitý export dat: Exportujte nasbíraná data přímo do Excelu, Google Sheets, Airtable nebo Notion jediným kliknutím (Thunderbit Docs).
- Hybridní workflow: Použijte OpenClaw pro složitou navigaci a logiku scrapingu a pak výsledky pošlete do Thunderbit pro mapování polí, obohacení a export.
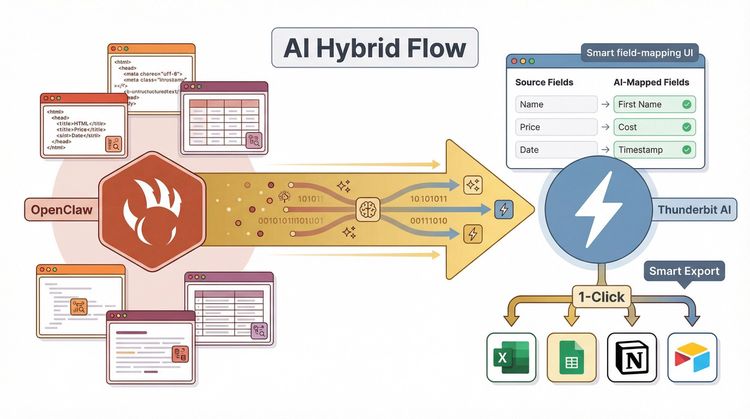
Příklad hybridního workflow
- Pomocí spravovaného prohlížeče OpenClaw nebo skillu Scrapling vytáhněte surová data z dynamického webu.
- Importujte výsledky do Thunderbit.
- Klikněte na „AI Suggest Fields“ pro automatické namapování dat.
- Exportujte do preferovaného formátu nebo platformy.
Tahleta kombinace mění pravidla hry pro týmy, které potřebují výkon i jednoduchost — typicky sales ops, analytiky v e‑commerce a kohokoli, kdo už má dost zápasu s chaotickými tabulkami.
Vyzkoušejte Thunderbit AI Suggest Fields
Řešení problémů v reálném čase: Běžné chyby OpenClaw a jak je opravit
I ty nejlepší nástroje občas narazí. Tady je rychlý průvodce, jak diagnostikovat a opravit běžné potíže při scrapingu v OpenClaw:
Časté chyby
- Problémy s autentizací: Některé weby blokují boty nebo vyžadují přihlášení. Použijte spravovaný prohlížeč OpenClaw nebo integraci se Selenium pro přihlašovací flow (docs.openclaw.ai).
- Blokované požadavky: Rotujte user agenty, používejte proxy nebo zpomalte frekvenci požadavků, abyste se vyhnuli banům.
- Chyby parsování: Znovu si zkontrolujte CSS/XPath selektory; web se mohl strukturálně změnit.
- Chyby pluginů/skillů: Spusťte
openclaw plugins doctorpro diagnostiku problémů s nainstalovanými rozšířeními (docs.openclaw.ai).
Diagnostické příkazy
openclaw status– Zkontroluje stav brány a nástrojů.openclaw security audit– Provede kontrolu zranitelností.openclaw browser --browser-profile openclaw status– Zkontroluje zdraví automatizace prohlížeče.
Komunitní zdroje
Nejlepší postupy pro spolehlivý a škálovatelný scraping v OpenClaw
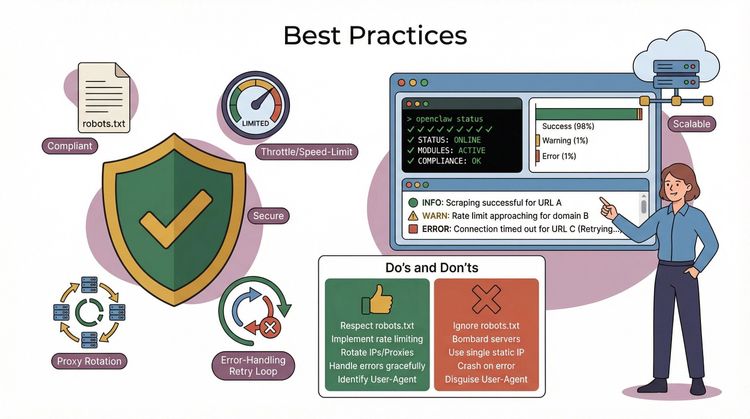
Chcete, aby váš scraping běžel hladce a dlouhodobě udržitelně? Tady je můj checklist:
- Respektujte robots.txt: Scrapujte jen to, co máte povoleno.
- Omezujte rychlost požadavků: Nezahlcujte weby příliš mnoha požadavky za sekundu.
- Validujte výstupy: Vždy zkontrolujte úplnost a přesnost dat.
- Sledujte využití: Logujte spuštění scrapingu a hlídejte chyby nebo bany.
- Pro škálování používejte proxy: Rotujte IP adresy, abyste se vyhnuli rate limitům.
- Nasazujte do cloudu: U velkých úloh provozujte OpenClaw ve VM nebo v kontejnerizovaném prostředí.
- Zpracovávejte chyby elegantně: Do skriptů přidejte opakování pokusů a fallback logiku.
| Dělejte | Nedělejte |
|---|---|
| Používejte oficiální pluginy/skills | Slepě neinstalujte nedůvěryhodný kód |
| Pravidelně provádějte bezpečnostní audity | Ignorujte varování o zranitelnostech |
| Před produkcí testujte na stagingu | Nescrapujte citlivá nebo soukromá data |
| Dokumentujte své workflow | Nespoléhejte na napevno zakódované selektory |
Pokročilé tipy: Úpravy a rozšiřování OpenClaw pro specifické potřeby
Pokud jste připraveni jet na plný výkon, OpenClaw vám umožní vytvářet vlastní skills a pluginy pro specializované úkoly.
Vývoj vlastních skillů
- Postupujte podle dokumentace OpenClaw skill SDK a vytvořte nové extrakční nástroje.
- Použijte Python nebo TypeScript podle toho, co vám víc sedí.
- Zaregistrujte svůj skill v ClawHubu pro snadné sdílení a opětovné použití.
Pokročilé funkce
- Řetězení skillů: Kombinujte více kroků extrakce (např. nejdřív scrape seznamové stránky a pak navštivte každou detailní stránku).
- Headless prohlížeče: Použijte spravovaný Chromium v OpenClaw nebo integrujte Playwright pro weby náročné na JavaScript.
- Integrace AI agentů: Propojte OpenClaw s externími AI službami pro chytřejší parsování dat nebo jejich obohacení.
Zpracování chyb a správa kontextu
- Do svých skillů zapracujte robustní ošetření chyb (try/except v Pythonu, error callbacky v TypeScriptu).
- Používejte kontextové objekty pro předávání stavu mezi kroky scrapingu.
Pro inspiraci mrkněte na komunitně přidané skills a referenci API Scrapling.
Závěr a klíčové poznatky
Prošli jsme pořádný kus cesty — od instalace OpenClaw a spuštění prvního scrapu až po tvorbu automatizovaných hybridních workflow s Thunderbit. Tady je, co byste si měli odnést:
- OpenClaw je flexibilní open-source powerhouse pro extrakci webových dat, zejména na složitých nebo dynamických webech.
- Jeho ekosystém pluginů a skillů vám umožní vyřešit všechno od jednoduchých fetchů až po pokročilý vícekrokový scraping.
- Kombinace OpenClaw s AI funkcemi Thunderbit výrazně usnadňuje mapování polí, export dat i automatizaci workflow.
- Zůstaňte bezpeční a v souladu s pravidly: Auditujte prostředí, respektujte pravidla webu a validujte svá data.
- Nebojte se experimentovat: Komunita OpenClaw je aktivní a přátelská — zapojte se, zkoušejte nové skills a sdílejte své úspěchy.
Pokud chcete svou efektivitu při scrapingu posunout ještě dál, Thunderbit je tu pro vás. A pokud se chcete dál učit, mrkněte na Thunderbit Blog pro další hlubší rozbory a praktické návody.
Šťastný scraping — a ať vaše selektory vždy trefí přesně to, co mají.
Často kladené otázky
1. Čím se OpenClaw liší od tradičních web scraperů, jako jsou BeautifulSoup nebo Scrapy?
OpenClaw je postavený jako brána pro agenty s modulárními nástroji, podporou spravovaného prohlížeče a systémem pluginů/skillů. Díky tomu je flexibilnější pro dynamické weby, weby náročné na JavaScript nebo obrazově bohaté stránky a zároveň usnadňuje automatizaci end-to-end workflow ve srovnání s tradičními, kódem těžkopádnými frameworky (docs.openclaw.ai).
2. Můžu OpenClaw používat, i když nejsem vývojář?
Ano! Onboarding v OpenClaw i jeho ekosystém pluginů jsou přívětivé pro začátečníky. U složitějších úloh můžete využít skills vytvořené komunitou nebo OpenClaw zkombinovat s no-code nástroji, jako je Thunderbit, pro snadné mapování polí a export.
3. Jak řešit běžné chyby v OpenClaw?
Začněte s openclaw status a openclaw security audit. U problémů s pluginy použijte openclaw plugins doctor. Pro řešení běžných potíží se podívejte do oficiální dokumentace a do GitHub issues.
4. Je používání OpenClaw pro web scraping bezpečné a legální?
Stejně jako u jakéhokoli scraperu vždy respektujte podmínky použití webu a robots.txt. OpenClaw je open-source a běží lokálně, ale měli byste auditovat pluginy z hlediska bezpečnosti a nescrapovat citlivá nebo soukromá data bez povolení (github.com).
5. Jak můžu OpenClaw propojit s Thunderbit pro lepší výsledky?
Použijte OpenClaw pro složitou scrapingovou logiku a pak importujte surová data do Thunderbit. AI Suggest Fields v Thunderbit data automaticky namapuje a vy je můžete exportovat přímo do Excelu, Google Sheets, Notion nebo Airtable — vaše workflow tak bude rychlejší a spolehlivější (Thunderbit Docs).
Chcete vidět, jak Thunderbit může posunout váš scraping? Stáhněte si rozšíření pro Chrome a začněte dnes budovat chytřejší hybridní workflow. A nezapomeňte se podívat na YouTube kanál Thunderbit pro praktické návody a tipy.
Vyzkoušejte Thunderbit pro chytřejší web scraping Get Started Free
Více informací
- Jak nainstalovat rozšíření Claude pro Chrome: Jednoduchý návod
- Co je Cloudflare Markdown for Agents? Podrobný přehled
- Top 10 nejlepších nástrojů pro crawling dat pro efektivní extrakci webu
- Top 10 nejlepších softwarových nástrojů pro web scraping v roce 2026
- Jak efektivně hledat e-mailovou adresu v roce 2026




