
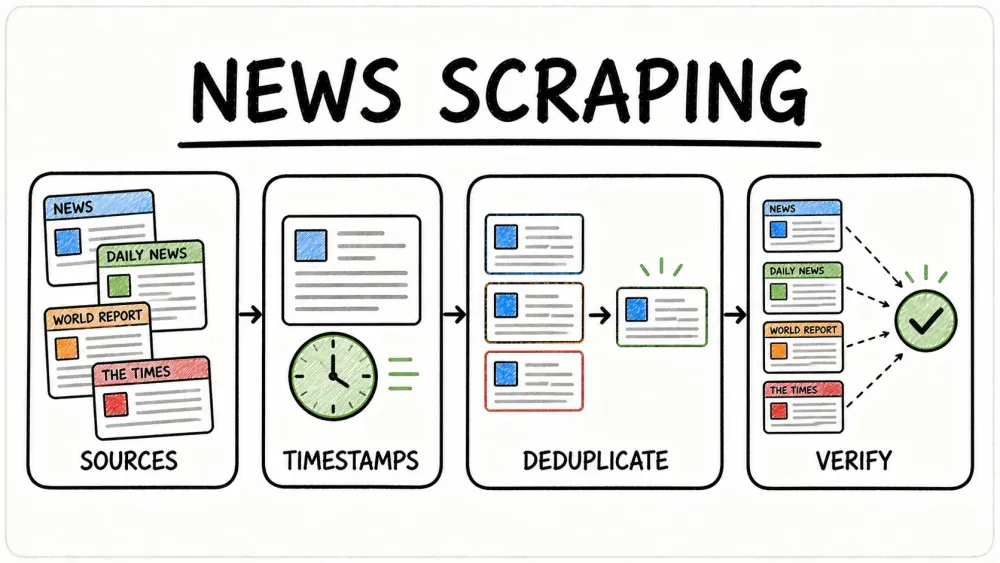
Tempo digitálních zpráv je dnes až závratné. Každou minutu se napříč hlavními médii, specializovanými blogy i sociálními sítěmi zveřejňují, aktualizují nebo potichu upravují tisíce titulků.
Abychom si to představili v číslech, LexisNexis Newsdesk zpracuje denně přes 4 miliony zpravodajských článků, zatímco GDELT Project sleduje zprávy ve 100+ jazycích a aktualizuje svůj globální feed každých 15 minut.
Pro kohokoli z médií, výzkumu nebo business intelligence je snaha držet s tímto proudem krok ručně podobná tomu, jako byste se snažili vylévat vodu z potápějící se lodi hrnkem od kávy.
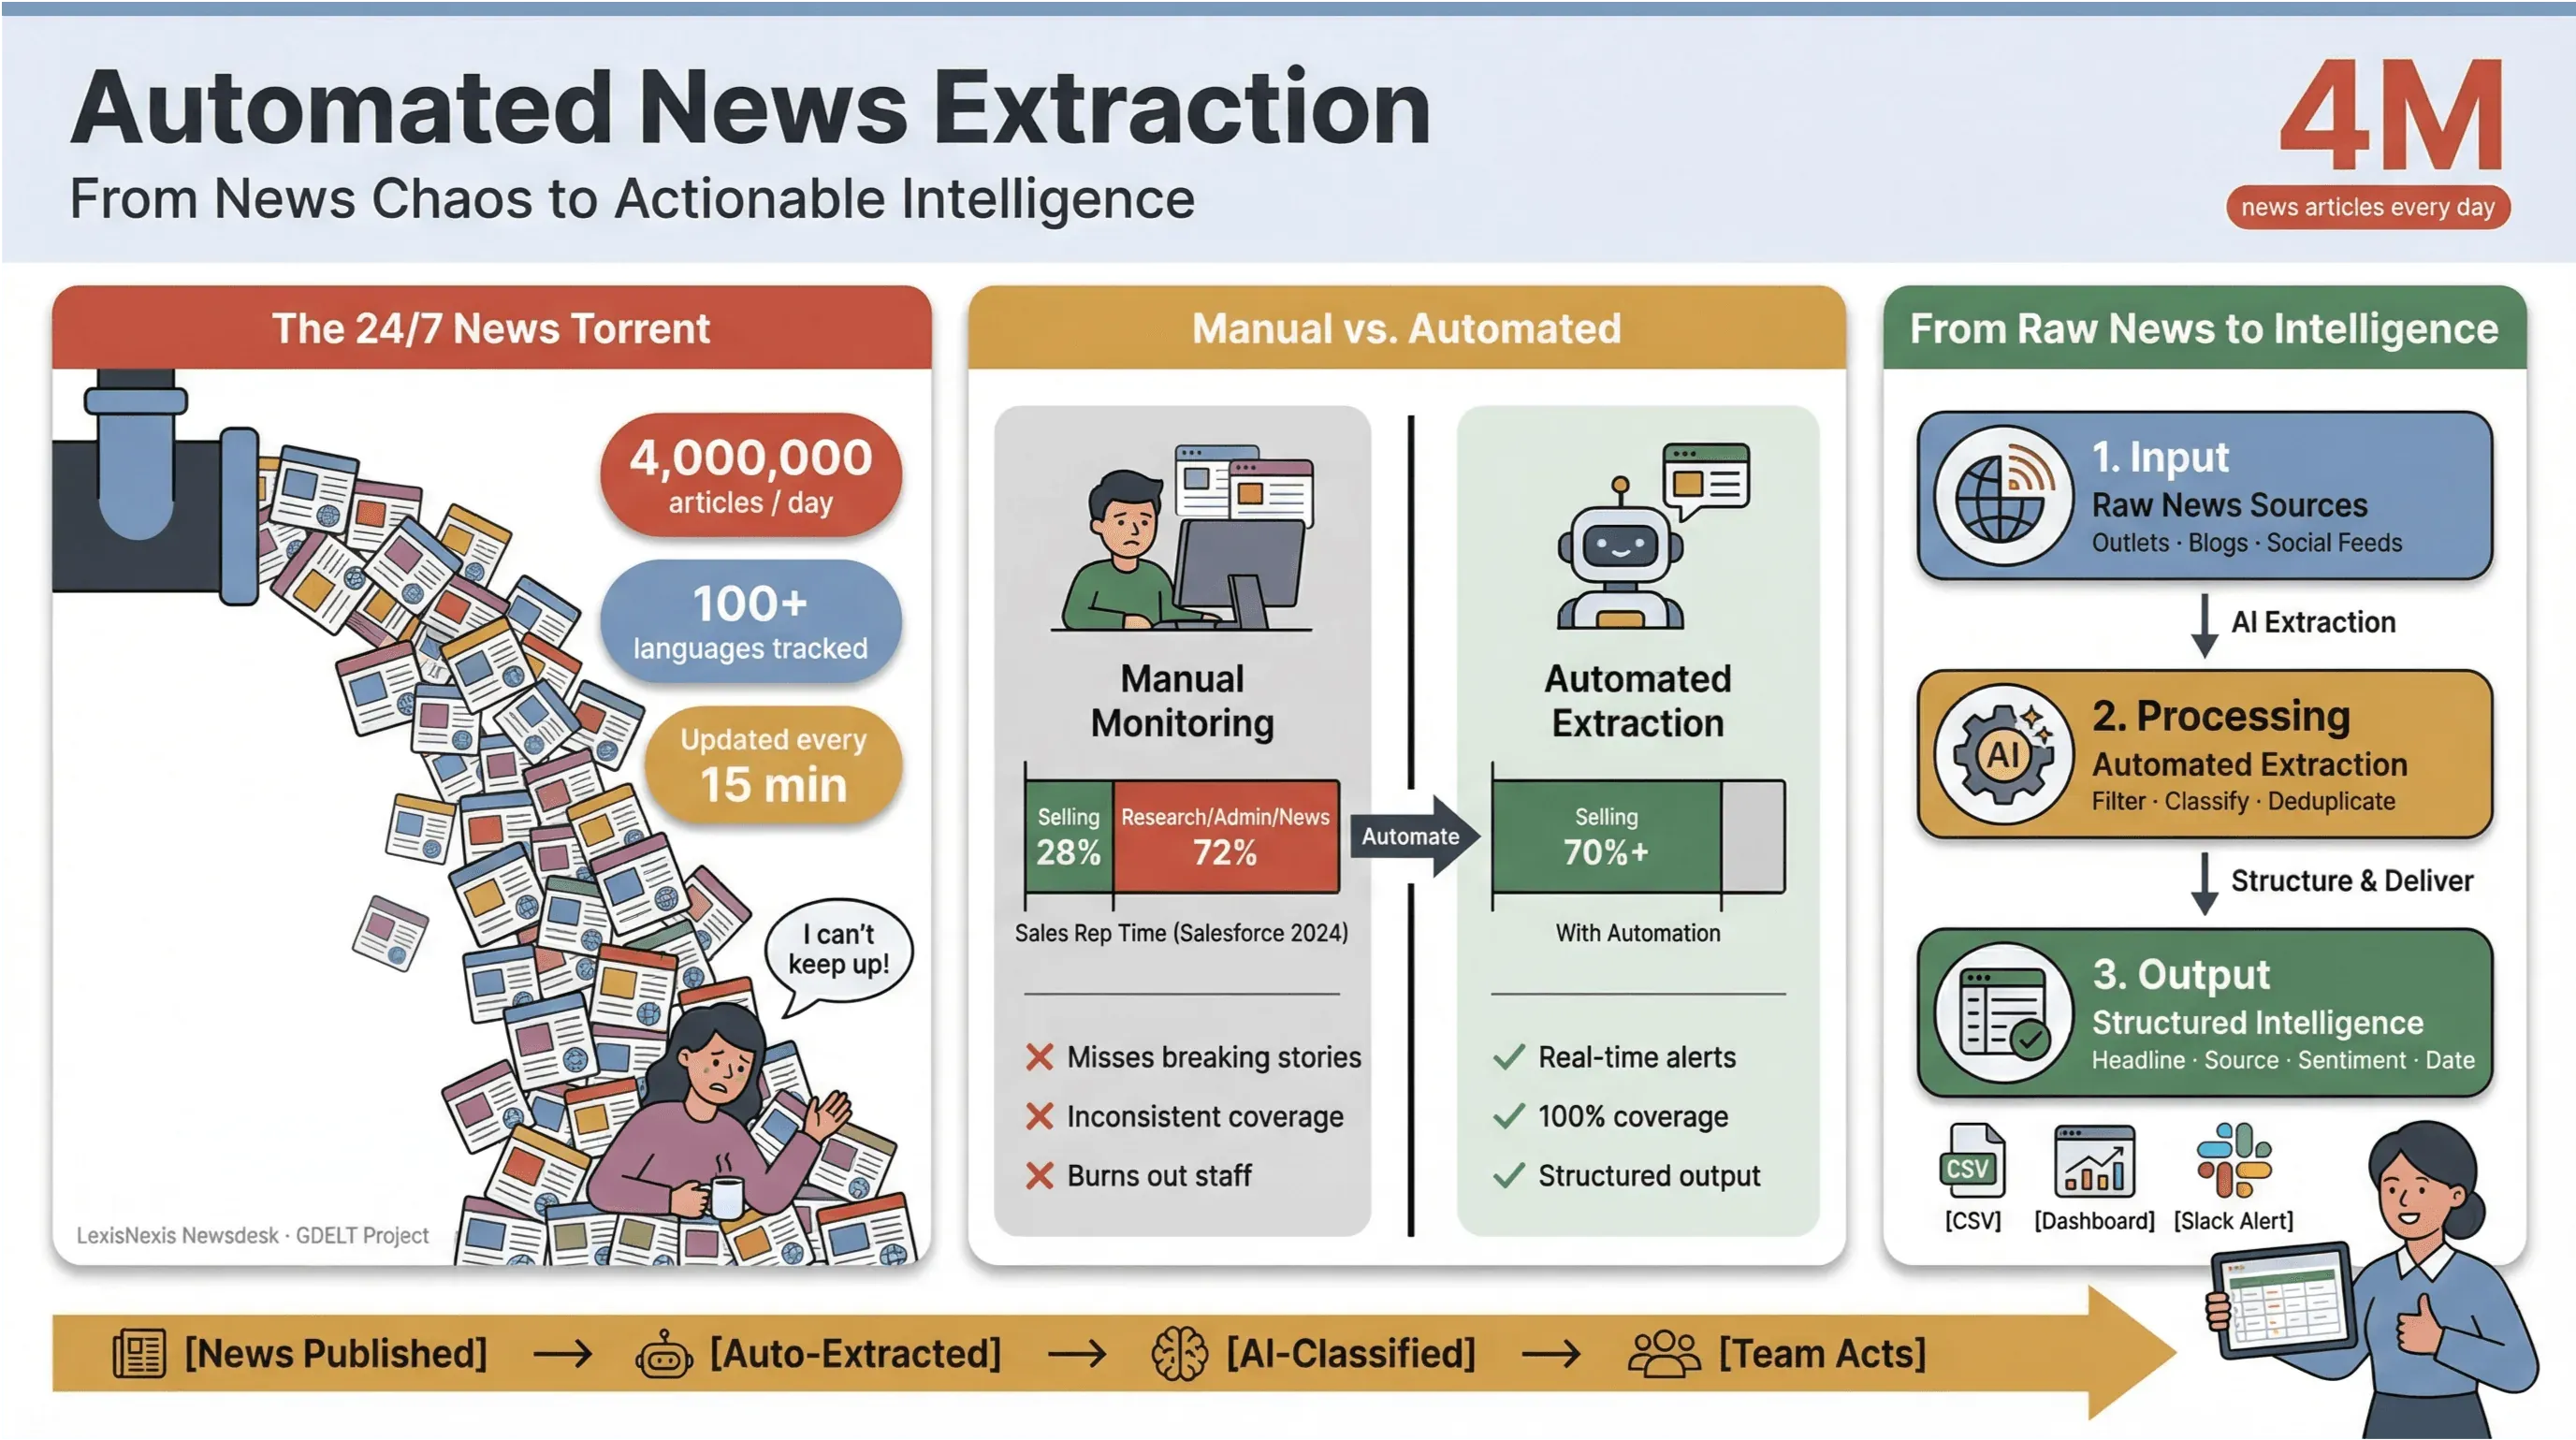
Na vlastní oči jsem viděl, jak ruční monitoring zpráv požírá čas i rozpočty. Prodejní týmy tráví skutečným prodejem méně než třetinu týdne — podle Salesforce jen 28 % — a zbytek mizí ve výzkumu, administrativě a ano, v nekonečném přepínání mezi záložkami se zprávami.
Právě proto se automatizovaná extrakce zpráv stala tajnou zbraní moderních týmů: je to jediný způsob, jak proměnit chaos nepřetržitého zpravodajského cyklu ve strukturovanou, prakticky využitelnou inteligenci — bez vyčerpání týmu a bez toho, aby vám unikly ty nejdůležitější příběhy.
Pojďme se podívat, co automatizovaná extrakce zpráv skutečně znamená, proč je zásadní pro každého, kdo pracuje s daty o aktuálním dění, a jak sestavit spolehlivý a legislativně bezpečný workflow pomocí nejlepších nástrojů (včetně toho, jak Thunderbit celý proces nečekaně zjednodušuje — i pro netechnické uživatele, jako je moje máma).
Vyzkoušejte Thunderbit pro automatizovanou extrakci zpráv Titulek, čas publikace, autor i shrnutí z libovolné zpravodajské stránky — jedním kliknutím a s možností naplánování opakování. Get Started Free
Automatizovaná extrakce zpráv: Proč je pro moderní redakce nezbytná
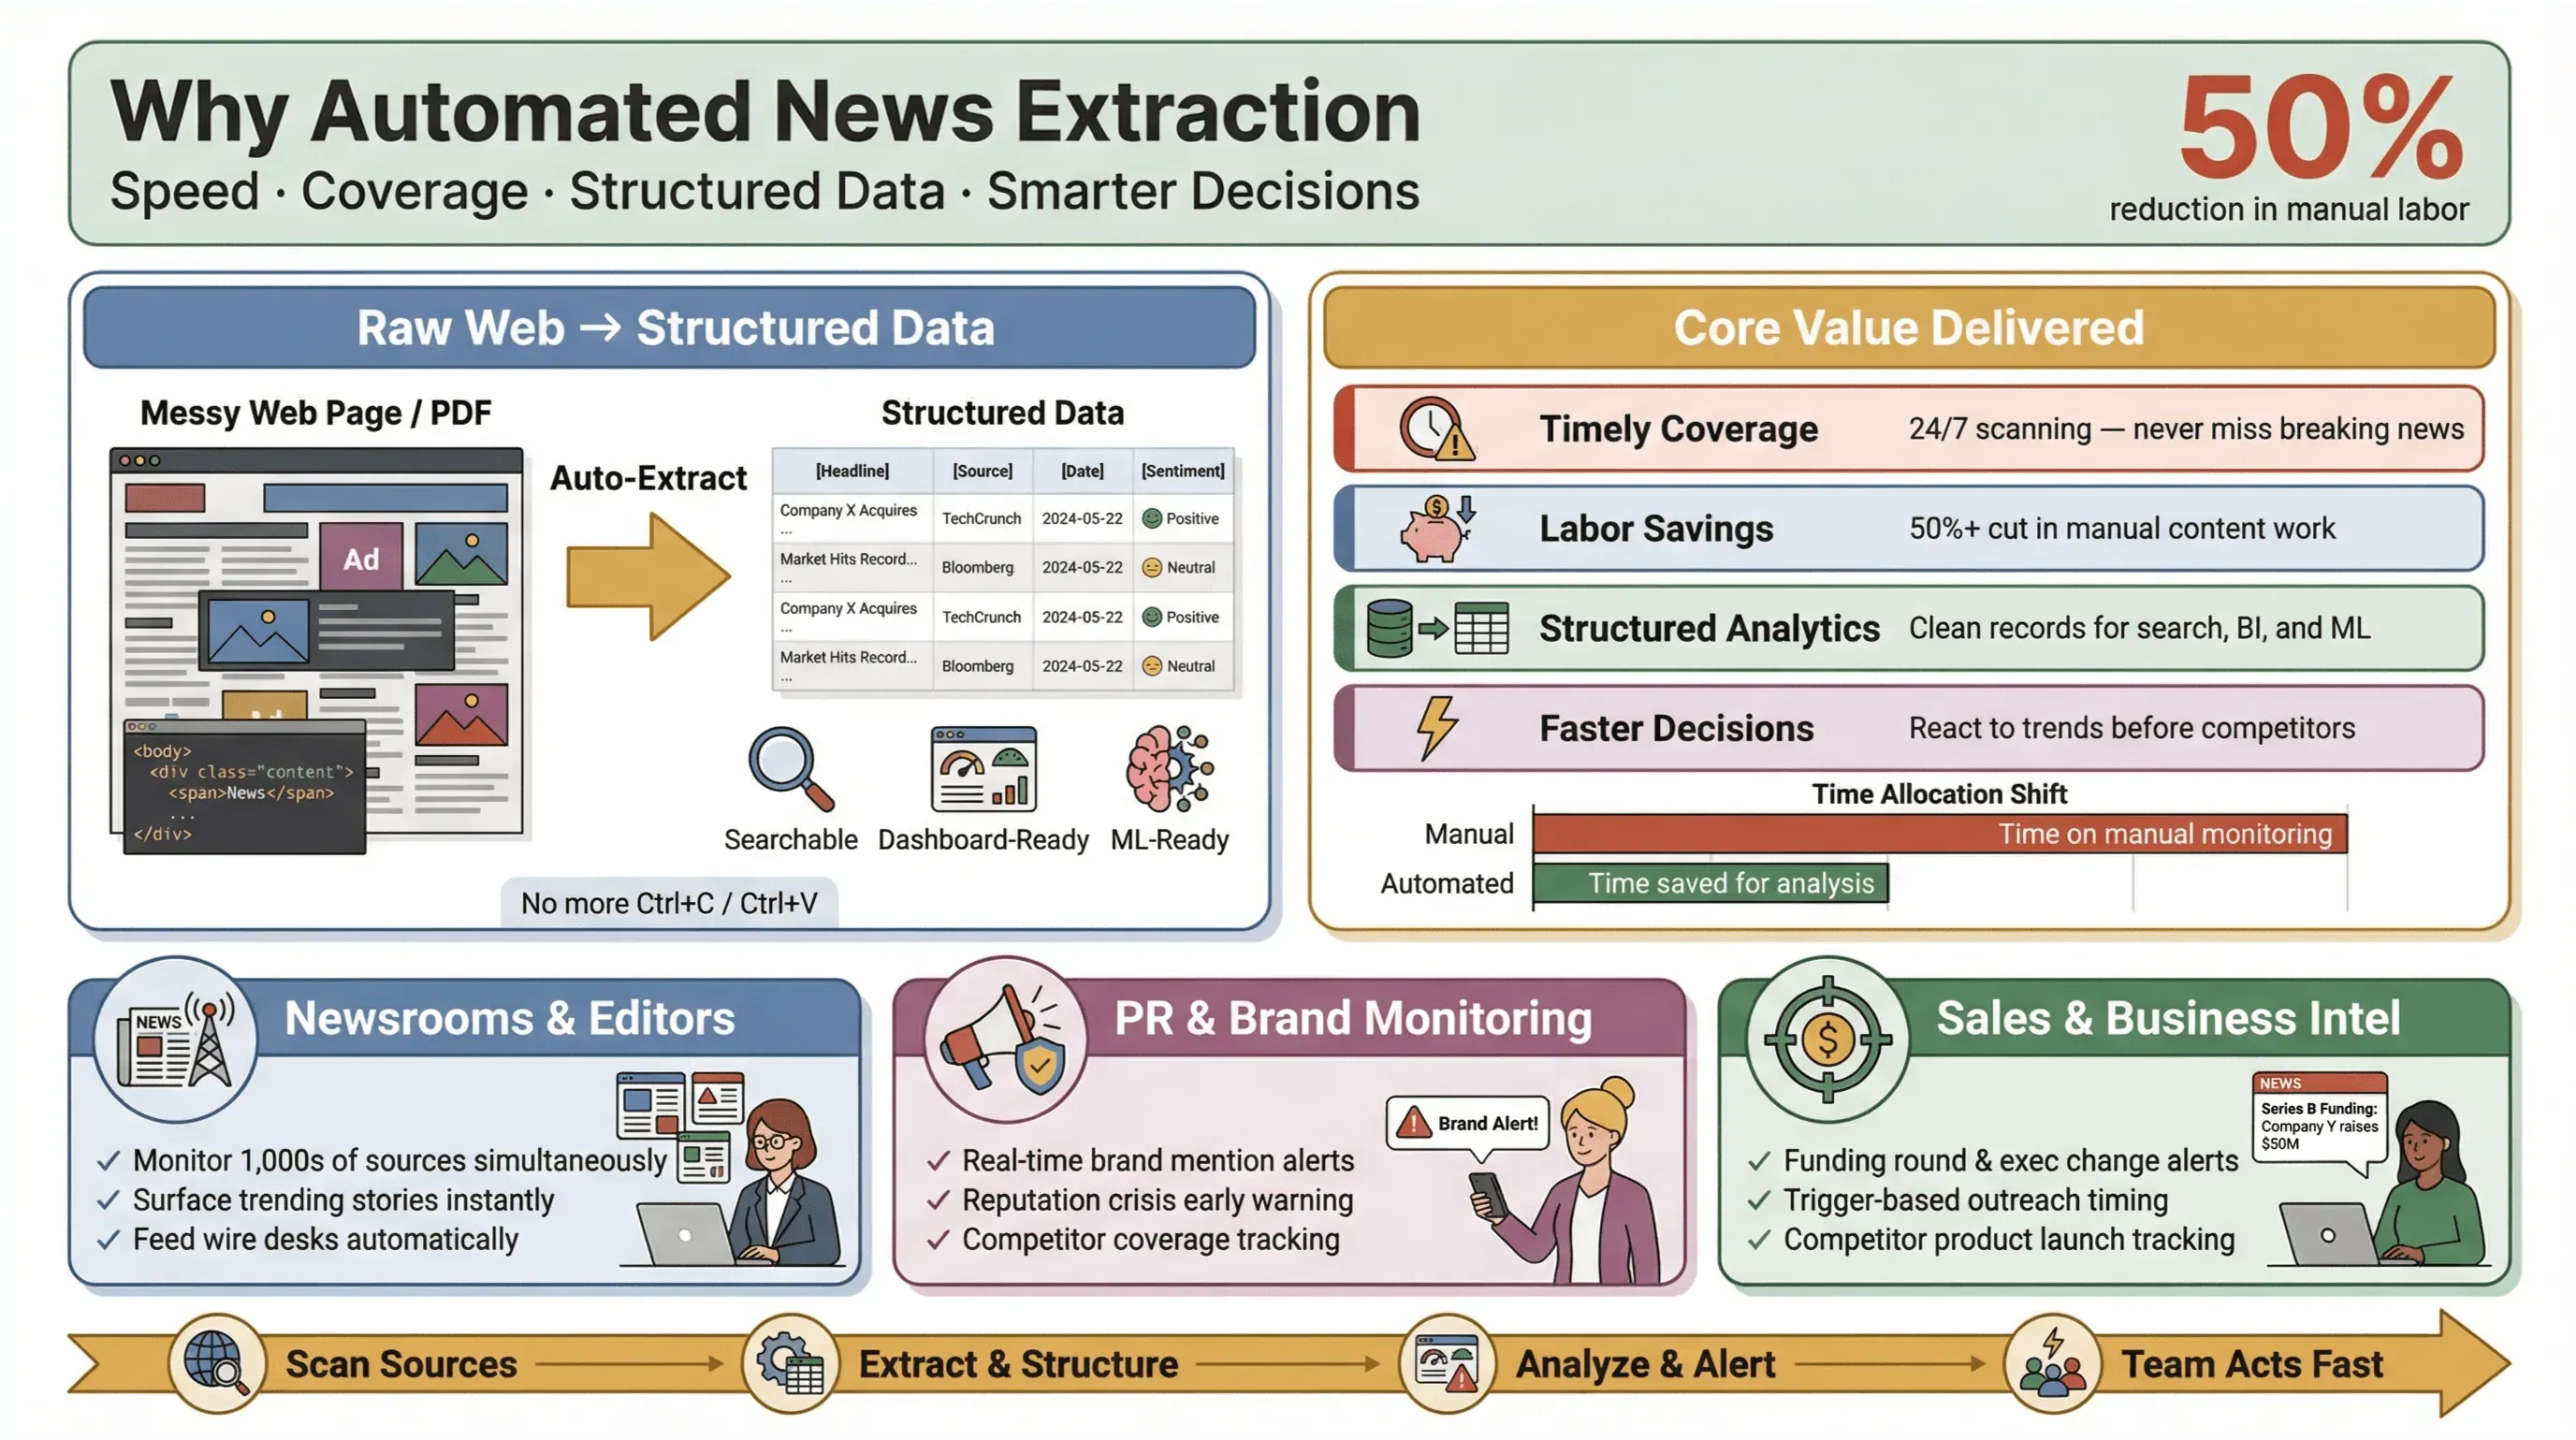
Automatizovaná extrakce zpráv je přesně to, co si pod tím představíte: použití softwaru k automatickému sběru zpravodajského obsahu a jeho převodu do strukturovaných, snadno vyhledávatelných dat — tedy řádků a sloupců místo nepřehledných webových stránek nebo PDF. V praxi to znamená, že můžete sledovat stovky nebo tisíce zdrojů, vytahovat klíčová pole jako titulek, čas publikace, autor a text článku a posílat tato data do dashboardů, alertů nebo navazujících analytických nástrojů — bez jediného Ctrl+C/Ctrl+V.
 Proč je to důležité? Protože v dnešní zpravodajské krajině je rychlost všechno. Ať už jste editor v redakci, PR manažer hlídající zmínky o značce, nebo business analytik sledující kroky konkurence, kdo se dozví první, ten často získá výhodu. Automatizované nástroje umožní i menším týmům fungovat nadstandardně — sbírat aktuální zpravodajská data z webu, snížit ruční zátěž a vytahovat příběhy, které jsou opravdu podstatné.
A dopad je měřitelný: studie ukazují, že automatizace může snížit manuální práci spojenou s aktualizací obsahu o alespoň 50 %, čímž se uvolní čas na skutečnou analýzu a rozhodování.
Hlavní přínos automatizované extrakce zpráv pro zpravodajský průmysl
Pojďme konkrétněji. Co automatizovaná extrakce zpráv přináší redakcím a business týmům?
- Včasné a široké pokrytí: Už žádné propásnuté breaking news jen proto, že se někdo zapomněl podívat do feedu. Automatizované nástroje sledují zdroje 24/7, takže vám nic neuteče.
- Úspora práce i nákladů: Malé a střední týmy mohou monitorovat tolik zdrojů jako velcí hráči — bez armády stážistů.
- Strukturovaná data pro analytiku: Místo procházení nestrukturovaných článků dostanete čisté záznamy připravené pro vyhledávání, dashboardy a strojové učení.
- Rychlejší a chytřejší rozhodování: Aktuální zprávy znamenají, že můžete reagovat na změny trhu, PR krize nebo nové trendy dřív než konkurence.
Vezměme si PR a komunikaci: platformy jako Cision a Meltwater staví monitoring médií v reálném čase jako klíčový nástroj pro ochranu reputace a rychlou reakci na škodlivé pokrytí. V prodeji se zpravodajské alerty v reálném čase mění v „context cards“ pro prospecting — třeba při kola financování, změnách ve vedení nebo produktových uvedeních, které přesně načasují oslovení.
Jak vybrat správné nástroje pro scraping zpráv podle scénáře
Ne všechny nástroje pro scraping zpráv jsou stejné. Správná volba závisí na vašich cílech, technických znalostech i na tom, jaký typ zpráv potřebujete sledovat. Tady je rámec, který vám pomůže vybrat vhodný nástroj:
- Vyhodnocení jednoduchosti použití a dostupnosti
- Bezpečnost a ochrana dat
- Přiřazení nástrojů ke konkrétním typům zpráv a potřebám odvětví
Vyhodnocení jednoduchosti použití a dostupnosti
Pro většinu firemních uživatelů a novinářů je jednoduchost použití naprosto zásadní. Chcete nástroj, který funguje hned po vybalení, bez programování a složité konfigurace. No-code a low-code platformy jako Thunderbit, Octoparse a ParseHub vám umožní vytvářet scrapery vizuálně — prostě ukázat, kliknout a vytáhnout data.
Thunderbit vyniká zejména svým flow na jedno kliknutí: kliknete na One Click Extract a AI si stránku přečte, určí pole a data stáhne. I netechnický uživatel tak zvládne postavit datový kanál pro zprávy za minuty, ne hodiny.
Bezpečnost a ochrana dat
S velkými daty přichází velká zodpovědnost. Nástroje pro scraping zpráv často pracují s citlivým obsahem, proto by bezpečnost a compliance měly být na prvním místě. Hledejte:
- Šifrování dat (při přenosu i v klidu)
- Jasné zásady ochrany soukromí (Thunderbit například uvádí, že neprodává uživatelská data a přistupuje pouze k obsahu, který se rozhodnete scrapovat)
- Detailní oprávnění (zejména u rozšíření do prohlížeče — vždy si ověřte, k čemu má nástroj přístup)
- Soulad s místní legislativou (GDPR, CCPA a pro uživatele v EU také směrnice DSM o autorském právu)
Pro jistotu vybírejte důvěryhodné dodavatele, ověřujte oprávnění rozšíření a omezte přístup jen na to, co je opravdu nezbytné.
Přiřazení nástrojů ke konkrétním typům zpráv a potřebám odvětví
Některé nástroje jsou silnější v konkrétních zpravodajských oblastech:
- Finance: API jako News API a AYLIEN nabízejí klastrování, analýzu sentimentu a detekci událostí pro finanční zprávy.
- Technologie a startupy: Vlastní scraping pomocí Thunderbit nebo Octoparse vám umožní cílit na specializované blogy, tiskové zprávy nebo seznamy akcí.
- Politika a veřejná správa: Licencované databáze jako Factiva a LexisNexis poskytují přístup k prémiovým zdrojům i archivům.
Pokud potřebujete sledovat mix hlavních médií, specializovaných webů a mezinárodních zdrojů — včetně těch bez API — jsou flexibilní AI nástroje pro scraping, jako je Thunderbit, nejlepší volbou.
Jedinečné výhody Thunderbit pro extrakci aktuálních zpravodajských dat
Sbírejte data z aktuálních zpráv s Thunderbit AI si přečte stránku a určí pole sama — bez ruční údržby selektorů, když vydavatel změní design. Get Started Free
Teď se podívejme na to, proč je Thunderbit tak silnou volbou pro automatizovanou extrakci zpráv — zvlášť pokud chcete aktuální zpravodajská data bez technických komplikací.
Thunderbit je AI poháněné rozšíření pro web scraping do Chromu, určené pro firemní uživatele, novináře a analytiky, kteří potřebují z různých webů získávat aktuální a strukturovaný zpravodajský obsah. Tady je důvod, proč se stal mým hlavním nástrojem:
- One Click Extract: Thunderbit přečte zpravodajskou stránku a sám určí nejlepší sloupce k extrakci — titulek, čas publikace, autor, shrnutí a další. Není potřeba ladit selektory ani šablony.
- Scraping podstránek: Potřebujete celý článek, ne jen titulek? Thunderbit navštíví každý odkaz na zprávu, vytáhne celý text, entity i tagy a spojí vše do jedné strukturované tabulky.
- Hromadný export a okamžité aktualizace: Zpravodajská data můžete jedním kliknutím exportovat do Excelu, Google Sheets, Airtable nebo Notion. Žádné dlouhé kopírování ani boj s CSV.
- Naplánovaný scraping: Nastavte opakované úlohy (každou hodinu, denně nebo v jiných intervalech), aby byl váš zpravodajský kanál stále čerstvý — ideální pro breaking news, monitoring trhu nebo průběžný výzkum.
- Přizpůsobivost: AI v Thunderbit se přizpůsobuje změnám rozložení i méně známým zpravodajským webům, takže trávíte méně času opravami rozbitých scraperů a více času analýzou dat.
S 100 000+ uživateli v Chrome Web Store používají Thunderbit PR týmy, sales research i analytici, kteří potřebují zpravodajská data bez toho, aby museli scrapera hlídat každou chvíli.
Detekce polí pomocí AI a scraping podstránek
Jednou z nejsilnějších funkcí Thunderbit je detekce polí řízená AI. Stačí kliknout na „One Click Extract“ a nástroj projde zpravodajskou stránku — identifikuje klíčová pole jako titulek, datum, autor a shrnutí. Můžete si přidat nebo upravit vlastní pole (například „označ tento článek jako earnings, pokud zmiňuje kvartální výsledky“) a zbytek zařídí AI Thunderbit.
Scraping podstránek je pro zprávy zásadní změna. Můžete vytáhnout titulky z homepage nebo sekčního přehledu a poté nechat Thunderbit navštívit každou URL článku, aby získal plný text, entity a dokonce i obrázky. Výsledkem jsou kompletní a obohacené záznamy o zprávách připravené pro vyhledávání, dashboardy nebo navazující AI analýzu.
Hromadný export a okamžité aktualizace
Thunderbit dělá export zpravodajských dat bezbolestný. Jedním kliknutím můžete strukturovaný feed poslat do Google Sheets, Airtable, Notion nebo stáhnout jako CSV/Excel. Pro týmy, které žijí v tabulkách nebo BI nástroji, je to obrovská úspora času.
A protože Thunderbit podporuje naplánované scrapování, můžete ho nastavit na každou hodinu, denně nebo podle vlastního harmonogramu — takže vaše data o zprávách budou vždy aktuální. Už žádné čekání na to, až Google Alerts indexuje příběhy se zpožděním o několik dní.
Jak zvládnout provozní výzvy v řešeních pro data o zprávách v reálném čase
I s těmi nejlepšími nástroji přináší extrakce zpráv v reálném čase vlastní výzvy. Tady je, jak řešit ty nejčastější:
Jak řídit latenci a čerstvost dat
- Plánujte scraping podle rychlosti zpravodajství: U breaking news nastavte spuštění každých 15–30 minut (v souladu s aktualizačním cyklem GDELT Project). U pomalejších témat může stačit denní nebo hodinové spouštění.
- Sledujte zpoždění mezi publikací a stažením: Měřte rozdíl mezi okamžikem publikace článku a okamžikem, kdy ho váš systém zachytí. Pokud se zpoždění zvětšuje, zkontrolujte blokování nebo zpomalení.
- Znovu scrapujte kvůli „tichým úpravám“: Zpravodajské články se často po publikaci upravují. Naplánujte druhé stažení po 24 hodinách, abyste zachytili opravy nebo skryté změny (GDELT to dělá záměrně).
Jak pracovat s limity API a variabilitou zdrojů
- Respektujte kvóty API: Pokud používáte zpravodajská API, hlídejte rate limity — požadavky rozkládejte v čase a výsledky ukládejte do cache, kdykoli je to možné (News API docs).
- Deduplicujte a normalizujte: Zpravodajské příběhy se často objevují na více URL nebo procházejí aktualizacemi. Zachycujte kanonické URL a používejte hashe (např. titulek + datum), abyste se vyhnuli duplicitám (průvodce Google ke kanonizaci).
- Zvládněte dynamický obsah: U webů s nekonečným scrollováním nebo lazy loadingem používejte nástroje, které podporují dynamické renderování, a sledujte změny rozložení (průvodce Octoparse).
Chytrá analýza dat o zprávách: Role AI a strojového učení
Extrakce zpráv je teprve první krok. Skutečná hodnota přichází až ve chvíli, kdy tato data analyzujete a využijete — a právě tady září AI a strojové učení.
- Extrahování entit: Pomocí NLP vytáhněte z článků jména osob, organizací a míst (průvodce Google Cloud).
- Klasifikace témat: Automaticky označujte články podle tématu, sentimentu nebo naléhavosti — a vytvořte tak chytřejší dashboardy i alerty (AYLIEN taxonomy docs).
- Klastrování událostí: Seskupujte duplicitní nebo související příběhy napříč médii, abyste viděli širší obraz, ne jen záplavu skoro stejných titulků.
- Personalizace a cílení: Využijte data o zprávách v reálném čase k segmentaci publika, lepšímu cílení reklam nebo doporučování obsahu — a zvýšte engagement i ROI.
Například PR týmy používají analytiku zpráv v reálném čase k odhalení hrozících krizí ještě předtím, než se stanou virálními, zatímco sales týmy obohacují seznamy prospektů o „trigger events“, jako jsou investiční kola nebo nábor klíčových manažerů.
Checklist nejlepších postupů pro automatizovanou extrakci zpráv
Tady je rychlý přehled, podle kterého udržíte svůj pipeline pro extrakci zpráv v dobré kondici:
| Nejlepší postup | Proč je důležitý | Jak ho zavést |
|---|---|---|
| Plánujte časté scrapeování | Minimalizuje zpoždění dat, zachytí breaking news | Přizpůsobte frekvenci rychlosti zpravodajství (např. každých 15 min u rychlých témat) |
| Používejte AI řízenou extrakci | Přizpůsobí se změnám layoutu, zkrátí nastavení | Nástroje jako Thunderbit, Diffbot, Zyte API |
| Deduplicujte a normalizujte | Zabrání duplicitním alertům, zajistí čistá data | Zachycujte kanonické URL, používejte hashe pro deduplikaci |
| Sledujte kvalitu extrakce | Odhalí chybějící pole, drift nebo selhání | Sledujte % kompletních záznamů, zpoždění a chybovost |
| Respektujte právní a compliance hranice | Vyhnete se právním rizikům, udržíte důvěru | Preferujte oficiální API/feed, kontrolujte podmínky, minimalizujte osobní údaje |
| Exportujte do strukturovaných formátů | Umožní navazující analytiku | CSV, Excel, Sheets, Notion, Airtable |
| Plánujte opětovné scrapeování kvůli úpravám | Zachytí změny po publikaci | Vracejte se k článkům po 24 h / 1 týdnu (model GDELT) |
| Zabezpečte svůj pipeline | Chraňte citlivá data | Šifrování, řízení přístupu, důvěryhodné nástroje |
Jak postavit robustní workflow pro automatizovanou extrakci zpráv
Jste připraveni vybudovat si vlastní „black box“ pro data ze zpráv? Tady je postup krok za krokem:
- Identifikujte zdroje: Seznamte zpravodajské weby, blogy nebo API, která chcete sledovat.
- Nastavte extrakci: Pomocí Thunderbit nebo jiného nástroje definujte pole (One Click Extract to výrazně usnadní).
- Naplánujte scraping: Nastavte frekvenci podle rychlosti zpravodajství — u breaking news po hodině, u pomalejších témat denně.
- Obohaťte podstránky: U každého titulku stáhněte celý článek včetně textu, entit a tagů.
- Deduplicujte a normalizujte: Zachycujte kanonické URL, hashujte záznamy a sjednocujte pole.
- Exportujte a propojte: Strukturovaná data posílejte do Excelu, Google Sheets, Airtable nebo Notion k analýze.
- Monitorujte a upravujte: Sledujte kvalitu extrakce, změny layoutu a podle potřeby dolaďujte.
- Dodržujte compliance: Kontrolujte podmínky použití, respektujte robots.txt a minimalizujte osobní údaje.
Pro vizuální představu si workflow můžete představit takto:
Zdroje → Extrakce (AI pole) → Obohacení podstránek → Deduplikace → Export → Analýza/alerty → Monitoring
Závěr a klíčové poznatky
Proměňte libovolnou zpravodajskou stránku v tabulku Start zdarma, bez nutnosti karty. Email, Phone Number a Image Extractors jsou součástí každého plánu. Get Started Free
Automatizovaná extrakce zpráv už dávno není jen „hezké plus“ — je to nutnost pro každého, kdo chce držet krok ve světě, kde se zprávy objevují a mění každou minutu. Když se budete držet osvědčených postupů a použijete správné nástroje, můžete proměnit datový požární hydrant digitálních zpráv v plynulý tok strukturované, využitelné inteligence.
Klíčové poznatky:
- Měřítko a rychlost online zpráv vyžadují automatizaci — ruční monitoring jednoduše nestačí.
- Nástroje pro automatizovanou extrakci zpráv šetří čas, snižují náklady a umožňují malým týmům držet krok s mnohem většími organizacemi.
- Výběr správného nástroje znamená balancovat mezi jednoduchostí použití, bezpečností a přizpůsobivostí — Thunderbit vyniká díky AI jednoduchosti a možnostem okamžitého exportu.
- Workflow stavte kolem čerstvosti dat, deduplikace, souladu s pravidly a monitoringu kvality, aby byla data spolehlivá a použitelná.
- AI a strojové učení odemykají ještě vyšší hodnotu — umožňují chytřejší cílení, personalizaci a rozhodování.
Pokud stále kopírujete titulky ručně nebo čekáte, až Google Alerts pošle příběhy se zpožděním o den, stojí za to vyzkoušet automatizovaný workflow. Nainstalujte si zdarma rozšíření do Chromu, nasměrujte ho na tři nebo čtyři zdroje, které každé ráno kontrolujete, a zjistěte, zda vám strukturovaný export skutečně ušetří čas. Další tipy, workflow a hlubší analýzy najdete na blogu Thunderbit.
Scrapeujte zpravodajské weby s Thunderbit Nastavte plán a nechte ho hlídat zdroje, které vás zajímají. Exporty míří přímo do Sheets, Excelu, Airtable nebo Notion. Get Started Free
Často kladené otázky
1. Co je automatizovaná extrakce zpráv a jak funguje?
Automatizovaná extrakce zpráv je proces, při kterém software sbírá zpravodajské články a převádí je na strukturovaná data (například tabulky nebo JSON) pro analýzu, vyhledávání nebo alerty. Nástroje jako Thunderbit využívají AI k tomu, aby identifikovaly klíčová pole (titulek, čas publikace, autor, text článku) a automaticky je vytáhly z webových stránek nebo API.
2. Proč jsou data o zprávách v reálném čase pro firmy tak důležitá?
Data o zprávách v reálném čase umožňují firmám rychle reagovat na dění na trhu, PR krize nebo kroky konkurence. Ať už pracujete v prodeji, PR nebo výzkumu, aktuální zprávy vám pomohou dělat chytřejší a rychlejší rozhodnutí a zůstat napřed před konkurencí.
3. Jak Thunderbit usnadňuje scraping zpráv pro netechnické uživatele?
Thunderbit nabízí jednoduchý flow na jedno kliknutí: kliknete na One Click Extract a AI sama určí, co je potřeba stáhnout. Díky funkcím jako scraping podstránek a okamžitý export do Excelu nebo Google Sheets si i netechnický uživatel vytvoří robustní datový kanál pro zprávy během několika minut.
4. Jaké jsou právní a compliance aspekty scrapování zpráv?
Vždy si zkontrolujte podmínky použití cílových webů, pokud je to možné, upřednostněte oficiální API nebo feedy a respektujte pravidla v robots.txt. Nescrapujte obsah za přihlašovací bránou nebo za paywallem bez povolení a minimalizujte sběr osobních údajů, abyste zůstali v souladu s předpisy o ochraně soukromí.
5. Jak zajistím, aby byl můj workflow pro extrakci zpráv dlouhodobě spolehlivý?
Plánujte pravidelné scrapeování, sledujte kvalitu extrakce a používejte nástroje, které se přizpůsobují změnám layoutu (jako AI řízená extrakce v Thunderbit). Deduplikujte záznamy, sledujte zpoždění mezi publikací a stažením a nastavte alerty na selhání nebo chybějící pole, aby váš pipeline zůstal zdravý a aktuální.
Vyzkoušejte Thunderbit AI Web Scraper Get Started Free
Zjistit více
- 10 automatizovaných nástrojů pro web scraping, které ušetřily mému týmu hodiny práce (2026)
- Top 5 nejlepších softwarů pro scraping webových dat v roce 2026
- 15 nejlepších nástrojů pro extrakci dat v roce 2026: konečný shortlist pro každý tým
- Nejlepší scrapery článků v roce 2026: praktické srovnání
- Jak zvládnout automatizovaný scraping dat pomocí Thunderbit




