
Webových dat rychle přibývá a tlak držet s nimi krok je čím dál větší. Na vlastní oči jsem viděl, jak obchodní a provozní týmy tráví víc času luštěním tabulek a kopírováním z webů než skutečným rozhodováním. Podle Salesforce dnes obchodní zástupci stráví až 70 % času neprodejními činnostmi a Asana uvádí, že 60 % práce je jen „práce kolem práce“. To je spousta hodin ztracených ručním sběrem dat — hodin, které by šly využít na uzavírání obchodů nebo rozjíždění kampaní.
Dobrá zpráva je, že web scraping se už dostal do běžné praxe a jeho sílu dnes zvládnou využít i lidé bez vývojářského backgroundu. Ruby je už dlouho oblíbenou volbou pro automatizaci extrakce webových dat, ale když ho spojíte s moderními AI nástroji, jako je Thunderbit, získáte to nejlepší z obou světů — flexibilitu pro programátory a jednoduchost bez kódu pro všechny ostatní. Ať už jsi marketér, manažer e-shopu, nebo prostě někdo, koho už nebaví nekonečné kopírování, tenhle průvodce ti ukáže, jak zvládnout web scraping v Ruby a s AI — bez nutnosti psát kód.
Vyzkoušet Thunderbit pro web scraping bez kódu
Co je web scraping v Ruby? Vaše brána k automatizovanému sběru dat
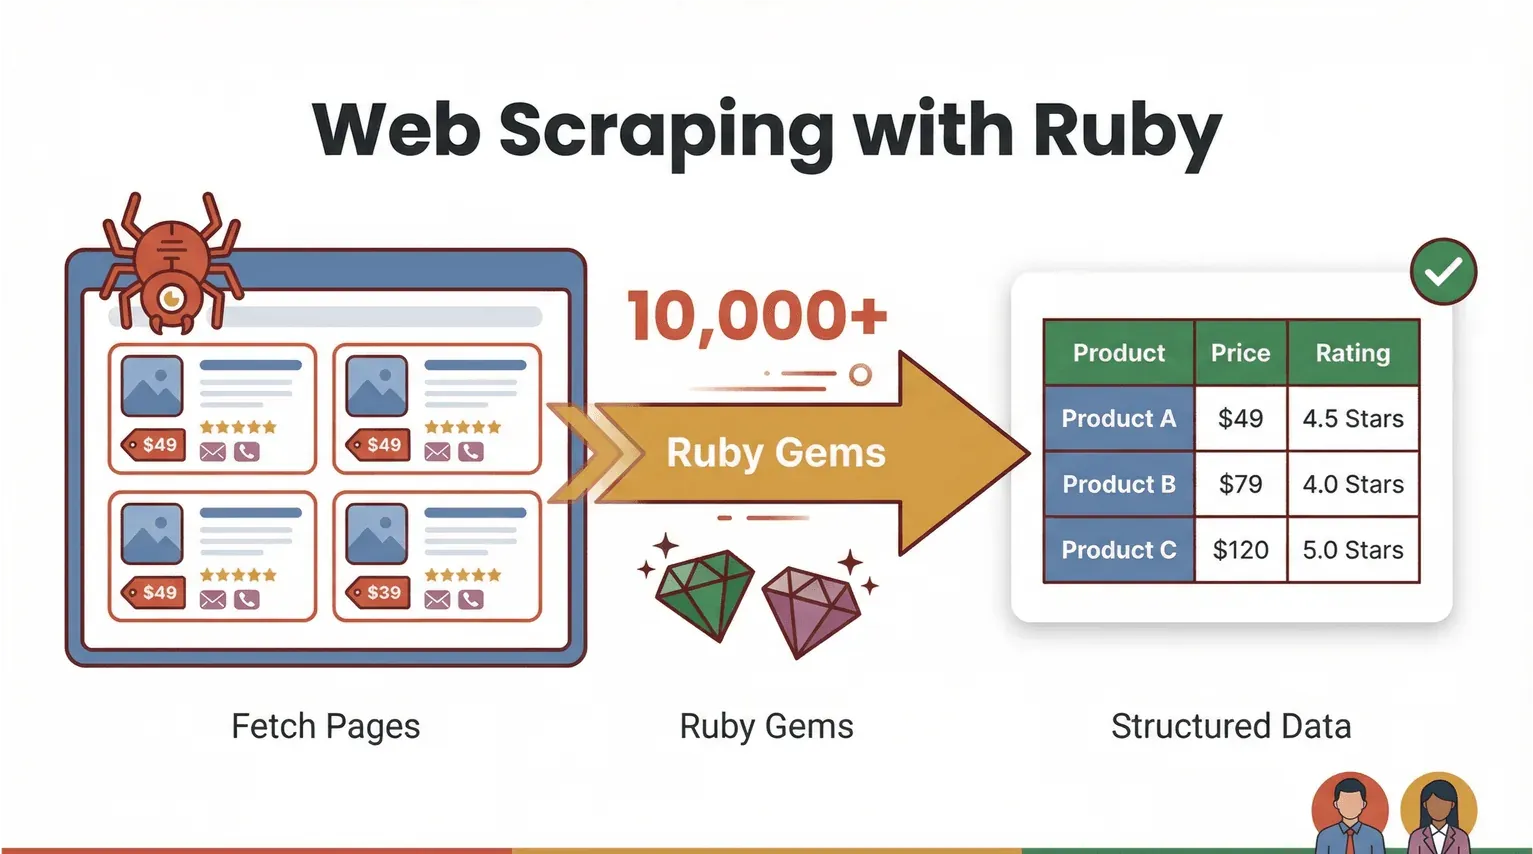
Začněme od základů. Web scraping je jednoduše proces, při kterém software načte webové stránky a vytáhne z nich konkrétní informace — třeba ceny produktů, kontaktní údaje nebo recenze — do strukturované podoby, například CSV nebo Excelu. S Ruby je web scraping výkonný a zároveň přístupný. Jazyk je známý svou čitelnou syntaxí a obrovským ekosystémem „gemů“ (knihoven), díky nimž je automatizace velmi snadná (Ruby Programming Language).
Jak tedy vypadá „web scraping v Ruby“ v praxi? Představ si, že chceš získat názvy a ceny všech produktů z e-shopu. V Ruby můžeš napsat skript, který:
- stáhne webovou stránku (pomocí knihovny jako HTTParty),
- z HTML vytáhne potřebná data (Nokogiri),
- exportuje je do tabulky nebo databáze.
A tady to začíná být zajímavé: ne vždy je nutné psát kód. AI nástroje pro web scraping bez kódu, jako je Thunderbit, dnes zvládnou těžkou práci za tebe — přečtou stránku, rozpoznají pole a vyexportují čistá data jen na pár kliknutí. Ruby zůstává skvělým „lepidlem“ pro vlastní automatizované workflow, ale AI web scrapery otevírají dveře i běžným firemním uživatelům.
Co je data scraping? Get Started Free
Proč je web scraping v Ruby důležitý pro firemní týmy
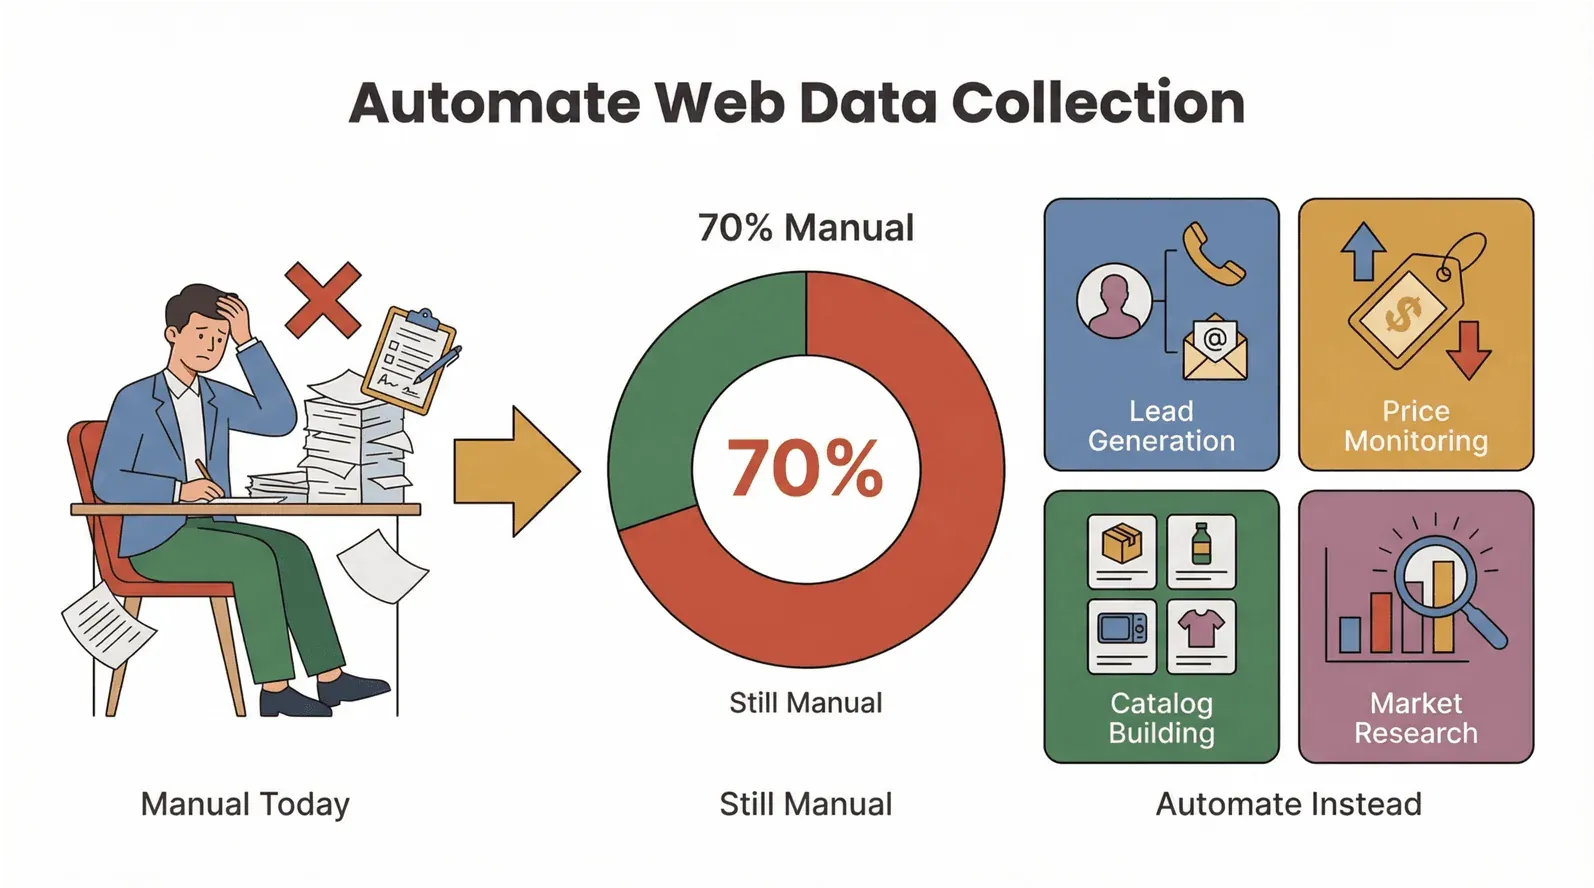
Buďme upřímní: nikdo nechce trávit celý den ručním kopírováním a vkládáním dat. Poptávka po automatizovaném sběru webových dat prudce roste — a má to svůj důvod. Takhle web scraping v Ruby (a s AI nástroji) mění fungování firem:
- Generování leadů: Okamžitě vytáhneš kontaktní údaje z adresářů nebo LinkedInu pro svůj obchodní pipeline.
- Sledování cen konkurence: Hlídáš změny cen u stovek e-shopových SKU — bez ručních kontrol.
- Tvorba produktového katalogu: Shromáždíš detaily produktů a obrázky pro vlastní obchod nebo marketplace.
- Průzkum trhu: Sbíráš recenze, hodnocení nebo zprávy pro analýzu trendů.
Návratnost je zřejmá: týmy, které sběr webových dat automatizují, ušetří hodiny týdně, sníží chybovost a pracují s čerstvějšími a spolehlivějšími daty. Ve výrobě například 70 % firem stále sbírá data ručně, přestože objem dat se za pouhé dva roky zdvojnásobil. To je obrovská příležitost pro automatizaci.
Tady je stručný přehled, jak web scraping v Ruby a s AI nástroji přináší hodnotu:
| Případ použití | Bolest při ruční práci | Přínos automatizace | Typický výsledek |
|---|---|---|---|
| Generování leadů | Kopírování e-mailů jeden po druhém | Stažení tisíců kontaktů během minut | 10× více leadů, méně rutiny |
| Sledování cen | Každodenní kontrola webů | Plně automatizované a plánované tahy | Ceny v reálném čase |
| Tvorba katalogu | Ruční zadávání dat | Hromadná extrakce a formátování | Rychlejší spuštění, méně chyb |
| Průzkum trhu | Ruční čtení recenzí | Sběr a analýza ve velkém | Hlubší a čerstvější poznatky |
A nejde jen o rychlost — automatizace znamená méně chyb a konzistentnější data, což je zásadní, když 58 % lídrů říká, že jejich rozhodování stojí na nepřesných nebo nekonzistentních datech.
Přehled řešení pro web scraping: Ruby skripty vs. AI web scraper nástroje
Takže: napsat si vlastní Ruby skript, nebo sáhnout po AI nástroji bez kódu? Pojďme si možnosti rozebrat.
Ruby skriptování: plná kontrola, vyšší nároky na údržbu
Ruby má bohatý ekosystém gemů pro prakticky každý scrapingový scénář:
- Nokogiri: standard pro parsování HTML a XML.
- HTTParty: pro stahování stránek a práci s API.
- Mechanize: pro weby, které vyžadují cookies, formuláře a navigaci.
- Selenium / Watir: pro automatizaci skutečných prohlížečů (ideální pro weby s JavaScriptem).
Se skripty v Ruby získáš maximální flexibilitu — vlastní logiku, čištění dat i napojení na interní systémy. Současně ale přebíráš i údržbu: když web změní rozložení, skript se může rozbít. A pokud ti kód není blízký, čeká tě delší učební křivka.
AI web scrapery a nástroje bez kódu: rychlé, jednoduché a adaptivní
Moderní nástroje bez kódu, jako je Thunderbit, obracejí situaci naruby. Místo psaní kódu:
- otevřeš rozšíření v Chromu,
- klikneš na „AI Suggest Fields“ a necháš AI, aby navrhla, co extrahovat,
- stiskneš „Scrape“ a exportuješ data.
Thunderbit s pomocí AI zvládá měnící se rozložení stránek, pracuje i s podstránkami (například detaily produktů) a exportuje přímo do Excelu, Google Sheets, Airtable nebo Notion. Je ideální pro firemní uživatele, kteří chtějí výsledky bez zbytečné námahy.
Tady je přímé srovnání:
| Přístup | Výhody | Nevýhody | Vhodné pro |
|---|---|---|---|
| Ruby skriptování | Plná kontrola, vlastní logika, flexibilita | Strmější učební křivka, údržba | Vývojáři, pokročilí uživatelé |
| AI Web Scraper | Bez kódu, rychlé nasazení, přizpůsobení změnám | Menší granularita řízení, určitá omezení | Firemní uživatele, ops týmy |
Trend je jasný: weby jsou čím dál složitější a zároveň víc chráněné, takže AI web scrapery se pro většinu firemních workflow stávají první volbou.
Začínáme: jak nastavit prostředí pro web scraping v Ruby
Pokud chceš vyzkoušet Ruby skriptování, pojďme nastavit prostředí. Dobrá zpráva? Ruby se snadno instaluje a funguje na Windows, macOS i Linuxu.
Krok 1: Nainstalujte Ruby
- Windows: stáhněte RubyInstaller a postupujte podle pokynů. Nezapomeňte přidat MSYS2 pro kompilaci nativních rozšíření (nutné například pro Nokogiri).
- macOS/Linux: použijte rbenv pro správu verzí. V Terminálu:
brew install rbenv ruby-build
rbenv install 4.0.4
rbenv global 4.0.4
(Pro nejnovější stabilní verzi se podívejte na stránku Ruby downloads.)
Krok 2: Nainstalujte Bundler a základní gem balíčky
Bundler pomáhá spravovat závislosti:
gem install bundler
Pro projekt vytvořte soubor Gemfile:
source 'https://rubygems.org'
gem 'nokogiri'
gem 'httparty'
Pak spusťte:
bundle install
Tím zajistíte, že bude prostředí konzistentní a připravené na scraping.
Krok 3: Otestujte nastavení
Zkuste toto v IRB (interaktivní shell Ruby):
require 'nokogiri'
require 'httparty'
puts Nokogiri::VERSION
Pokud se zobrazí číslo verze, je vše v pořádku.
Krok za krokem: vytvoření prvního web scrapera v Ruby
Podíváme se na reálný příklad — scrapování produktových dat z Books to Scrape, webu určeného pro nácvik scrapingu.
Tady je jednoduchý Ruby skript pro získání názvů knih, cen a dostupnosti:
require "net/http"
require "uri"
require "nokogiri"
require "csv"

BASE_URL = "https://books.toscrape.com/"

def fetch_html(url)
  uri = URI.parse(url)
  res = Net::HTTP.get_response(uri)
  raise "HTTP #{res.code} for #{url}" unless res.is_a?(Net::HTTPSuccess)
  res.body
end

def scrape_list_page(list_url)
  html = fetch_html(list_url)
  doc  = Nokogiri::HTML(html)
  products = doc.css("article.product_pod").map do |pod|
    title = pod.css("h3 a").first["title"]
    price = pod.css(".price_color").text.strip
    stock = pod.css(".availability").text.strip.gsub(/\s+/, " ")
    { title: title, price: price, stock: stock }
  end
  next_rel = doc.css("li.next a").first&.[]("href")
  next_url = next_rel ? URI.join(list_url, next_rel).to_s : nil
  [products, next_url]
end

rows = []
url  = "#{BASE_URL}catalogue/page-1.html"
while url
  products, url = scrape_list_page(url)
  rows.concat(products)
end

CSV.open("books.csv", "w", write_headers: true, headers: %w[title price stock]) do |csv|
  rows.each { |r| csv << [r[:title], r[:price], r[:stock]] }
end

puts "Wrote #{rows.length} rows to books.csv"
Tenhle skript stáhne každou stránku, zpracuje HTML, vytáhne data a uloží je do CSV souboru. books.csv pak otevřeš v Excelu nebo Google Sheets.
Časté problémy:
- Pokud se objeví chyba kvůli chybějícím gemům, zkontrolujte
Gemfilea spusťtebundle install. - U webů, které načítají data přes JavaScript, budete potřebovat nástroj pro automatizaci prohlížeče, jako je Selenium nebo Watir.
Zrychlení Ruby scrapingu s Thunderbit: AI web scraper v praxi
Teď se podíváme, jak Thunderbit dokáže posunout scraping na vyšší úroveň — bez psaní kódu.
Thunderbit je AI web scraper rozšíření pro Chrome, které ti umožní vytáhnout strukturovaná data z jakéhokoli webu během dvou kliknutí. Funguje to takto:
- Otevřeš rozšíření Thunderbit na stránce, kterou chceš scrapovat.
- Klikneš na „AI Suggest Fields“. AI projde stránku a navrhne nejlepší sloupce k extrakci (například „Název produktu“, „Cena“, „Skladová dostupnost“).
- Klikneš na „Scrape“. Thunderbit získá data, zvládne stránkování a v případě potřeby projde i podstránky.
- Exportuješ data přímo do Excelu, Google Sheets, Airtable nebo Notion.
To, čím je Thunderbit výjimečný, je schopnost pracovat i s komplexními a dynamickými webovými stránkami — bez křehkých selektorů a bez kódu. A pokud chceš workflow propojit, můžeš Thunderbit použít k získání dat a následně je dál zpracovat nebo obohatit v Ruby skriptu.
Tip z praxe: scrapování podstránek v Thunderbitu je záchrana pro e-commerce a realitní týmy. Nejprve vytáhneš seznam odkazů na produkty a pak Thunderbit necháš navštívit každý z nich, aby získal detailní specifikace, obrázky nebo recenze — automaticky tak obohatí tvůj dataset.
Jak scrapovat jakýkoli web pomocí AI Get Started Free
Praktický příklad: scrapování produktových a cenových dat pro e-commerce s Ruby a Thunderbit
Pojďme to celé spojit do praktického workflow pro e-commerce týmy.
Scénář: Chceš sledovat ceny konkurence a detaily produktů u stovek SKU.
Krok 1: Použij Thunderbit pro získání hlavního seznamu produktů
- Otevři stránku s produkty konkurence.
- Spusť Thunderbit a klikni na „AI Suggest Fields“ (např. název produktu, cena, URL).
- Klikni na „Scrape“ a výsledky exportuj do CSV.
Krok 2: Obohať data pomocí scrapování podstránek
- V Thunderbitu použij funkci „Scrape Subpages“, která navštíví detail každého produktu a vytáhne další pole (např. popis, skladovost nebo obrázky).
- Exportuj obohacenou tabulku.
Krok 3: Zpracuj nebo analyzuj data v Ruby
- Použij Ruby skript k dalšímu čištění, transformaci nebo analýze dat. Například můžeš:
- převést ceny na jednotnou měnu,
- odfiltrovat zboží, které není skladem,
- vytvořit souhrnné statistiky.
Tady je jednoduchý Ruby úryvek pro filtrování produktů skladem:
require 'csv'

rows = CSV.read('products.csv', headers: true)
in_stock = rows.select { |row| row['stock'].include?('In stock') }

CSV.open('in_stock_products.csv', 'w', write_headers: true, headers: rows.headers) do |csv|
  in_stock.each { |row| csv << row }
end
Výsledek:
Dostaneš se od syrových webových stránek k čisté, použitelné datové tabulce — připravené pro cenovou analýzu, plánování zásob nebo marketingové kampaně. A to vše bez napsání jediného řádku scrapingového kódu.
Bez kódu? Žádný problém: automatizace sběru webových dat pro každého
Jedna z věcí, které na Thunderbitu oceňuji nejvíc, je to, jak dává sílu i netechnickým uživatelům. Nemusíš znát Ruby, HTML ani CSS — stačí otevřít rozšíření, nechat AI pracovat a exportovat data.
Učební křivka: U Ruby skriptů se musíš naučit základy programování a strukturu webu. U Thunderbitu se všechno nastaví během minut, ne dnů.
Integrace: Thunderbit exportuje přímo do nástrojů, které firemní týmy už používají — Excel, Google Sheets, Airtable, Notion. Můžeš si dokonce naplánovat pravidelné scrapování pro průběžný monitoring.
Zpětná vazba uživatelů: Viděl jsem marketingové týmy, sales ops i manažery e-shopů, jak pomocí Thunderbitu automatizují vše od tvorby lead listů po sledování cen — bez nutnosti volat IT.
Nejlepší postupy: propojení Ruby a AI web scraperu pro škálovatelnou automatizaci
Chceš vybudovat robustní a škálovatelný scrapingový workflow? Tady jsou moje hlavní doporučení:
- Počítej se změnami webu: AI web scrapery jako Thunderbit se přizpůsobují automaticky, ale pokud používáš Ruby skripty, připrav se na aktualizaci selektorů při změnách webu.
- Plánuj scrapování: Pro pravidelné sběry dat využij plánování v Thunderbitu. V Ruby si nastav cron job nebo plánovač úloh.
- Zpracování po dávkách: U velkých datasetů rozděluj scraping do menších dávek, aby nedošlo k blokaci nebo přetížení systému.
- Formátování dat: Před analýzou vždy data vyčisti a ověř — exporty z Thunderbitu jsou strukturované, ale vlastní Ruby skripty mohou vyžadovat dodatečné kontroly.
- Soulad s pravidly: Scrapuj jen veřejně dostupná data, respektuj
robots.txta mysli na pravidla ochrany osobních údajů (zejména v EU — GDPR se vztahuje i na scrapovaná osobní data). - Záložní strategie: Pokud je web příliš složitý nebo scraping blokuje, zkus oficiální API nebo jiné zdroje dat.
Kdy použít co?
- Ruby skripty použij, když potřebuješ plnou kontrolu, vlastní logiku nebo napojení na interní systémy.
- Thunderbit použij, když chceš rychlost, jednoduchost a přizpůsobivost — hlavně u jednorázových nebo opakovaných firemních úkolů.
- Pro pokročilé workflow zkombinuj obojí: Thunderbit se postará o extrakci, Ruby o obohacení, kontrolu kvality nebo integraci.
Závěr a hlavní poznatky
Web scraping v Ruby byl vždy silným nástrojem pro automatizaci sběru dat — a s AI scrapery, jako je Thunderbit, je tahle síla dostupná opravdu každému. Ať už jsi vývojář, který chce flexibilitu, nebo firemní uživatel, který chce prostě výsledky, můžeš automatizovat sběr webových dat, ušetřit hodiny ruční práce a dělat lepší rozhodnutí rychleji.
Co si z toho odnést:
- Ruby je skvělý nástroj pro web scraping a automatizaci — zejména s gemy jako Nokogiri a HTTParty.
- AI web scrapery jako Thunderbit zpřístupňují extrakci dat i lidem bez kódu, například díky funkcím jako „AI Suggest Fields“ a scrapování podstránek.
- Kombinace Ruby a Thunderbitu přináší to nejlepší z obou světů: rychlou extrakci bez kódu a zároveň vlastní automatizaci a analýzu.
- Automatizace sběru webových dat je silná strategie pro sales, marketing a e-commerce týmy — snižuje ruční práci, zvyšuje přesnost a otevírá nové poznatky.
Chceš začít? Stáhni si Thunderbit, zkus jednoduchý Ruby skript a podívej se, kolik času můžeš ušetřit. A pokud chceš jít víc do hloubky, mrkni na Thunderbit Blog, kde najdeš další návody, tipy a reálné příklady.
Stáhnout rozšíření Thunderbit pro Chrome
Časté dotazy
1. Potřebuji umět programovat, abych mohl Thunderbit použít pro web scraping?
Ne. Thunderbit je navržený pro netechnické uživatele. Stačí otevřít rozšíření, kliknout na „AI Suggest Fields“ a nechat AI udělat zbytek. Data můžeš exportovat do Excelu, Google Sheets, Airtable nebo Notion — bez kódování.
2. Jaké jsou hlavní výhody použití Ruby pro web scraping?
Ruby nabízí výkonné knihovny jako Nokogiri a HTTParty pro flexibilní a na míru postavené scrapingové workflow. Je skvělý pro vývojáře, kteří chtějí plnou kontrolu, vlastní logiku a integraci s dalšími systémy.
3. Jak funguje funkce Thunderbit „AI Suggest Fields“?
AI v Thunderbitu projde webovou stránku, rozpozná nejrelevantnější datová pole (například názvy produktů, ceny nebo e-maily) a navrhne strukturovanou tabulku. Sloupce si můžeš před scrapováním upravit podle potřeby.
4. Můžu Thunderbit kombinovat se skripty v Ruby pro pokročilé workflow?
Rozhodně. Mnoho týmů používá Thunderbit k extrakci dat (hlavně z komplexních nebo dynamických webů) a Ruby pak na jejich další zpracování nebo analýzu. Tento hybridní přístup je ideální pro vlastní reporting nebo obohacování dat.
5. Je web scraping legální a bezpečný pro firemní použití?
Web scraping je legální, pokud sbíráš veřejně dostupná data a respektuješ podmínky webu i zákony o ochraně osobních údajů. Vždy kontroluj robots.txt a nesbírej osobní data bez odpovídajícího souhlasu — zejména u uživatelů v EU podle GDPR.
Zajímá tě, jak může web scraping proměnit tvůj pracovní postup? Vyzkoušej zdarma Thunderbit nebo si dnes experimentálně spusť Ruby skript. A pokud narazíš na problém, Thunderbit Blog i Thunderbit YouTube Channel jsou plné návodů a tipů, které ti pomohou zvládnout automatizaci webových dat — bez kódu.
Vyzkoušet AI web scraper Thunderbit Get Started Free
Zjistit více



