
Automatizovaný provoz dnes tvoří 53 % webu, tedy víc než lidé, a anti-bot systémy proti tomu bojují tvrději než kdy dřív.
Na vlastní kůži jsem viděl, jak jediná chyba — třeba použití špatného user agenta — dokáže proměnit datový projekt ve stěnu chyb 403. Pro týmy obchodu, e-commerce i provozu znamená zablokování ztracené leady, zastaralé ceny nebo ušlý výnos.
Tady je to, co jsem se o user agentech pro scraping naučil — základní postupy, časté chyby a jak nástroje jako Thunderbit zvládají vše automaticky.

Proč je výběr nejlepšího user agenta pro scraping důležitý
Začněme od základů: co je user agent? Představ si ho jako průkaz totožnosti tvého prohlížeče. Pokaždé, když navštívíš web — ať už jsi člověk, nebo bot — prohlížeč pošle v hlavičkách požadavku řetězec User-Agent. Je to krátké představení ve stylu „Ahoj, jsem Chrome na Windows“ nebo „Jsem Safari na iPhonu“ (ScraperAPI). Takhle obvykle vypadá user agent pro Chrome:
Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36
Weby tyhle informace používají hlavně ze dvou důvodů:
- Aby zobrazily správný obsah (například mobilní vs. desktopové rozložení).
- Aby odhalily boty a scrapery.
Když váš user agent hlásí třeba „python-requests/2.28.1“ nebo „Scrapy/2.9.0“, je to skoro stejné, jako kdybyste si na krk pověsili cedulku „Dobrý den, jsem bot!“. Weby si tyhle nápadné identifikátory dávají na blacklist a zavřou vám dveře dřív, než stačíte říct „403 Forbidden“. Naopak použití běžného, aktuálního browserového user agenta vám pomůže splynout s davem.
Stručně řečeno: user agent je vaše maskování. Čím lepší maskování, tím větší šance, že získáte data, která potřebujete.
Úloha user agenta při úspěchu ve web scrapingu
Proč má výběr user agenta tak velký dopad? Protože je to první obranná linie většiny anti-bot systémů. Co se může pokazit, když ho zvolíte špatně:
- Okamžité blokace (chyby 403/429): Když použijete výchozí user agent z knihovny pro scraping, budete zablokováni dřív, než uvidíte domovskou stránku (Webmasters StackExchange).
- Prázdná nebo falešná data: Některé weby vracejí podezřelým user agentům prázdné nebo „dummy“ stránky.
- CAPTCHA nebo přesměrování: User agent, který vypadá jako bot, spustí výzvy typu „Jste člověk?“ nebo nekonečné smyčky přihlášení.
- Omezování rychlosti a zákazy: Když na web posíláte pořád stejný user agent, můžete být zpomalení nebo dostanete IP ban.
Podívej se, jak dopadají různé user agenty:
| Řetězec user agenta | Výsledek na většině webů (2026) |
|---|---|
python-requests/2.28.1 | Okamžitě zablokován, označen jako bot |
Scrapy/2.9.0 (+https://scrapy.org) | Zablokován nebo obdrží falešný obsah |
Mozilla/5.0 (Windows NT 10.0; Win64; x64)... | Považován za skutečného uživatele, přístup povolen |
AhrefsBot/7.0 (+http://ahrefs.com/robot/) | Zablokován, známý crawler |
| Prázdný nebo nesmyslný UA | Někdy projde, často je podezřelý |
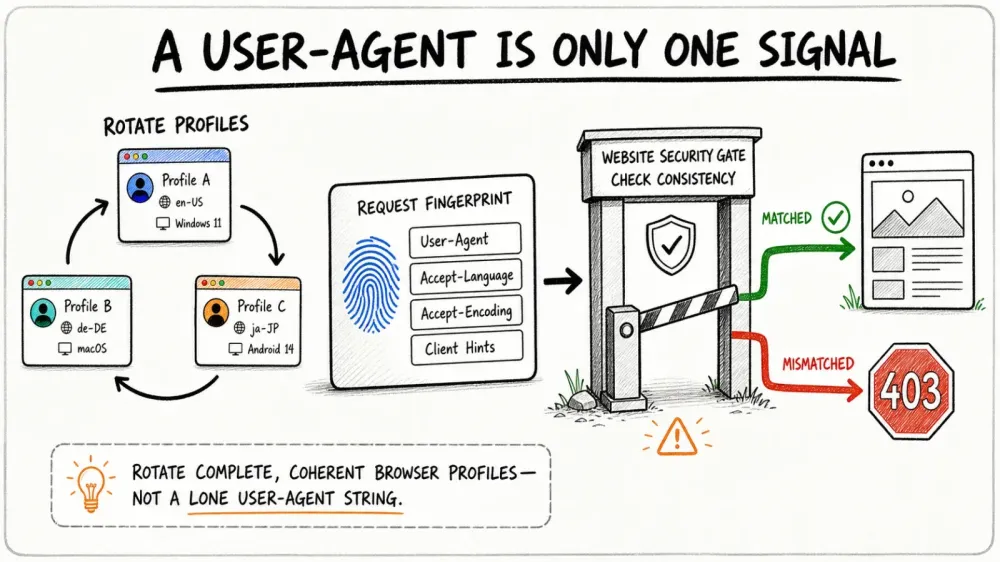
Ponaučení? Vyber maskování rozumně. A nezapomeň — moderní anti-bot systémy se nedívají jen na user agent. Kontrolují i to, jestli ostatní hlavičky požadavku (například Accept-Language nebo Referer) dávají smysl. Když tvrdíte, že jste Chrome, ale neposíláte správné hlavičky, stejně vás odhalí (ScraperAPI).
Scrape data from any website using AI Agentic web scraper Thunderbit sám řeší vykreslování i strukturu stránky, takže user agenty nemusíš spravovat ručně. Get Started Free
A právě tady přichází na řadu Thunderbit. Mluvil jsem s tolika firemními uživateli — obchodníky, e-commerce manažery, realitními makléři — kteří chtějí hlavně data, ne školení o HTTP hlavičkách. Proto jsme Thunderbit navrhli tak, aby správa user agentů byla neviditelná a automatická.
Thunderbit: Zjednodušení správy user agentů pro každého
S jednoklikovým scrapováním v Thunderbit nemusíte user agenta vybírat vůbec. Náš AI engine to udělá za vás a zvolí nejrealističtější a nejaktuálnější podpis prohlížeče pro každý web. Ať už používáte rozšíření Thunderbit pro Chrome (které doslova používá skutečný Chrome UA), nebo cloudové scrapování (kde naše AI rotuje mezi sadou aktuálních browserových UA), vždy splynete s běžným provozem.
A nejde jen o user agent. Thunderbit posílá kompletní a konzistentní sadu hlaviček — Accept-Language, Accept-Encoding, Client Hints a další — takže vaše požadavky vypadají i chovají se jako skutečný prohlížeč. Už žádné nesoulady v hlavičkách, žádné červené vlajky typu „bot“.
To nejlepší? Nemusíte nic nastavovat. AI v Thunderbit řeší všechny technické detaily na pozadí, takže se můžete soustředit na to podstatné: spolehlivá a kvalitní data.
Vyzkoušejte agentic web scraper Thunderbit zdarma Nainstalujte si bezplatné rozšíření pro Chrome a vytáhněte strukturovaná data z jakékoli stránky jedním kliknutím, bez nutnosti falšovat hlavičky. Get Started Free
Proč je dynamická rotace user agentů dnes nutnost
Řekněme, že najdete perfektní user agent. Měli byste ho používat pro každý požadavek? Ani náhodou. V roce 2026 je opakované používání stejného UA jasný signál pro odhalení. Skuteční uživatelé mají různé prohlížeče, verze i zařízení. Když váš scraper trefí web 500krát po sobě se stejným UA, je to jako poslat průvod identických dvojčat — nikoho neoklamete.
Proto je dnes dynamická rotace user agentů standardem. Princip je jednoduchý: pro každý požadavek nebo relaci se střídá sada realistických, aktuálních user agentů. Díky tomu vypadá scraper jako různorodá skupina skutečných návštěvníků, ne jako jeden automatizovaný skript (Capsolver).
AI řízená rotace v Thunderbit jde ještě dál. U vícestránkového crawlování nebo plánovaných úloh Thunderbit automaticky střídá user agenty a navíc je kombinuje s různými proxy IP. Když web začne být podezřívavý, Thunderbit se přizpůsobí v reálném čase — přepne UA, upraví hlavičky nebo podle potřeby zpomalí požadavky. Všechno probíhá na pozadí, takže scraping zůstává neodhalený a data dál proudí.
User agent a hlavičky požadavku: síla konzistence
Tady je profi tip: user agent je jen jedna část „otisku“ vašeho požadavku. Moderní anti-bot systémy kontrolují, zda UA odpovídá dalším hlavičkám, jako jsou Accept-Language, Accept-Encoding a Referer. Když tvrdíte, že jste Chrome na Windows, ale z IP v New Yorku posíláte francouzský Accept-Language, je to podezřelé (ScraperAPI).
Best practice:
- Vždy posílejte kompletní sadu hlaviček, které odpovídají vašemu user agentu.
- Udržujte Accept-Language a Accept-Encoding v souladu s UA a pokud možno i s geolokací IP.
- Pomocí nástrojů pro vývojáře v prohlížeči si prohlédněte skutečné požadavky a zkopírujte kompletní sadu hlaviček pro vybraný UA.
Thunderbit tohle řeší za vás. Naše AI zajišťuje, že každý požadavek sedí do posledního detailu — user agent, hlavičky i fingerprint prohlížeče. Dostaneš profil požadavku, který vypadá lidsky, aniž bys musel cokoli řešit.
Jakým chybám se vyhnout: co s user agenty rozhodně nedělat
Viděl jsem spoustu scrapingových projektů, které selhaly ze stejných důvodů. Tady jsou největší chyby, kterým se vyhnout:
- Používání výchozích UA z knihoven pro scraping: Řetězce jako
python-requests/2.x,Scrapy/2.9.0neboJava/1.8spouštějí okamžité blokace. - Zastaralé verze prohlížečů: Tvrdíte v roce 2026, že jste Chrome 120? Podezřelé — ten build je starý přes dva roky. Vždy používejte UA z aktuálního stabilního kanálu (v době psaní Chrome 147); seznam starý dvanáct měsíců už je sám o sobě signál bota.
- Nesoulad mezi hlavičkami: Neposílejte Chrome UA s chybějícím nebo nesprávným Accept-Language, Accept-Encoding nebo Client Hints.
- Známé crawler UA: Cokoli s „bot“, „crawler“, „spider“ nebo názvy nástrojů (např. AhrefsBot) je varovný signál.
- Prázdné nebo nesmyslné UA: Někdy projdou, ale často působí podezřele a jsou nespolehlivé.
Rychlý checklist pro bezpečné user agenty:
- Používejte skutečné a aktuální browserové UA (Chrome, Firefox, Safari).
- Střídejte je z většího poolu.
- Udržujte hlavičky konzistentní s UA.
- Aktualizujte seznam UA každý měsíc (prohlížeče se mění rychle).
- Vyhněte se čemukoli, co křičí „automatizace“.
Thunderbit v praxi: reálné scénáře pro obchod a provoz
Pojďme si to ukázat prakticky. Takhle správa user agentů v Thunderbit pomáhá skutečným týmům:
| Případ použití | Starý způsob: ruční scraping | S Thunderbit | Výsledek |
|---|---|---|---|
| Sales lead generation | Časté blokace, chybějící data | AI vybere nejlepší UA, rotuje je a napodobuje skutečné prohlížení | Více leadů, vyšší kvalita, méně odrazů |
| Monitoring e-commerce | Skript padá, IP bannery | Cloudové scrapování s dynamickou rotací UA a proxy | Spolehlivé sledování cen a skladovosti |
| Realitní nabídky | Únavné úpravy, blokace | AI přizpůsobí UA/hlavičky, automaticky zpracuje podstránky | Kompletní a aktuální seznam nemovitostí |

Jeden obchodní tým používal Thunderbit ke scrapování tisíců webů pro leady a dosáhl jen asi 8% bounce rate u e-mailů — oproti 15–20 % u nakoupených seznamů (Reddit). To je síla čerstvého scrapingu, který se chová jako člověk.
Krok za krokem: jak scrapovat s nejlepším user agentem pomocí Thunderbit
Takto snadno můžeš začít s Thunderbit — bez technických znalostí:
- Nainstalujte si rozšíření Thunderbit pro Chrome.
- Otevřete cílový web. Pokud je potřeba, přihlaste se — Thunderbit funguje i na stránkách za loginem.
- Klikněte na „One Click Extract“. AI v Thunderbit projde stránku a navrhne nejlepší sloupce ke scrapování.
- Zkontrolujte a upravte pole, pokud chcete. Přejmenujte, přidejte nebo smažte sloupce podle potřeby.
- Klikněte na „Scrape“. Thunderbit vytáhne data a na pozadí bude rotovat user agenty i hlavičky.
- Exportujte data. Pošlete je rovnou do Excelu, Google Sheets, Airtable nebo Notion, případně stáhněte jako CSV/JSON.
Nemusíte vybírat ani aktualizovat user agenty — AI v Thunderbit to zvládne celé sama a přizpůsobí se každému webu pro maximální úspěšnost.
Scrape s rotací user agentů poháněnou AI Thunderbit spouští scrapingové úlohy přes vlastní infrastrukturu, takže jedno kliknutí nahradí ruční skripty pro rotaci user agentů. Get Started Free
Thunderbit vs. tradiční správa user agentů
Podívejme se, jak si Thunderbit stojí vedle starého, ručního přístupu:
| Funkce / úkol | Ruční přístup ke scrapingu | Přístup Thunderbit |
|---|---|---|
| Nastavení user agenta | Ruční výzkum a nastavení v kódu | Automatické, AI vybere podle webu |
| Udržování aktuálních UA | Ruční, snadno se zapomene | AI se automaticky přizpůsobuje trendům prohlížečů |
| Rotace UA | Vlastní logika v kódu | Vestavěná, inteligentní rotace |
| Konzistence hlaviček | Ruční párování hlaviček s UA | AI zajistí kompletní a konzistentní sadu hlaviček |
| Řešení blokací/CAPTCHA | Ruční přepínání, vysoká údržba | AI se přizpůsobí, zkusí znovu a rotuje podle potřeby |
| Potřebné technické znalosti | Vysoké (programování, HTTP) | Žádné — navrženo pro firemní uživatele |
| Čas strávený laděním | Častý a frustrující | Minimum — soustředíte se na data, ne na problémy scrapingu |
Thunderbit je určen pro každého, kdo chce spolehlivý a škálovatelný scraping — bez technické zátěže.
Podívejte se, jak funguje agentic web scraping AI v Thunderbit čte stránku podobně jako člověk a jedním kliknutím z ní vytáhne data, takže odpadá ruční ladění scraperu. Get Started Free
Hlavní závěry: jak si postavit strategii user agentů odolnou do budoucna
Tady je to, co jsem se o správě user agentů v roce 2026 naučil — někdy i dost bolestivě:
- Nikdy nepoužívejte výchozí nebo zastaralé user agenty. Jsou hlavním důvodem, proč se scrapery blokují.
- Dynamicky rotujte user agenty. Rozmanitost je váš přítel — nenechte scraper vypadat jako průvod robotů.
- Udržujte hlavičky konzistentní a realistické. Váš user agent je tak dobrý, jak dobrá je společnost, ve které je.
- Buďte v obraze. Verze prohlížečů se mění rychle; měl by se měnit i váš seznam UA.
- Nechte těžkou práci na AI. Nástroje jako Thunderbit mají best practices zabudované, takže se můžete soustředit na výsledky, ne na požadavky.
Jestli vás už nebaví blokace, ladění skriptů nebo prostě chcete scrapovat jako profík bez zbytečných komplikací, vyzkoušejte Thunderbit. Náš agentic web scraper používají tisíce uživatelů po celém světě a je navržen tak, aby zpřístupnil webová data všem — bez technických bolestí hlavy.
Další tipy, návody a detailní rozbory web scrapingu najdete na blogu Thunderbit.
Často kladené otázky
1. Co je user agent a proč je pro web scraping důležitý?
User agent je řetězec, který se posílá s každým webovým požadavkem a identifikuje váš prohlížeč i operační systém. Weby ho používají k zobrazování správného obsahu a k odhalování botů. Správně zvolený user agent pomáhá scraperu splynout s provozem a vyhnout se blokacím.
2. Proč nepoužívat výchozí user agent ze scrapingové knihovny?
Výchozí user agenty jako python-requests/2.x jsou známé botí podpisy a weby je často blokují okamžitě. Vždy používejte realistické a aktuální browserové user agenty.
3. Jak Thunderbit řeší rotaci user agentů?
AI v Thunderbit automaticky střídá sadu aktuálních a realistických browserových user agentů pro každý požadavek nebo relaci. Díky tomu scraping vypadá jako skutečný, různorodý provoz od uživatelů.
4. Musím v Thunderbit ručně nastavovat hlavičky jako Accept-Language nebo Referer?
Ne! AI v Thunderbit zajišťuje, že všechny hlavičky jsou konzistentní a odpovídají user agentu, takže vaše požadavky vypadají i fungují jako skutečný prohlížeč.
5. Co když web začne moje požadavky stejně blokovat?
Thunderbit odhalí blokace nebo CAPTCHA a přizpůsobí se v reálném čase — přepne user agenty, upraví hlavičky nebo podle potřeby zkusí požadavek znovu. Získáte spolehlivá data bez ručního ladění.
Připraveni scrapovat chytřeji? Stáhněte si Thunderbit a nechte naši AI vyřešit hru na kočku a myš s user agenty za vás. Příjemné scrapování!
Další informace
- Co jsou AI agenti? Jak fungují a jak je používat
- Co je Manus AI Agent? Jak funguje a jak ho používat
- Průvodce pro začátečníky: Jak krok za krokem vytvořit AI agenta
- Průvodce vertikálními AI agenty: koncepty a reálné případy použití
- Porozumění statistikám AI agentů: od přesnosti po škálovatelnost
Vyzkoušejte agentic web scraper Get Started Free



