
Rozbité odkazy. Opuštěné stránky. Testovací stránka z roku 2019, kterou Google z nějakého důvodu zaindexoval. Pokud spravuješ web, tenhle problém dobře znáš.
Dobrý crawler tohle všechno odhalí — a navíc ti zmapuje celý web, takže přesně víš, co je potřeba opravit. Jenže většina lidí si plete „web crawler“ s „web scraperem“. Není to totéž.
Otestoval jsem 10 bezplatných crawlerů na reálných webech. Některé jsou skvělé pro SEO audity. Jiné jsou lepší na získávání dat. Tady je, co fungovalo — a co ne.
Co je web crawler? Základy bez zbytečných zmatků
Hned na začátek si ujasněme jednu věc: website crawler není to samé jako web scraper. Vím, ty pojmy se hází sem a tam jak těsto na pizzu, ale ve skutečnosti znamenají něco dost jiného. Crawler si představ jako kartografa tvého webu — prochází každý kout, sleduje každý odkaz a skládá mapu všech stránek. Jeho úkolem je objevování: najít URL adresy, zmapovat strukturu webu a zaindexovat obsah. Přesně to dělají vyhledávače jako Google pomocí svých botů a také SEO nástroje, které kontrolují technický stav webu (Thunderbit Blog: Co je web crawler?).
Web scraper je naopak datový těžař. Nezajímá ho celá mapa — chce jen vytěžit zlato: ceny produktů, názvy firem, recenze, e-maily, cokoli tě napadne. Scraper z těch stránek, které crawler našel, vytahuje konkrétní údaje (Thunderbit Blog: Jak crawlovat web?).
Přirovnání:
- Crawler: člověk, který projde všechny uličky v supermarketu a sepíše inventář všech produktů.
- Scraper: člověk, který jde rovnou k regálu s kávou a zapisuje ceny všech bio směsí.
Proč na tom záleží? Pokud jen potřebuješ najít všechny stránky na webu (třeba pro SEO audit), potřebuješ crawler. Pokud chceš stáhnout všechny ceny produktů z konkurenčního webu, potřebuješ scraper — nebo ideálně nástroj, který zvládne obojí.
Proč používat online web crawler? Hlavní přínosy pro firmu
Tak proč vlastně crawler řešit? Web se rozhodně nezmenšuje. Naopak, více než 54 % značek na enterprise úrovni používá specializované crawling platformy k optimalizaci svých webů a některé SEO nástroje denně crawlí 7 miliard stránek.
Crawler ti pomůže hlavně s tímto:
- SEO audity: najde rozbité odkazy, chybějící titulky, duplicitní obsah, opuštěné stránky a další problémy (SEO.ai).
- Kontrola odkazů a QA: zachytí 404 chyby a nekonečné přesměrovací smyčky dřív, než je objeví uživatelé (Screaming Frog).
- Generování sitemap: automaticky vytvoří XML sitemapu pro vyhledávače i plánování (PowerMapper).
- Inventář obsahu: sestaví seznam všech stránek, jejich hierarchie a metadat.
- Compliance a přístupnost: zkontroluje každou stránku z pohledu WCAG, SEO i právní shody (SiteOne Crawler).
- Výkon a bezpečnost: označí pomalé stránky, příliš velké obrázky nebo bezpečnostní problémy (SiteOne Crawler).
- Data pro AI a analytiku: předá crawlovaná data do analytických nebo AI nástrojů (Thunderbit Blog: Recenze Crawl4AI).
Tady je rychlá tabulka, která propojuje typy použití s rolí ve firmě:
| Případ použití | Pro koho je ideální | Přínos / výsledek |
|---|---|---|
| SEO a audit webu | Marketing, SEO, majitelé malých firem | Odhalení technických problémů, lepší struktura, vyšší pozice ve vyhledávání |
| Inventář obsahu a QA | Content manageři, webmasteři | Audit nebo migrace obsahu, odhalení rozbitých odkazů a obrázků |
| Generování leadů (scraping) | Obchod, business development | Automatizace prospectingu, čerstvé leady v CRM |
| Konkurenceschopná analýza | E-commerce, produktoví manažeři | Sledování cen konkurence, nových produktů a změn skladové dostupnosti |
| Klonování sitemap a struktury | Vývojáři, DevOps, konzultanti | Replikace struktury webu pro redesign nebo zálohu |
| Agregace obsahu | Výzkumníci, média, analytici | Sběr dat z více webů pro analýzu nebo sledování trendů |
| Průzkum trhu | Analytici, týmy pro AI trénink | Sběr velkých datových sad pro analýzu nebo trénink AI modelů |
(Thunderbit Blog: Jak crawlovat web?)
Jak jsme vybírali nejlepší bezplatné web crawler nástroje
Strávil jsem spoustu nočních hodin (a vypil víc kávy, než bych chtěl přiznat) procházením crawler nástrojů, čtením dokumentace a spouštěním testovacích crawlů. Tohle jsem sledoval:
- Technické schopnosti: Zvládne moderní weby (JavaScript, přihlášení, dynamický obsah)?
- Snadnost použití: Je přívětivý pro netechnické uživatele, nebo vyžaduje programátorské kouzlení v terminálu?
- Limity bezplatného plánu: Je opravdu zdarma, nebo je to jen ochutnávka?
- Online dostupnost: Jde o cloudový nástroj, desktopovou aplikaci, nebo knihovnu v kódu?
- Unikátní funkce: Umí něco navíc — třeba AI extrakci, vizuální sitemapu nebo událostmi řízené crawlování?
Každý nástroj jsem vyzkoušel, prošel jsem zpětnou vazbu uživatelů a porovnal funkce vedle sebe. Když mě nějaký nástroj nutil chtít vyhodit notebook z okna, do výběru se nedostal.
Rychlé srovnání: 10 nejlepších bezplatných web crawlerů na první pohled
| Nástroj a typ | Hlavní funkce | Nejlepší použití | Technické nároky | Podrobnosti bezplatného plánu |
|---|---|---|---|---|
| Bright Data (Cloud/API) | Enterprise crawling, proxy, renderování JS, řešení CAPTCHA | Sběr dat ve velkém měřítku | Hodí se základní technická zdatnost | Free tier: 5 000 záznamů měsíčně v Web Scraper API, bez platební karty |
| Crawlbase (Cloud/API) | API crawling, anti-bot ochrana, proxy, renderování JS | Vývojáři, kteří potřebují backend infrastrukturu pro crawling | Integrace přes API | Zdarma: až 20 000 požadavků na začátek, bez platební karty; poté platba za požadavek |
| ScraperAPI (Cloud/API) | Rotace proxy, renderování JS, asynchronní crawl, předpřipravené endpointy | Vývojáři, sledování cen, SEO data | Minimální nastavení | Zdarma: 5 000 API volání na 7 dní, poté 1 000 měsíčně |
| Diffbot Crawlbot (Cloud) | AI crawl + extrakce, knowledge graph, renderování JS | Strukturovaná data ve velkém, AI/ML | Integrace přes API | Zdarma: 10 000 kreditů měsíčně pro extrakční API; Crawl vyžaduje Plus tarif |
| Screaming Frog (Desktop) | SEO audit, analýza odkazů/metadat, sitemapa, vlastní extrakce | SEO audity, správci webů | Desktopová aplikace, GUI | Zdarma: 500 URL na crawl, jen základní funkce |
| SiteOne Crawler (Desktop) | SEO, výkon, přístupnost, bezpečnost, offline export, Markdown | Vývojáři, QA, migrace, dokumentace | Desktop/CLI, GUI | Zdarma a open-source, v GUI reportu 1 000 URL (konfigurovatelné) |
| Crawljax (Java, OpenSrc) | Crawl řízený událostmi pro weby s velkým podílem JS, statický export | Vývojáři, QA pro dynamické webové aplikace | Java, CLI/konfigurace | Zdarma a open-source, bez limitů |
| Apache Nutch (Java, OpenSrc) | Distribuované crawlování, pluginová architektura, integrace s Hadoopem, vlastní vyhledávání | Vlastní vyhledávače, crawl ve velkém měřítku | Java, příkazová řádka | Zdarma a open-source, platíte jen infrastrukturu |
| YaCy (Java, OpenSrc) | Peer-to-peer crawl a vyhledávání, soukromí, indexace webu/intranetu | Privátní vyhledávání, decentralizace | Java, webové rozhraní | Zdarma a open-source, bez limitů |
| PowerMapper (Desktop/SaaS) | Vizuální sitemapa, přístupnost, QA, kompatibilita v prohlížečích | Agentury, QA, vizuální mapování | GUI, snadné použití | Zkušební verze zdarma: 30 dní, 100 stránek (desktop) nebo 10 stránek (online) na sken |
Ještě jedna poznámka, než budete scrollovat dál: „zdarma“ v posledním sloupci znamená několik dost odlišných věcí. SiteOne, Crawljax, Nutch a YaCy jsou open source — zdarma bez limitu, pokud máš vlastní hardware. Screaming Frog je zdarma navždy, ale omezený na 500 URL na jeden crawl. Bright Data, ScraperAPI a Diffbot nabízejí skutečné free plány, ale jsou malé a u Diffbotu navíc free plán nepokrývá přímo crawler část. Crawlbase dá na začátek jeden blok volných requestů a pak účtuje za každý další. PowerMapper je v seznamu jedině jako čistá zkušební verze — po 30 dnech je potřeba zaplatit.
Bright Data: cloudový web crawler pro enterprise úroveň
Bright Data je „těžká váha“ mezi web crawlery. Jde o cloudovou platformu s rozsáhlou proxy sítí, renderováním JavaScriptu, řešením CAPTCHA a IDE pro vlastní crawl scénáře. Pokud děláš sběr dat ve velkém — třeba monitoruješ stovky e-shopů kvůli cenám — infrastruktura Bright Data se těžko překonává (aimultiple.com).
Silné stránky:
- Zvládá náročné weby s anti-bot ochranou
- Dobře škáluje pro enterprise potřeby
- Předpřipravené шаблоны pro běžné weby
Omezení:
- Free tier existuje, ale je malý: 5 000 záznamů měsíčně v Web Scraper API
- Na jednoduché audity je to často zbytečně robustní řešení
- Pro netechnické uživatele může být složitější na naučení
Pokud potřebuješ crawlovat web ve velkém, Bright Data je jako pronajmout si formulový vůz. Bezplatných 5 000 záznamů měsíčně ti umožní projet se po bloku; pak už platíš podle použití (Bright Data Pricing).
Crawlbase: API crawler pro vývojáře zdarma a bez zbytečné práce
Crawlbase (dříve ProxyCrawl) je hlavně o programatickém crawlování. Pošleš URL přes API a vrátí ti HTML — v pozadí se postará o proxy, geo-targeting i CAPTCHA (Capterra).
Silné stránky:
- Velmi vysoká úspěšnost (99 %+)
- Zvládá weby s hodně JavaScriptem
- Skvělé pro integraci do vlastních aplikací nebo workflow
Omezení:
- Vyžaduje práci s API nebo SDK
- Free plán: až 20 000 requestů na rozjezd (bez platební karty), pak platba za request
Jestli jsi vývojář a chceš crawlovat (a možná i scrapovat) ve velkém bez správy proxy, Crawlbase je velmi solidní volba (Crawlbase Pricing).
ScraperAPI: jednodušší cesta k dynamickému web crawlování
ScraperAPI je API ve stylu „prostě mi to stáhni“. Pošleš mu URL, ono obslouží proxy, headless prohlížeče i anti-bot ochranu a vrátí HTML (u některých webů i strukturovaná data). Je obzvlášť dobré pro dynamické stránky, i když ta „zdarma“ část je spíš skromná: 5 000 API kreditů na prvních 7 dní, bez nutnosti karty, a pak 1 000 kreditů měsíčně v průběžném free plánu (ScraperAPI Pricing).
Silné stránky:
- Pro vývojáře extrémně jednoduché použití (stačí API volání)
- Zvládá CAPTCHA, blokace IP i JavaScript
- Zdarma: 5 000 API volání na 7 dní, potom 1 000/měsíc
Omezení:
- Bez vizuálních crawl reportů
- Pokud chceš následovat odkazy, budeš si muset napsat logiku crawlů sám
Pokud chceš web crawling napojit do kódu během pár minut, ScraperAPI dává smysl hned od začátku.
Diffbot Crawlbot: automatizované objevování struktury webu
Diffbot Crawlbot je místo, kde se věci začínají dít chytře. Nejenže crawlí — pomocí AI stránky klasifikuje a extrahuje strukturovaná data (články, produkty, události atd.) do JSONu. Je to jako mít robotického stážistu, který skutečně rozumí tomu, co čte (Diffbot Free Plan).
Silné stránky:
- AI řízená extrakce, ne jen samotné crawlování
- Zvládá JavaScript a dynamický obsah
- Zdarma: 10 000 kreditů měsíčně, bez platební karty, pro Extract, Natural Language, Knowledge Graph a Search
Omezení:
- Zaměřeno na vývojáře (integrace přes API)
- Není to vizuální SEO nástroj — spíš pro datové projekty
- Samotný Crawlbot, tedy část, která prochází celý web, je až v Plus plánu; free kredity pokrývají extrakční API (Diffbot Pricing)
Pokud potřebuješ strukturovaná data ve velkém, hlavně pro AI nebo analytiku, Diffbot je skutečný tahoun.
Screaming Frog: bezplatný desktop SEO crawler
Screaming Frog je klasika mezi desktop crawler nástroji pro SEO audity. Ve free verzi prochází až 500 URL na jeden scan a nabídne prakticky vše: rozbité odkazy, meta tagy, duplicitní obsah, sitemapu a další (Screaming Frog User Guide).
Silné stránky:
- Rychlý, důkladný a v SEO světě důvěryhodný
- Bez programování — zadáš URL a jedeš
- Zdarma až do 500 URL na crawl
Omezení:
- Jen desktopová aplikace, žádná cloudová verze
- Pokročilé funkce (renderování JS, plánování) vyžadují placenou licenci
Pokud to s SEO myslíš vážně, Screaming Frog je skoro povinnost — jen nečekej, že bez placené verze proleze tvůj desetitisícový web.
SiteOne Crawler: export statického webu a dokumentace
SiteOne Crawler je švýcarský armádní nůž pro technické audity. Je open source, funguje napříč platformami a umí web nejen crawlit a auditovat, ale i exportovat do Markdownu pro dokumentaci nebo offline použití (SiteOne Crawler).
Silné stránky:
- Pokrývá SEO, výkon, přístupnost i bezpečnost
- Umí export webu pro archivaci nebo migraci
- Zdarma a open-source, bez limitů použití
Omezení:
- Technicky náročnější než některé GUI nástroje
- Auditní report v GUI je ve výchozím nastavení omezen na 1 000 URL (lze upravit)
Pokud jsi vývojář, QA nebo konzultant a chceš hlubší vhled (a zároveň máš rád open source), SiteOne je skrytý poklad.
Crawljax: open-source Java crawler pro dynamické stránky
Crawljax je specialista: je navržený pro crawl moderních webových aplikací s vysokým podílem JavaScriptu a simuluje uživatelské interakce (klikání, vyplňování formulářů atd.). Je řízený událostmi a dokáže dokonce vyexportovat statickou verzi dynamického webu (Wikipedia: Crawljax).
Silné stránky:
- Skvělý pro SPA a weby s AJAXem
- Open-source a rozšiřitelný
- Bez limitů použití
Omezení:
- Vyžaduje Javu a trochu programování/konfigurace
- Není vhodný pro netechnické uživatele
Pokud potřebuješ crawlit React nebo Angular aplikaci tak, jak by ji používal skutečný člověk, Crawljax je tvůj parťák.
Apache Nutch: škálovatelný distribuovaný web crawler
Apache Nutch je děda všech open-source crawlerů. Je navržený pro masivní, distribuované crawly — třeba pro stavbu vlastního vyhledávače nebo indexaci milionů stránek (Martechvibe).
Silné stránky:
- S Hadoopem škáluje až na miliardy stránek
- Vysoce konfigurovatelný a rozšiřitelný
- Zdarma a open-source
Omezení:
- Strmá křivka učení (Java, příkazová řádka, konfigurace)
- Není to nástroj pro malé weby ani občasné použití
Pokud chceš crawlit web ve velkém a nevadí ti práce v terminálu, Nutch je přesně pro tebe.
YaCy: peer-to-peer web crawler a vyhledávač
YaCy je unikátní, decentralizovaný crawler a vyhledávač. Každá instance crawlí a indexuje weby a můžeš se připojit do peer-to-peer sítě a sdílet indexy s ostatními (TechRadar: YaCy).
Silné stránky:
- Zaměřeno na soukromí, bez centrálního serveru
- Skvělé pro privátní vyhledávání nebo intranet
- Zdarma a open-source
Omezení:
- Výsledky závisí na pokrytí sítě
- Vyžaduje trochu nastavení (Java, webové rozhraní)
Pokud tě láká decentralizace nebo chceš vlastní vyhledávač, YaCy je hodně zajímavá volba.
PowerMapper: vizuální generátor sitemap pro UX a QA
PowerMapper je hlavně o vizualizaci struktury webu. Crawlí tvůj web, generuje interaktivní sitemapu a navíc kontroluje přístupnost, kompatibilitu v prohlížečích a základní SEO (Slickplan Review).
Silné stránky:
- Vizuální sitemapa je ideální pro agentury a designéry
- Kontroluje přístupnost a compliance
- Jednoduché GUI, není potřeba technická zdatnost
Omezení:
- Jen zkušební verze zdarma (30 dní, 100 stránek desktop / 10 stránek online na scan)
- Plná verze je placená
Pokud potřebuješ ukázat klientovi mapu webu nebo zkontrolovat shodu s pravidly, PowerMapper je praktický pomocník.
Jak vybrat správný bezplatný web crawler podle potřeby
Při tolika možnostech, jak vybrat tu správnou? Tady je můj rychlý průvodce:
- Pro SEO audity: Screaming Frog (menší weby), PowerMapper (vizuálně), SiteOne (hlubší audity)
- Pro dynamické webové aplikace: Crawljax
- Pro velké nebo vlastní vyhledávání: Apache Nutch, YaCy
- Pro vývojáře, kteří potřebují API přístup: Crawlbase, ScraperAPI, Diffbot
- Pro dokumentaci nebo archivaci: SiteOne Crawler
- Pro enterprise použití s malým trvalým free tierem: Bright Data, Diffbot
Hlavní faktory, které zvažte:
- Škálovatelnost: Jak velký je váš web nebo crawling úloha?
- Snadnost použití: Jste v pohodě s kódem, nebo chcete klikací řešení?
- Export dat: Potřebujete CSV, JSON nebo napojení na jiné nástroje?
- Podpora: Existuje komunita nebo dokumentace, když se zaseknete?
Když se web crawling potká s web scrapingem: proč je Thunderbit chytřejší volba
Scrapeujte data z libovolného webu pomocí AI Thunderbitův agentní web scraper přečte jakýkoli web, který potřebujete crawlit, a jedním kliknutím z něj vytáhne strukturovaná data — zdarma na 6 stránek měsíčně. Get Started Free
Realita je taková, že většina lidí necrawlí web jen proto, aby si nakreslila hezkou mapu. Skutečný cíl bývá získat strukturovaná data — ať už jde o produktové nabídky, kontakty nebo inventář obsahu. A právě tady přichází na řadu Thunderbit.
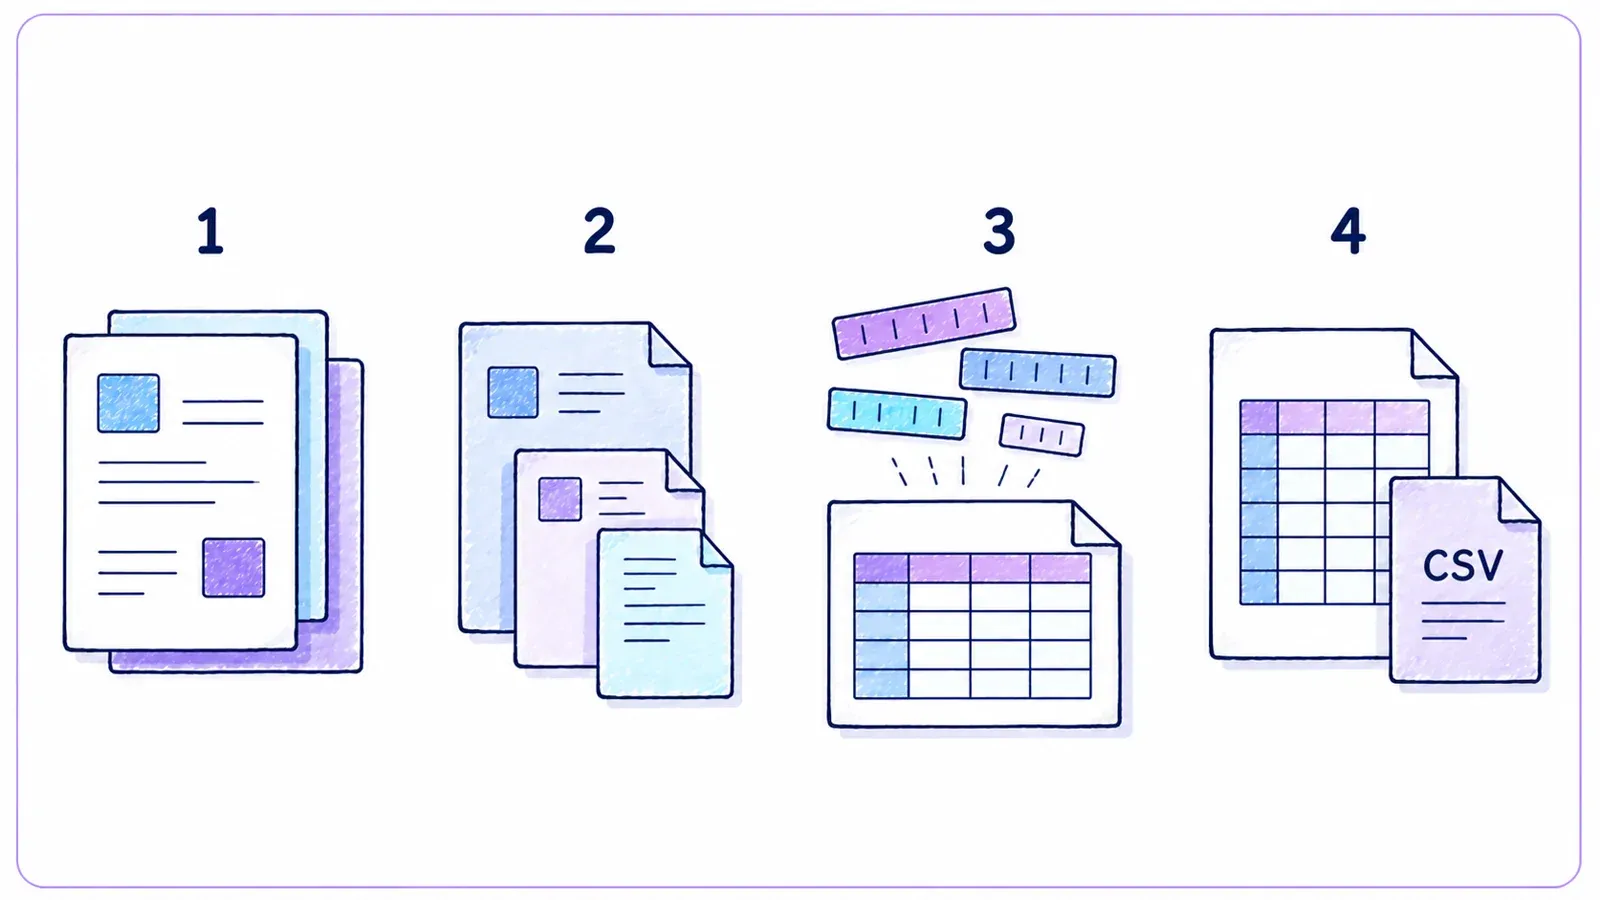
Thunderbit není jen crawler nebo scraper — je to AI poháněné rozšíření pro Chrome, které spojuje obojí. Funguje to takto:
- AI crawler: Thunderbit prochází web podobně jako klasický crawler.
- Waterfall crawling: Pokud se Thunderbitův vlastní engine na stránku nedostane (třeba kvůli silné anti-bot ochraně), automaticky přepne na třetí strany pro crawling — bez ručního nastavování.
- AI strukturování dat: Jakmile získá HTML, AI navrhne správné sloupce a vytáhne strukturovaná data (jména, ceny, e-maily atd.) bez jediného selektoru z vaší strany.
- Scraping podstránek: Potřebujete detailní údaje z každé produktové stránky? Thunderbit může automaticky navštěvovat podstránky a obohatit vaši tabulku.
- Čištění a export dat: Umí data shrnout, kategorizovat, přeložit a na jeden klik exportovat do Excelu, Google Sheets, Airtable nebo Notion.
- Bez nutnosti kódu: Pokud umíte používat prohlížeč, umíte používat i Thunderbit. Žádné programování, žádné proxy, žádné starosti.
Kdy zvolit Thunderbit místo klasického crawleru?
- Když chceš výsledkem čistou, použitelnou tabulku — ne jen seznam URL.
- Když chceš celý proces automatizovat na jednom místě: crawl, extrakci, čištění i export.
- Když si ceníš svého času i nervů.
Thunderbitovo rozšíření pro Chrome si můžeš stáhnout zde a sám uvidíš, proč na něj tolik firemních uživatelů přechází.
Vyzkoušejte Thunderbit zdarma – agentní web scraper Nainstalujte si bezplatné rozšíření pro Chrome a začněte jedním kliknutím crawlovat jakýkoli web, bez nutnosti kódu. Get Started Free
Závěr: jak z bezplatných web crawlerů dostat maximum
Podívejte se, jak funguje agentní web scraping Thunderbit využívá AI, která čte stránku podobně jako člověk a sama rozhodne, co extrahovat, takže není nutné ručně nastavovat crawler. Get Started Free
Webové crawlery ušly obrovský kus cesty. Ať už jsi marketér, vývojář, nebo jen někdo, kdo chce mít svůj web v kondici, existuje pro tebe bezplatný — nebo alespoň zdarma na vyzkoušení — nástroj. Od enterprise platforem jako Bright Data a Diffbot, přes open-source poklady jako SiteOne a Crawljax, až po vizuální mapovače typu PowerMapper, výběr je dnes pestřejší než kdy dřív.
Pokud ale hledáš chytřejší a propojenější způsob, jak se dostat od „potřebuji tahle data“ k „tady je moje tabulka“, vyzkoušej Thunderbit. Je stavěný pro firemní uživatele, kteří chtějí výsledky, ne jen reporty.
Připraven začít crawlovat? Stáhni si nástroj, spusť scan a uvidíš, co ti dosud unikalo. A pokud se chceš dostat od crawlování k použitelným datům jedním kliknutím, podívej se na Thunderbit.
Další praktické návody a hlubší rozbory najdeš na Thunderbit Blogu.
Scrapeujte data z webu pomocí AI jedním kliknutím Nastav Thunderbit tak, aby sledoval podstránky a spouštěl se podle plánu, takže tvoje data zůstanou vždy aktuální bez ručního opakování. Get Started Free
Vyzkoušejte agentní web scraper Get Started Free
FAQ
Jaký je rozdíl mezi web crawlerem a web scraperem?
Crawler objevuje a mapuje všechny stránky na webu (představ si to jako tvorbu obsahu webu). Scraper z těchto stránek vytahuje konkrétní data (například ceny, e-maily nebo recenze). Crawlery hledají, scrapeři těží (Thunderbit Blog: Co je web crawler?).
Který bezplatný web crawler je nejlepší pro netechnické uživatele?
Pro menší weby a SEO audity je uživatelsky přívětivý Screaming Frog. Pro vizuální mapování je skvělý PowerMapper (během zkušební verze). Pokud je tvým cílem strukturovaná data a chceš řešení bez kódu v prohlížeči, nejjednodušší je Thunderbit.
Existují weby, které blokují crawlery?
Ano — některé weby používají robots.txt nebo anti-bot ochranu, jako jsou CAPTCHA nebo blokace IP, aby crawlery zastavily. Nástroje jako ScraperAPI, Crawlbase a Thunderbit (s waterfall crawlingem) si s tím často poradí, ale crawluj vždy zodpovědně a respektuj pravidla webu (Bright Data Pricing).
Mají bezplatné web crawlery limity na počet stránek nebo funkce?
Většinou ano. Například free verze Screaming Frog je omezená na 500 URL na crawl; zkušební verze PowerMapper na 100 stránek. Nástroje postavené na API často mají měsíční limity kreditů. Open-source nástroje jako SiteOne nebo Crawljax obvykle nemají tvrdý limit, ale jsi omezen výkonem svého hardwaru.
Je používání web crawleru legální a v souladu s ochranou soukromí?
Obecně platí, že crawl veřejných webových stránek je legální, ale vždy si zkontroluj podmínky webu a robots.txt. Nikdy necrawluj soukromá nebo heslem chráněná data bez povolení a pokud extrahuješ osobní údaje, dbej na pravidla ochrany soukromí (Crawlbase Guide).



